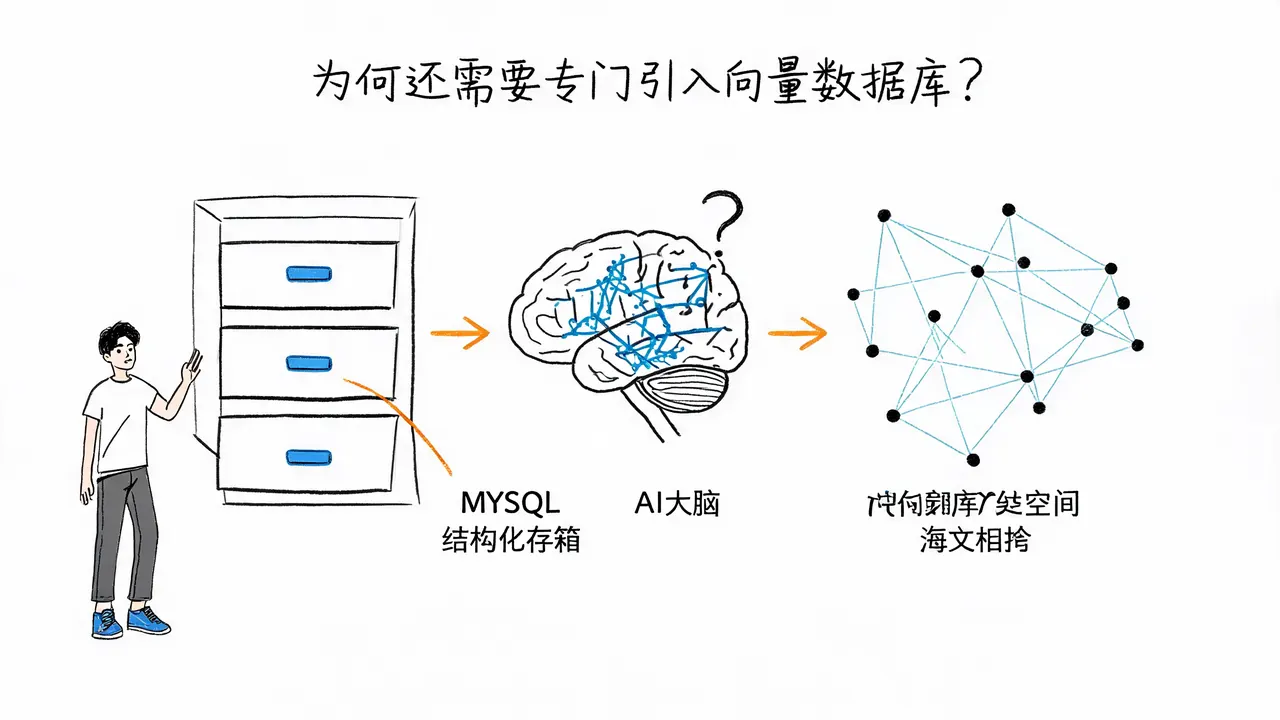
有了MySQL,为什么AI还需要向量数据库?
深入解析MySQL与向量数据库的核心差异。MySQL擅长结构化数据的精确查询,而向量数据库通过Embedding和ANN算法,专为AI时代的语义检索和非结构化数据处理而生。了解两者如何分工协作,构建现代AI应用的数据底座。
共 276 篇文章
深入解析MySQL与向量数据库的核心差异。MySQL擅长结构化数据的精确查询,而向量数据库通过Embedding和ANN算法,专为AI时代的语义检索和非结构化数据处理而生。了解两者如何分工协作,构建现代AI应用的数据底座。
深入解析定时任务与延迟队列的本质区别。通过对比触发机制、执行周期及性能影响,明确两者在订单超时、数据备份等场景下的最佳实践,帮助开发者避开性能坑,选对工具。
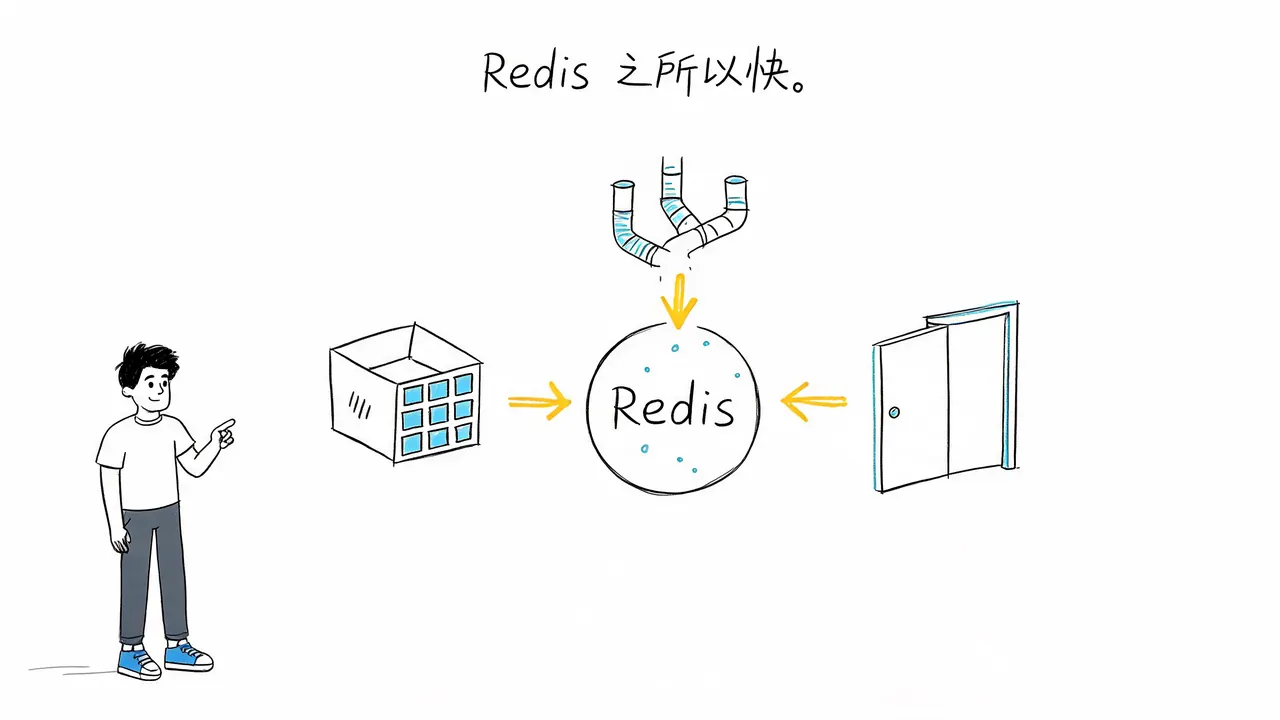
深入解析Redis单线程模型的高性能原理。探讨其如何通过避免锁竞争、利用IO多路复用及内存操作,在特定场景下实现超高吞吐量,并分析其潜在风险与适用边界。
深入解析慢 SQL 如何通过耗尽连接池、榨干 CPU 与磁盘资源、引发锁竞争三大机制拖垮数据库。理解其破坏原理,掌握预防雪崩的关键策略。
深入解析 Sentinel 在微服务架构中的核心作用,厘清限流与熔断的区别与分工,探讨如何防止雪崩效应,保障系统在高并发场景下的稳定性。
解析 Next.js 如何通过 Router Handlers 和 Server Components 打破前后端边界,探讨其适用场景及与传统后端的分工差异。
深入解析网络端口的本质:它并非物理插孔,而是操作系统用于区分不同程序通信通道的逻辑标识。通过快递类比,详解端口分类、工作机制及在网络安全中的关键作用。
本文从底层架构出发,深入拆解 PostgreSQL 与 MySQL 在查询优化器、数据类型支持、MVCC 实现及事务严谨性上的核心差异,探讨为何 PostgreSQL 正成为复杂业务场景下的首选。
深入解析计算机为何采用二进制,探讨0和1如何通过编码规则转化为文字、图像和声音,揭示数字数据背后的逻辑与本质。
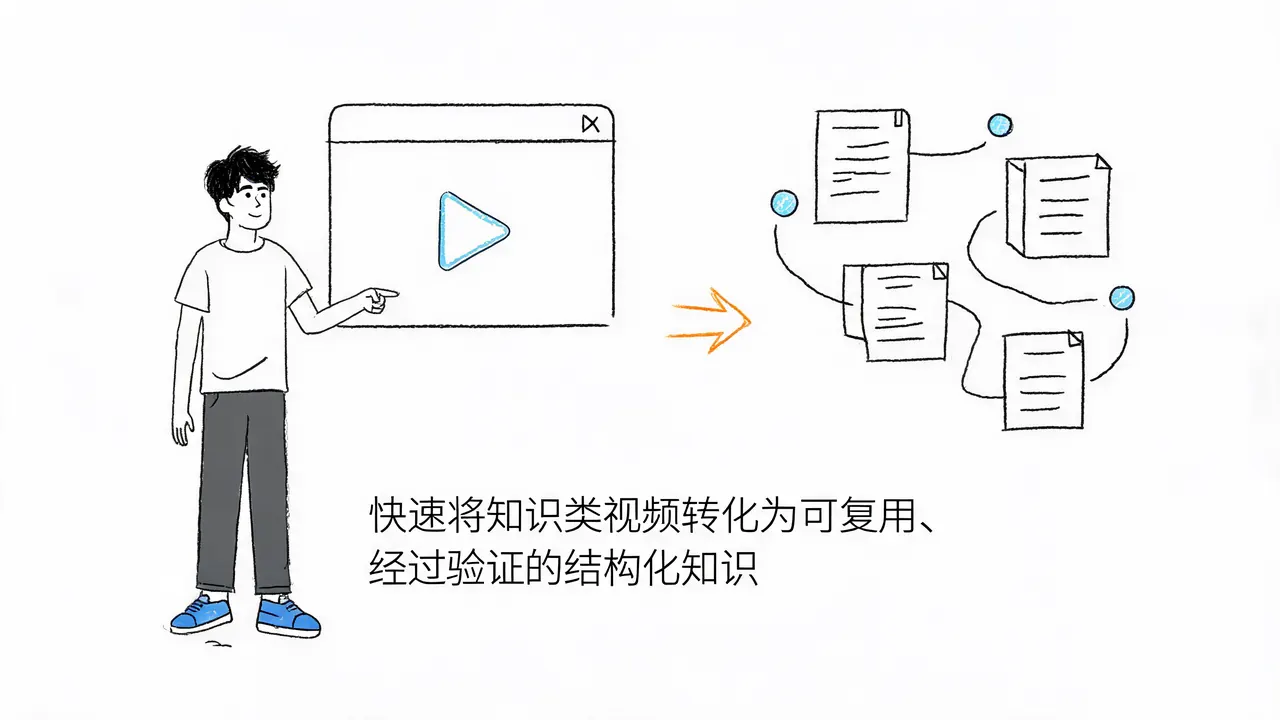
本文介绍如何利用豆包工作(Doubao Work)结合飞书生态,通过视频内容提取、学术文献调研、文档整理及可视化四个核心技能,快速将长视频转化为经过验证的结构化知识体系,提升学习效率。
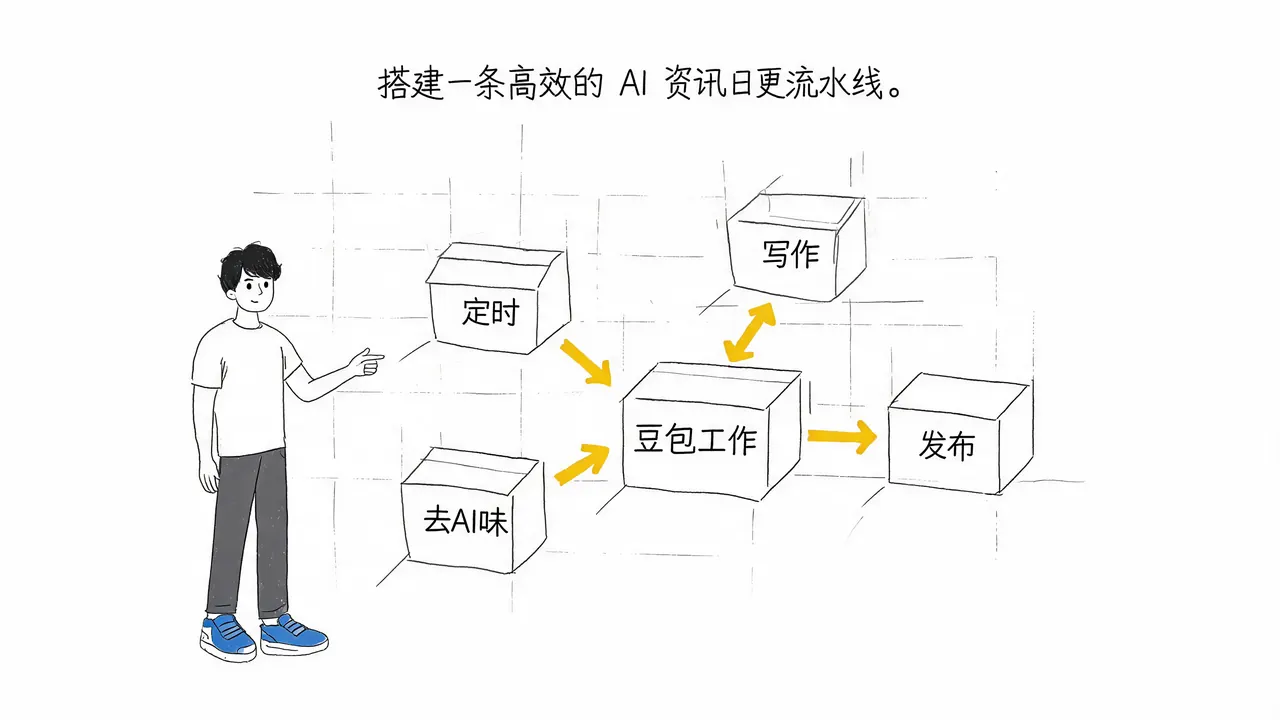
本文介绍如何利用豆包工作(Doubao Work)的 Agent 能力,结合定时任务、新媒体写作及去 AI 味技能,搭建一条全自动的 AI 资讯日更流水线。通过飞书原生打通实现数据闭环,实现从资讯抓取、选题撰写到成品输出的零人工干预,探索 AI 办公从工具时代向 Agent 时代的转变。
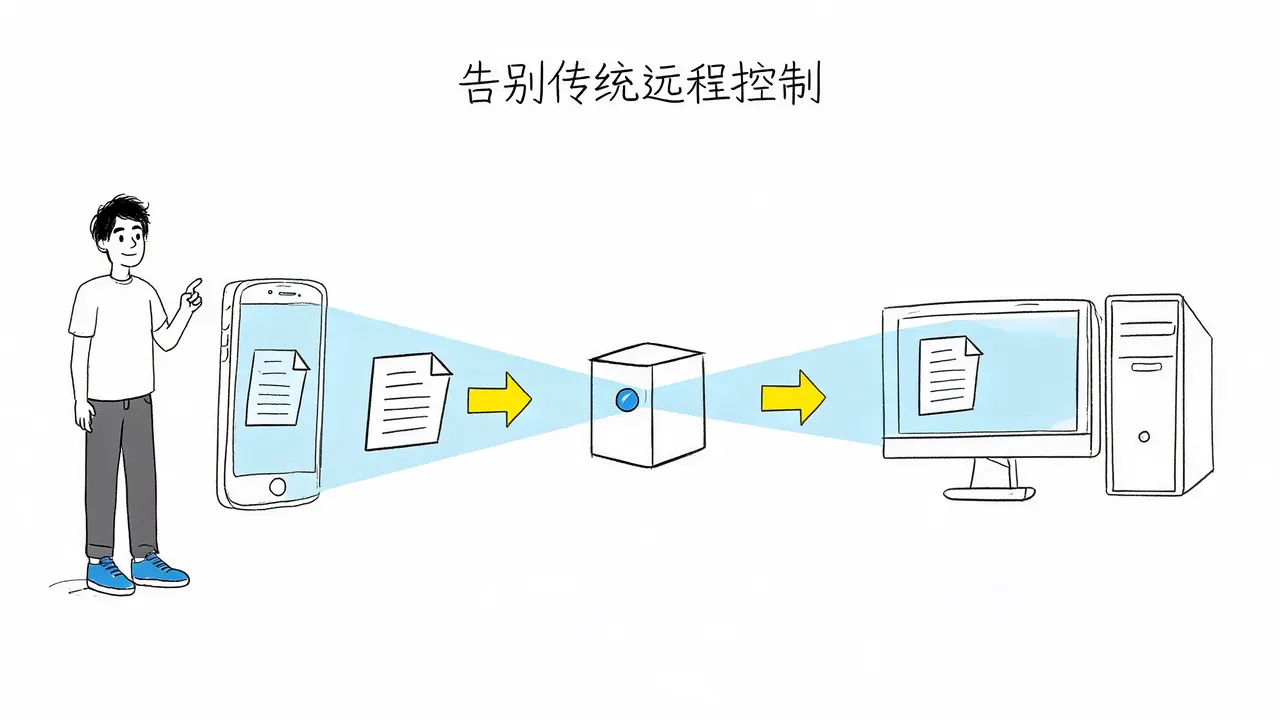
本文实测豆包工作独立端,展示其如何通过 AI 实现跨端文件查找与格式转换。无需传统远程桌面,即可在手机端轻松处理电脑文件,体验更高效的智能工作流。