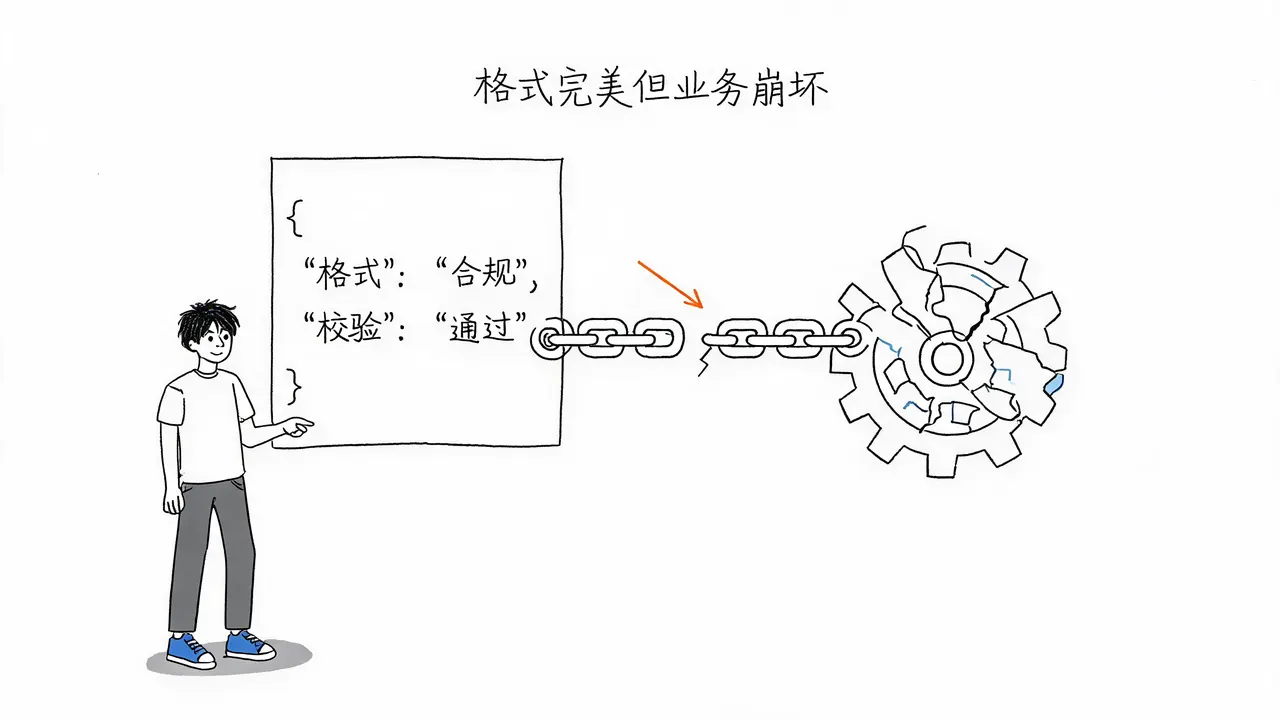
完美JSON直接执行?当心AI工程陷阱:格式正确不等于业务正确
大模型返回格式完美的JSON并不意味着可以直接调用接口执行。本文解析结构化输出的本质,指出其仅解决格式问题而非业务逻辑问题,并介绍“结构化输出+后端校验+用户确认”的安全执行链路,避免AI落地中的隐蔽工程陷阱。
共 276 篇文章
大模型返回格式完美的JSON并不意味着可以直接调用接口执行。本文解析结构化输出的本质,指出其仅解决格式问题而非业务逻辑问题,并介绍“结构化输出+后端校验+用户确认”的安全执行链路,避免AI落地中的隐蔽工程陷阱。
在 AI Agent 工具调用中,简单的重试循环可能导致重复扣款等严重事故。本文深入解析超时重试的工程链路,涵盖错误分类、幂等校验、状态回查、局部补偿及熔断机制,帮助开发者构建安全可控的智能体执行系统。
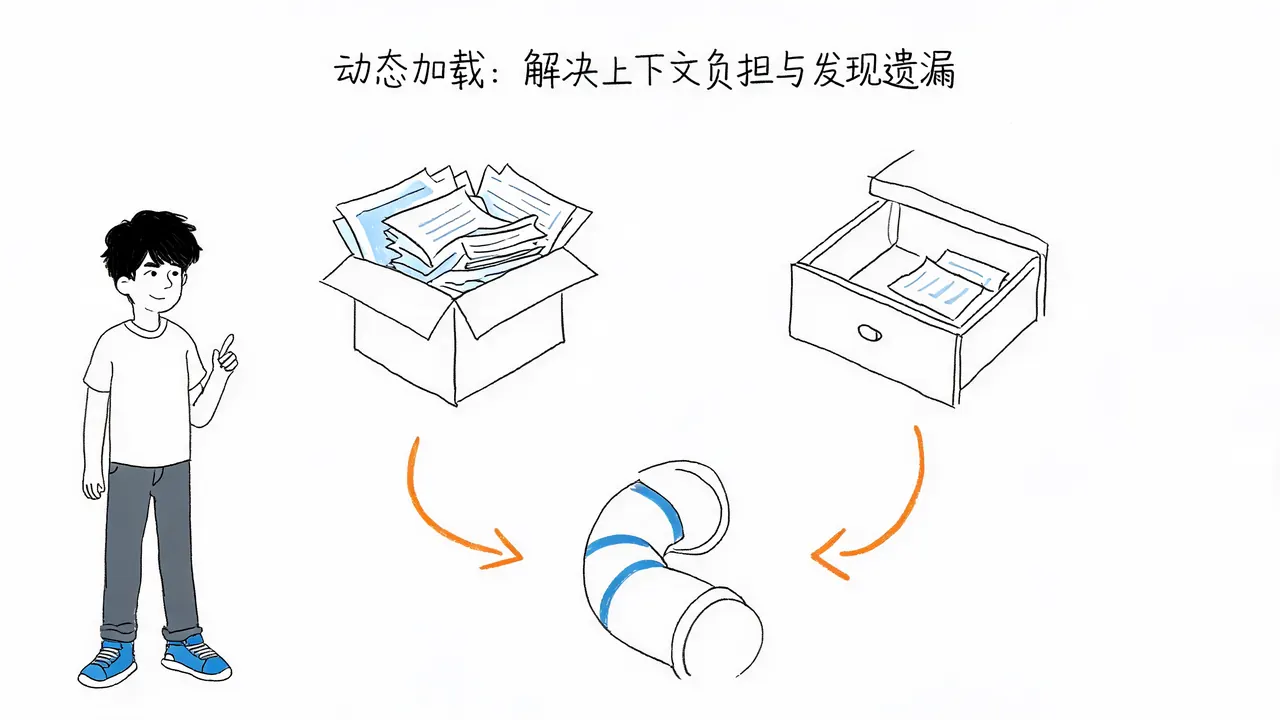
在开发 AI 智能体时,大模型经常选错工具或填错参数,往往是因为 Tool Schema 没写好。本文解析工具动态加载的两层架构,区分发现、选择与调用三类问题,并提供安全与性能优化建议。
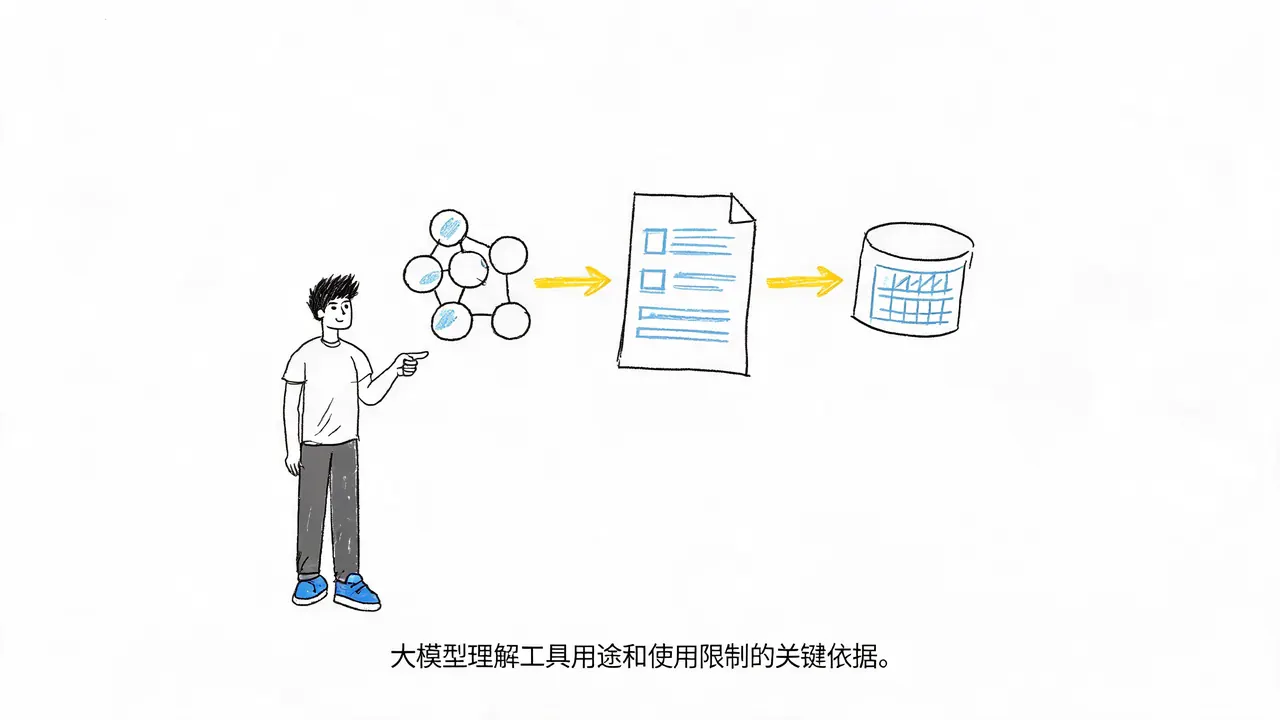
在开发AI智能体时,大模型经常选错工具或填错参数,往往是因为Tool Schema没写好。本文详解如何通过优化工具命名、参数描述及返回结构,提升模型对工具语义的理解,确保智能体稳定调用正确工具。
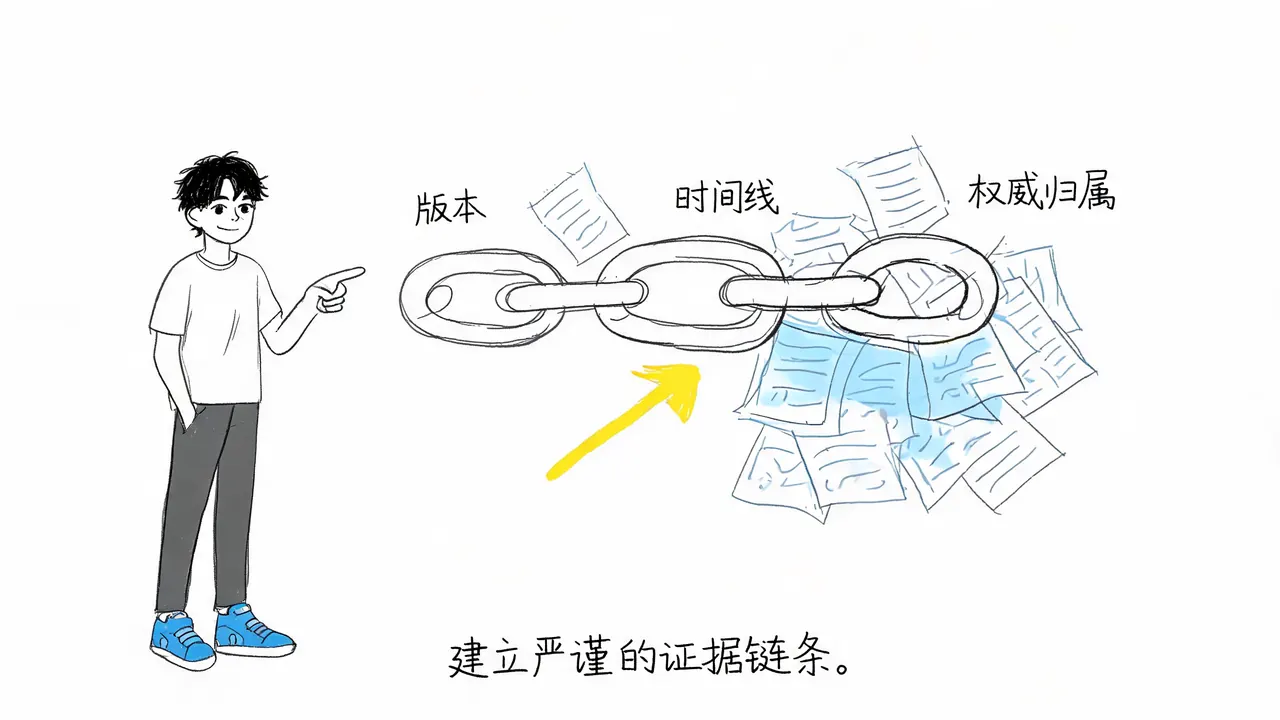
当大模型面对最新文档与过期权威手册的冲突时,往往生成“缝合怪”答案。本文从工程视角拆解检索矛盾处理链路,通过元数据优先级、意图路由及人工介入机制,构建可靠的证据链条。
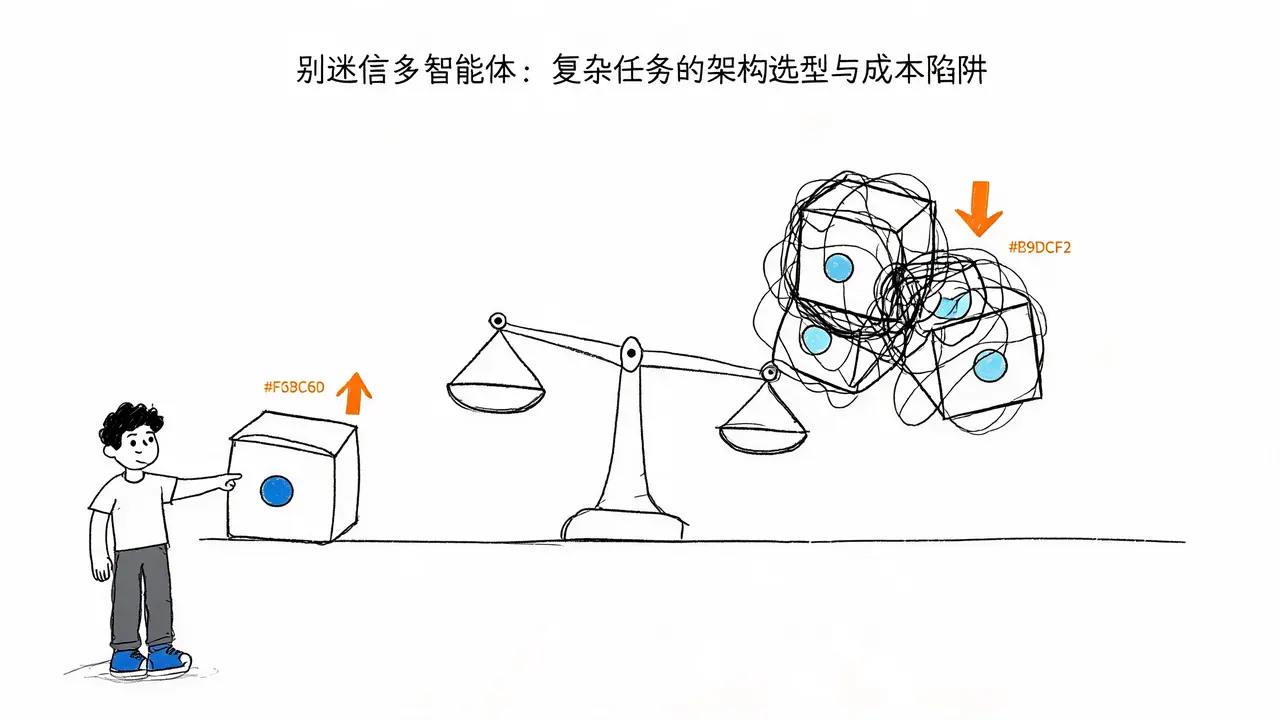
深入解析多智能体架构的适用边界。通过系统日志分析,揭示为何强行拆分深度串联任务会导致系统变慢和 Token 消耗剧增,并给出基于耗时、成本和通信日志的选型决策指南。
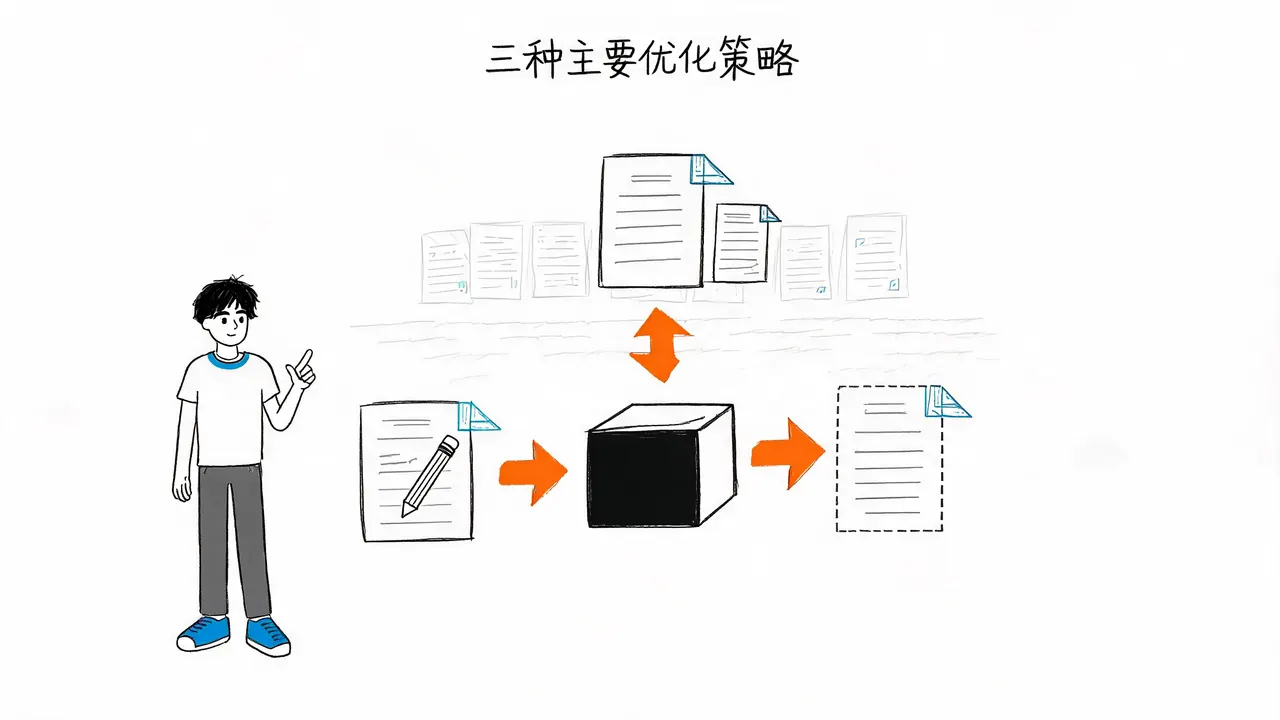
在使用大模型时遇到检索不准的问题?本文深入解析查询改写、拆分子问题和 HyDE 三种常见的检索优化策略,探讨它们各自解决的缺口、适用场景及潜在风险,帮助开发者根据实际需求选择合适的优化方案。
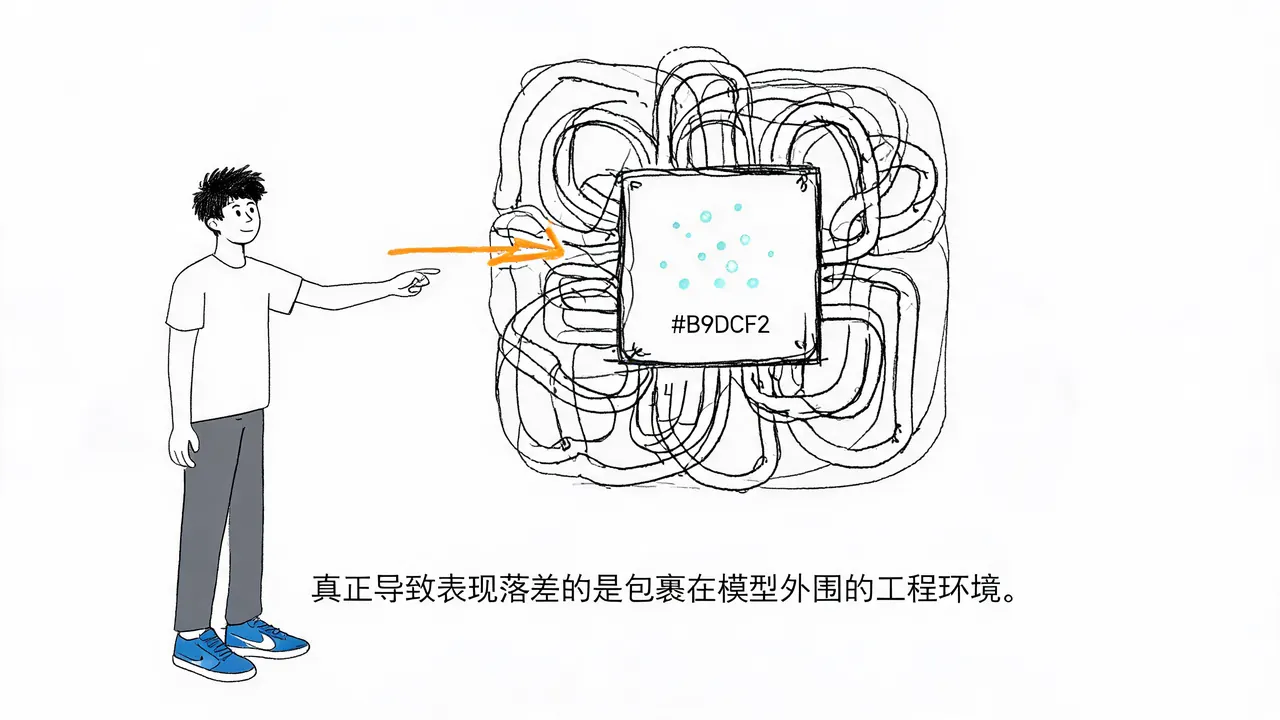
为什么 AI 模型在测试环境表现优异,上线后却频繁出错?本文深入解析 Harness Engineering(工程外壳)的概念,揭示上下文装配、工具管理及错误处理对 Agent 表现的关键影响,并提供基于运行链路的系统性排查策略。
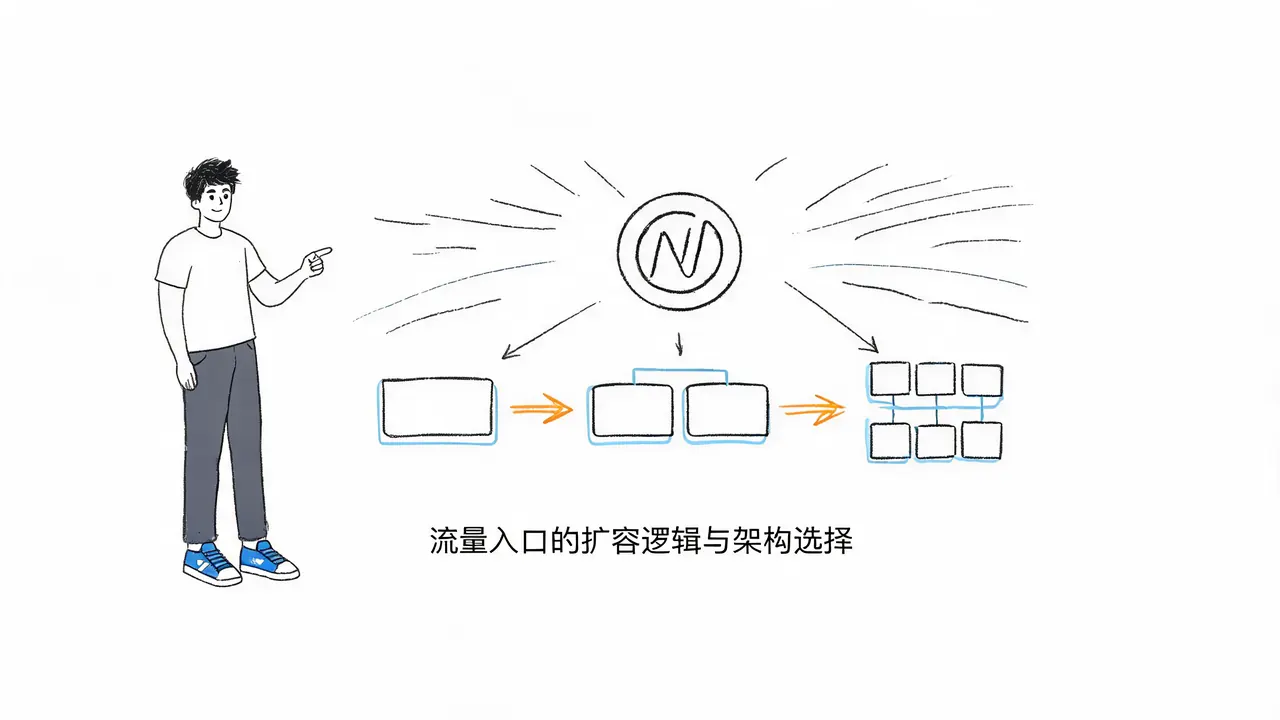
解析Nginx单机的物理边界与瓶颈,探讨从主备高可用到LVS集群的演进路径,并指出避免过度设计的架构原则。
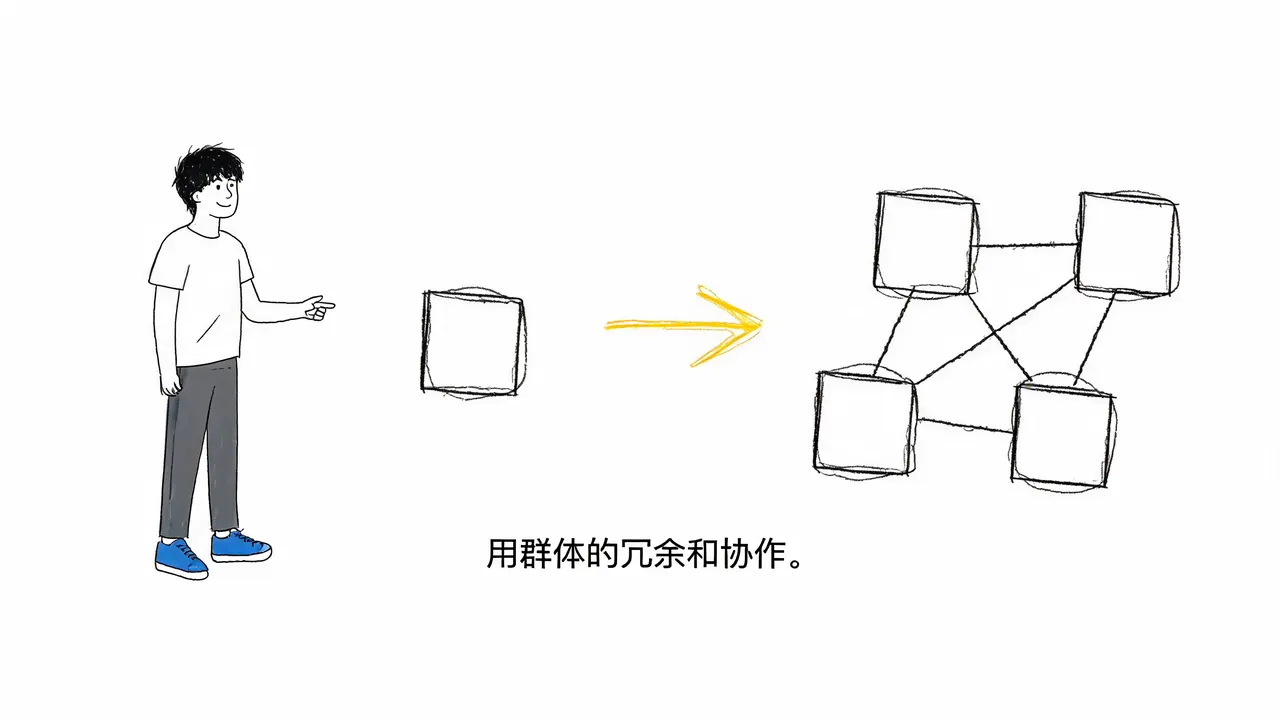
单机Kafka虽具备百万级吞吐量,但在面对海量数据存储、单点故障风险及高并发读写时存在物理极限。本文深入解析Kafka集群如何通过分区、副本机制及水平扩展打破单机瓶颈,实现高可用与高性能。
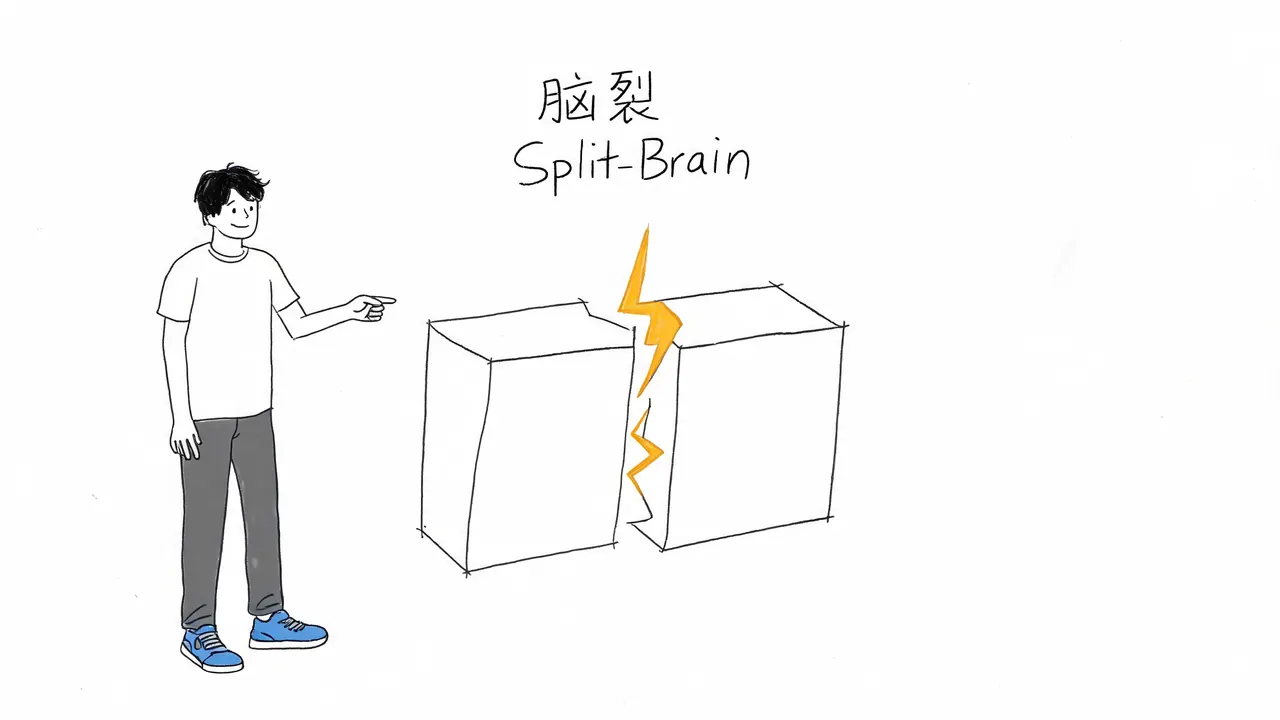
深入解析Redis脑裂现象:从网络隔离到哨兵误判,揭示双主共存导致数据丢失的根本原因,并探讨最小从节点写入限制等防御机制。
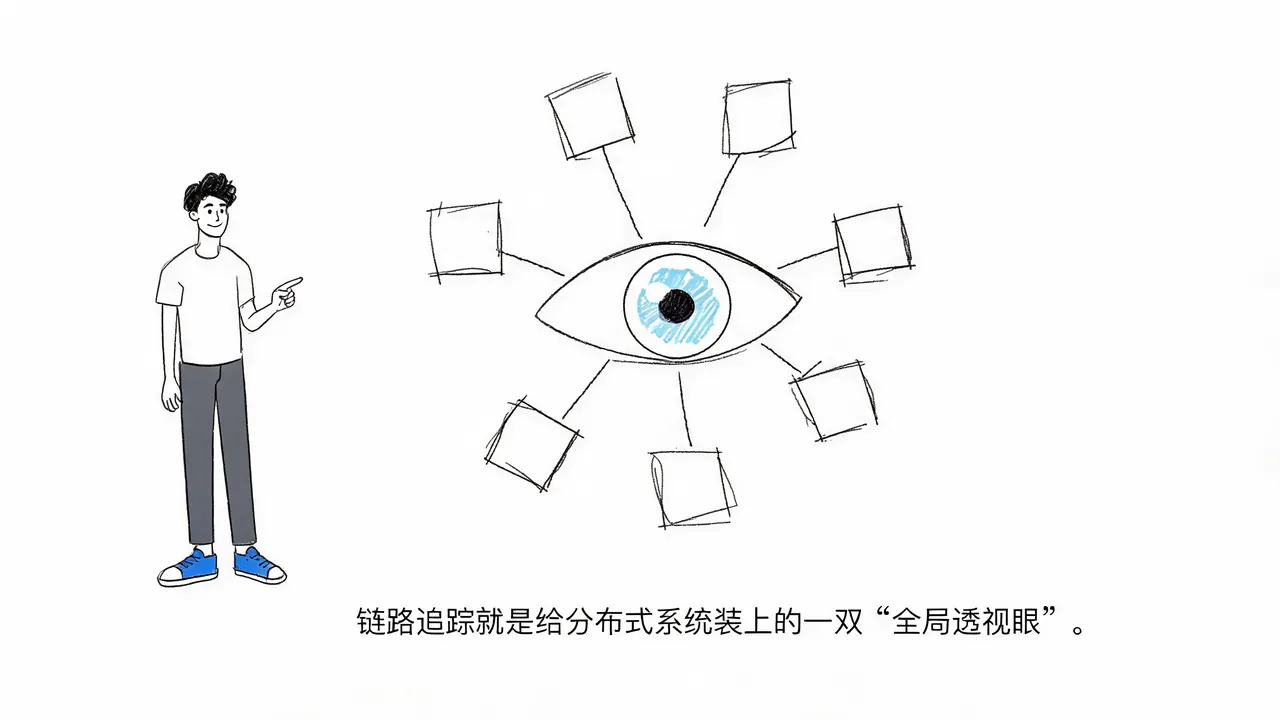
当系统拆分为大量微服务后,传统局部日志排障彻底失效。本文深入解析链路追踪的核心机制(TraceID与Span),阐述其如何解决故障定位难、性能瓶颈隐蔽等问题,并探讨适用场景与性能权衡。