数据库连接池耗尽排查与线上连接泄漏兜底策略
深入解析数据库连接池耗尽的排查思路与连接泄漏的兜底方案。从连接池方案对比、风险量化分析到架构落地规范,帮助后端工程师构建高可用的数据库资源防护体系,避免全链路雪崩。
共 276 篇文章
深入解析数据库连接池耗尽的排查思路与连接泄漏的兜底方案。从连接池方案对比、风险量化分析到架构落地规范,帮助后端工程师构建高可用的数据库资源防护体系,避免全链路雪崩。
传统软件依赖代码断言与证明,而大模型的能力无法被推导,只能被测量。本文通过对比蒸汽机与热力学、化学与数学,揭示大模型研发本质上是实验科学,其核心壁垒在于团队积累的“手感经验”而非单一理论突破。
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
本文探讨大模型研发中“炉次”(有效实验回合数)的核心地位。分析为何智力仅是入场券,算力本质是购买实验机会,以及规模法则如何锁定竞争格局,揭示算力真正拖慢的是人才厚度而非模型分数。
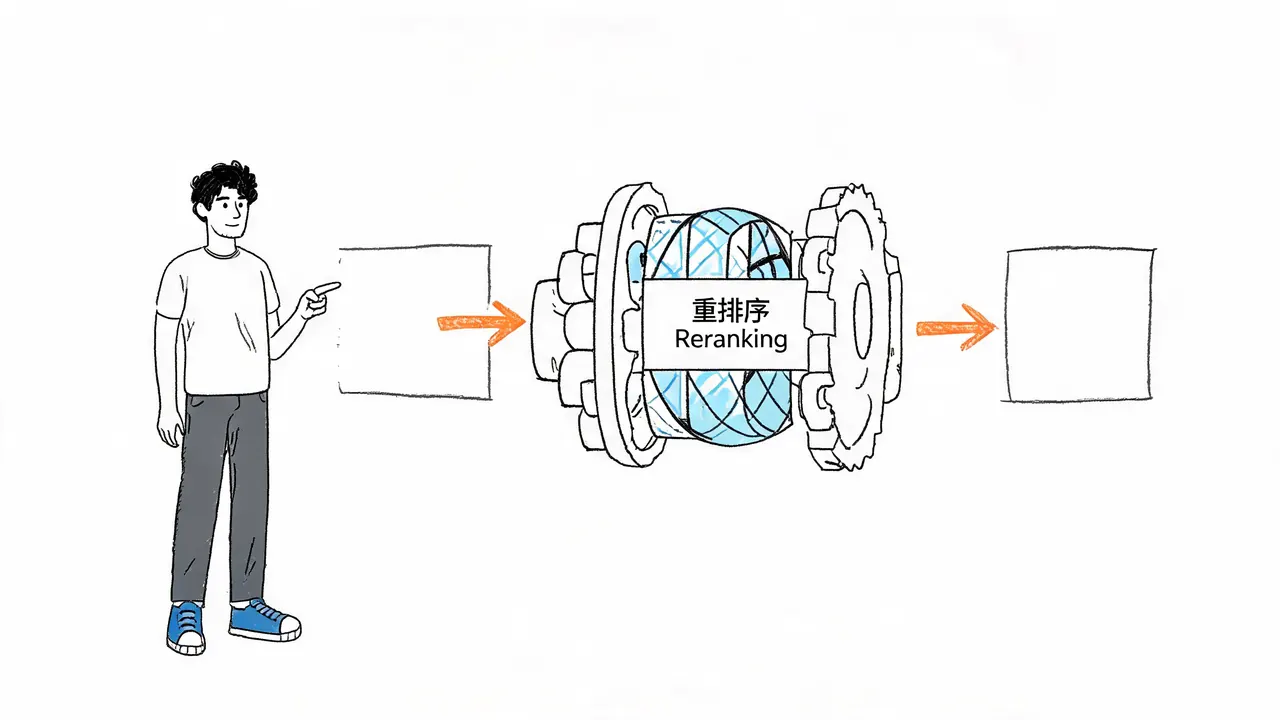
在 RAG 系统中,检索成功但答案不准往往源于重排序环节。本文解析重排序在召回与生成之间的关键位置,对比向量与关键词检索的盲区,阐述交叉编码器原理,并明确其受限于召回率、切分质量及算力成本的三大边界。
中美AI模型公开评测分数差距不足3%,但算力总预算差距显著。本文解析总算力、高端芯片及新增份额的多维差距,探讨算力约束如何影响训练与推理的资源取舍、技术路线探索半径,以及最终对人才成长速度和实验席位的长期影响。
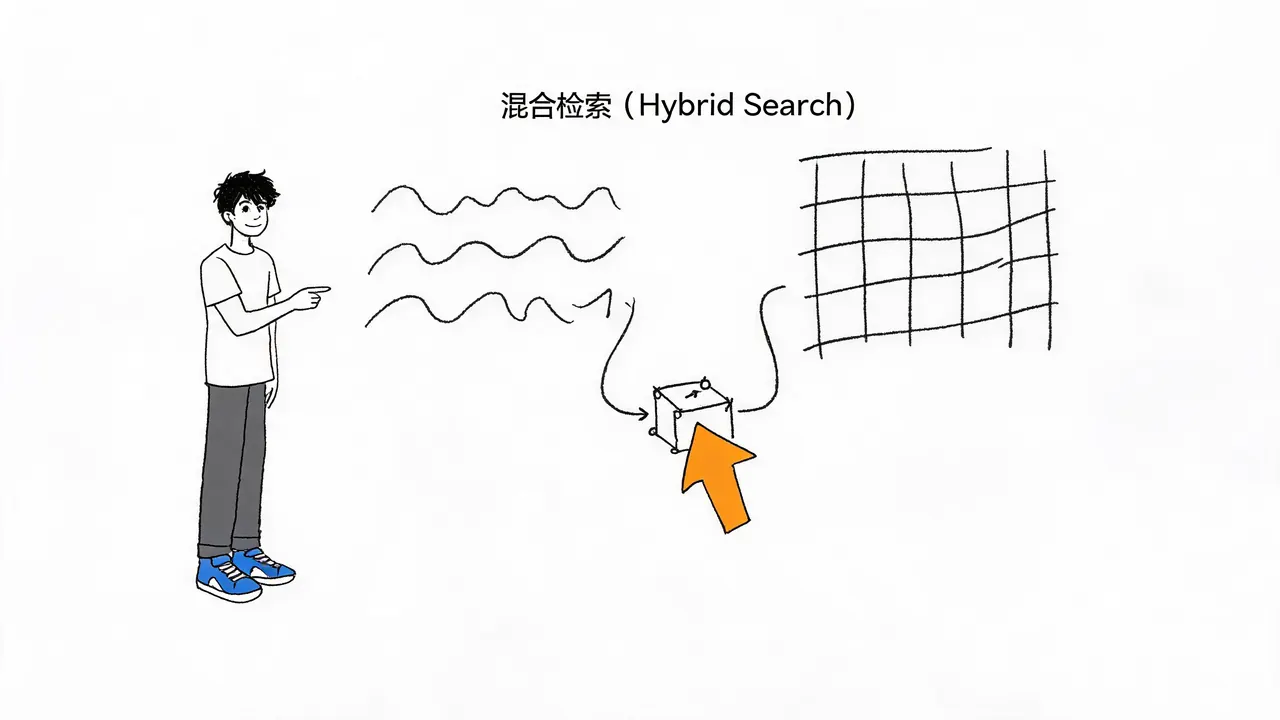
深入解析混合检索(Hybrid Search)的核心原理,探讨如何通过向量检索与关键词检索的双路召回及融合排序,解决单一检索方式在语义理解和精确匹配上的局限性,提升 RAG 系统的召回鲁棒性。
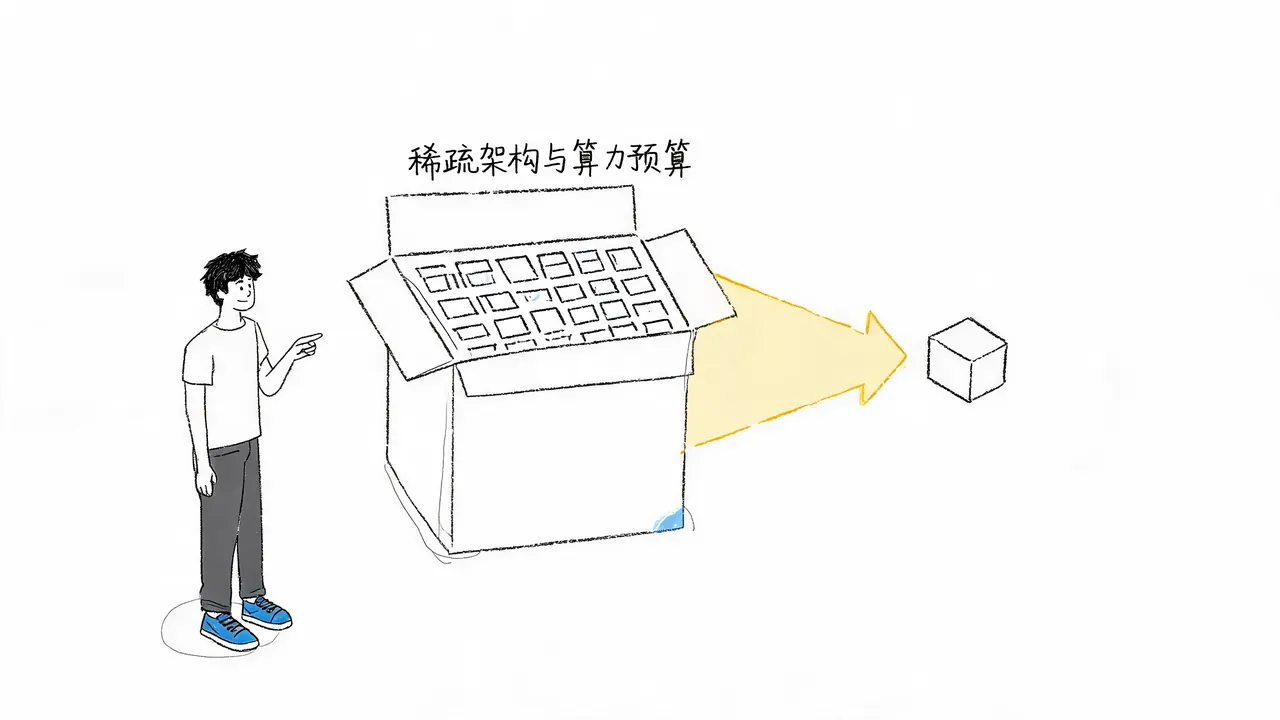
解析稀疏架构如何以3%的激活参数实现高效推理,探讨算力预算、思考长度与尝试次数对模型能力的真实影响,揭示中美大模型在资源约束下的不同技术路径。
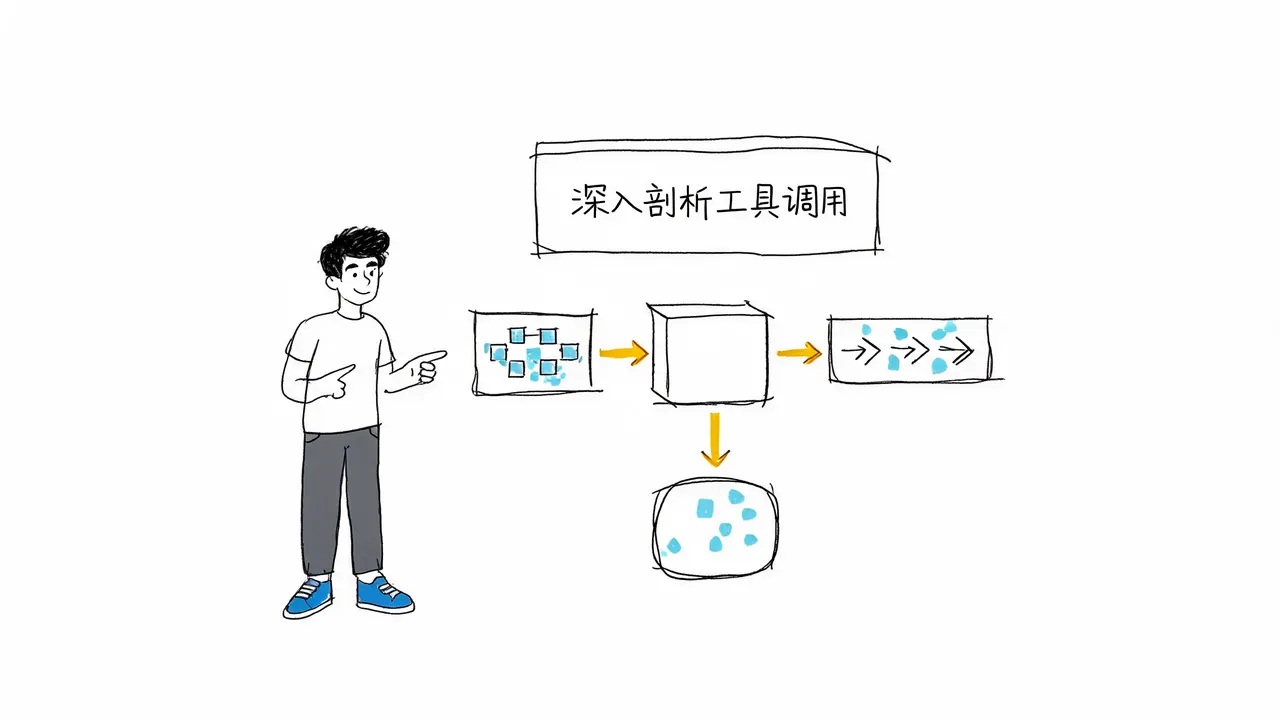
本文深入解析 Function Calling 机制,阐述大模型如何通过生成结构化请求连接外部系统。文章拆解了工具声明、六步调用闭环及安全风险边界,并总结了面试中关于模型与系统职责分工的核心观点。
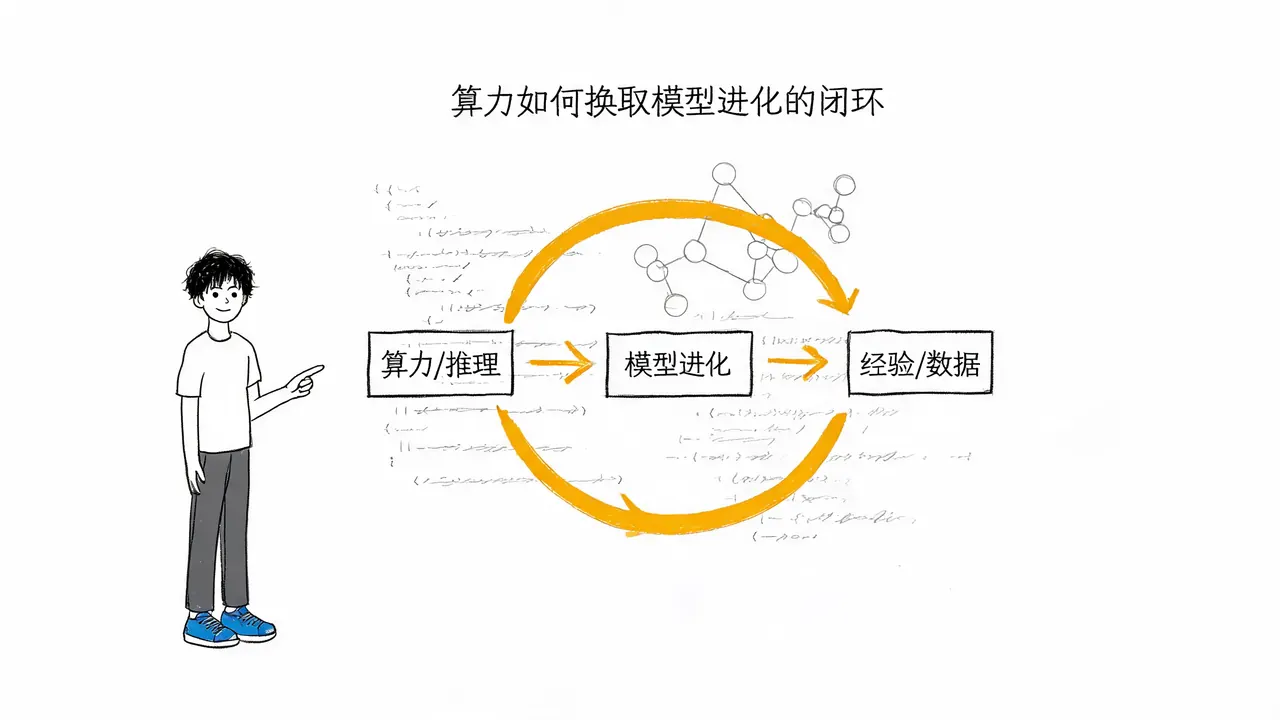
互联网文本虽多,但带结果标签的经验稀缺。合成数据需裁判机制,大规模应用产生的经验轨迹才是下一代模型的核心原料。算力从一次性训练转向持续实验,验证器边界决定自主学习上限。
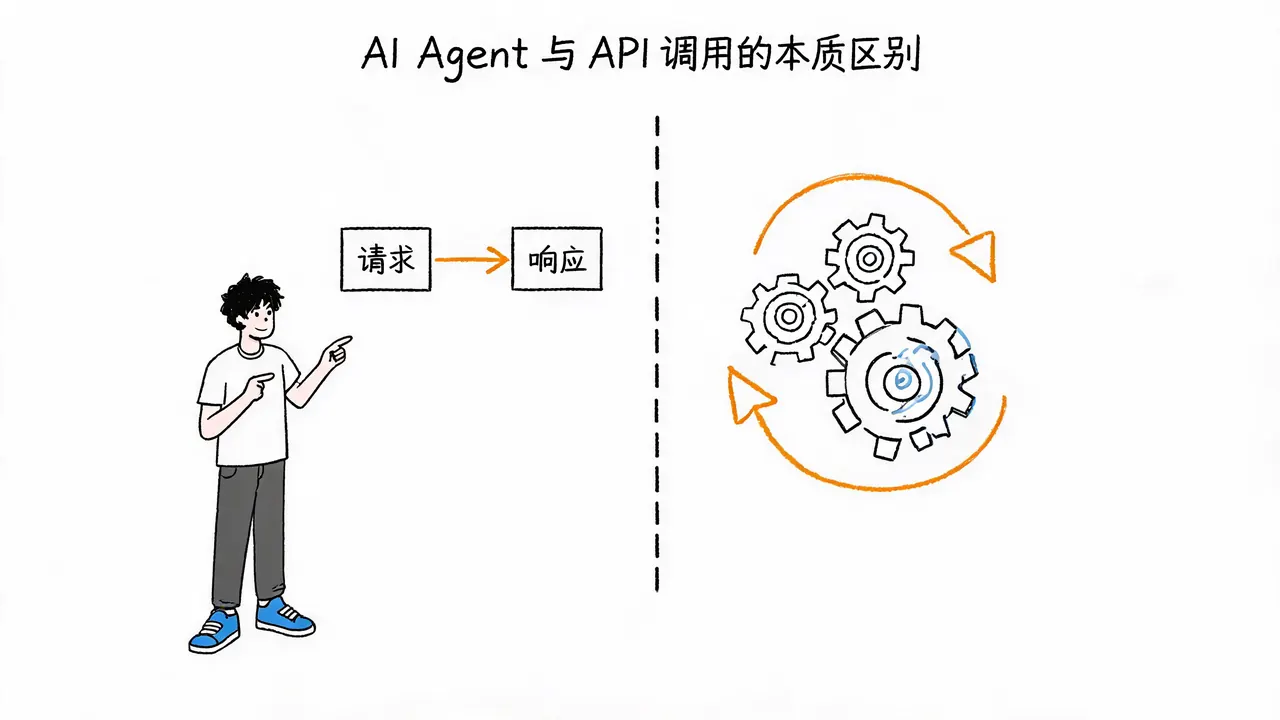
接入大模型 API 不等于拥有 AI Agent。本文深入解析 Agent 的目标驱动特性、五大核心组件及执行闭环,对比普通 API 调用的差异,并探讨成本、错误累积及安全边界等工程约束,帮助开发者正确理解并构建可靠的智能体系统。
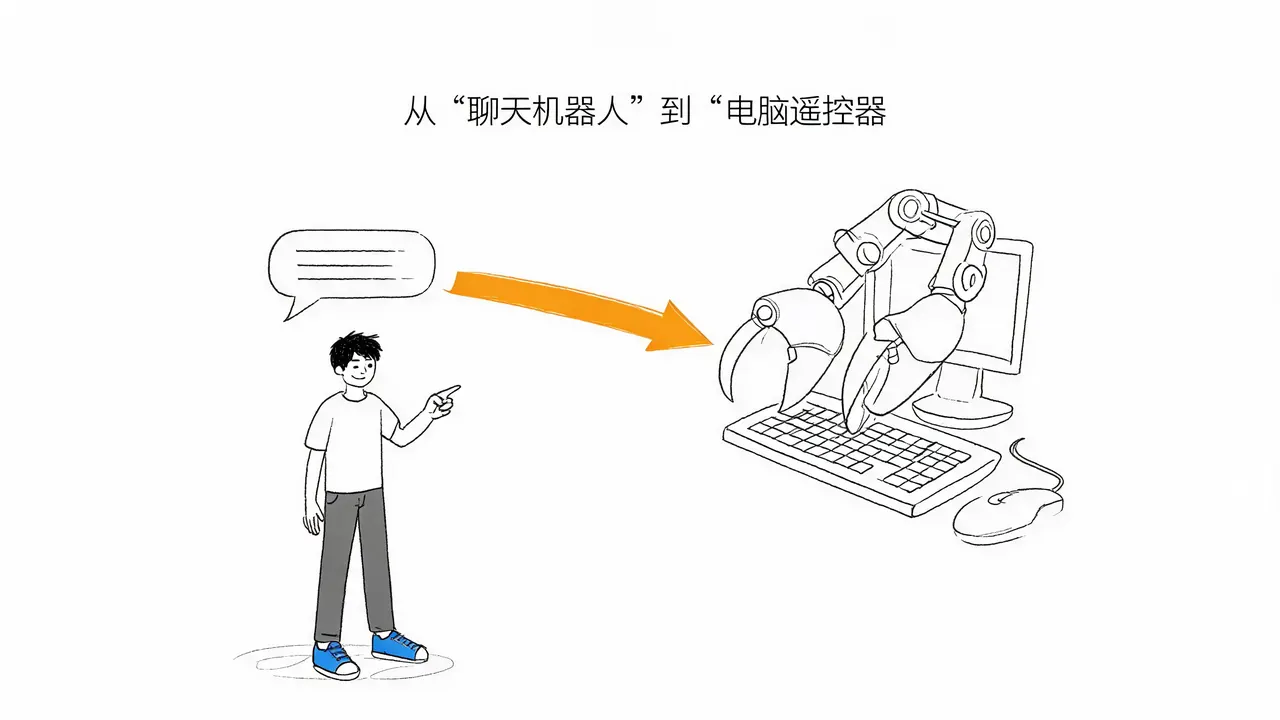
本文深入探讨 OpenClaw 如何重新定义 AI 交互方式。通过结合聊天入口、本地运行环境与 AI 编程工具,OpenClaw 将 AI 从“思考者”转变为“执行者”,实现了真正的自动化办公。文章分析了其核心架构优势及“养龙虾”现象背后的用户心理,并指出其作为“点火器”对大众 AI 认知的启蒙作用。