Nginx也要做集群?单机扛不住流量时的架构演进方案
在许多人的印象中,Nginx 是专门用于给后端服务器分发流量的“大门保安”。它本身性能极高,似乎永远不会成为系统瓶颈。然而,当流量激增到一定程度,或者服务器发生突发故障时,整个网站可能会瞬间瘫痪。
Nginx 到底为什么会“扛不住”?业界通常如何构建 Nginx 集群?你的业务是否真的需要为此投入成本?本文将深入解析流量入口的扩容逻辑与架构选择。
``破除误解:Nginx 的性能并非无限
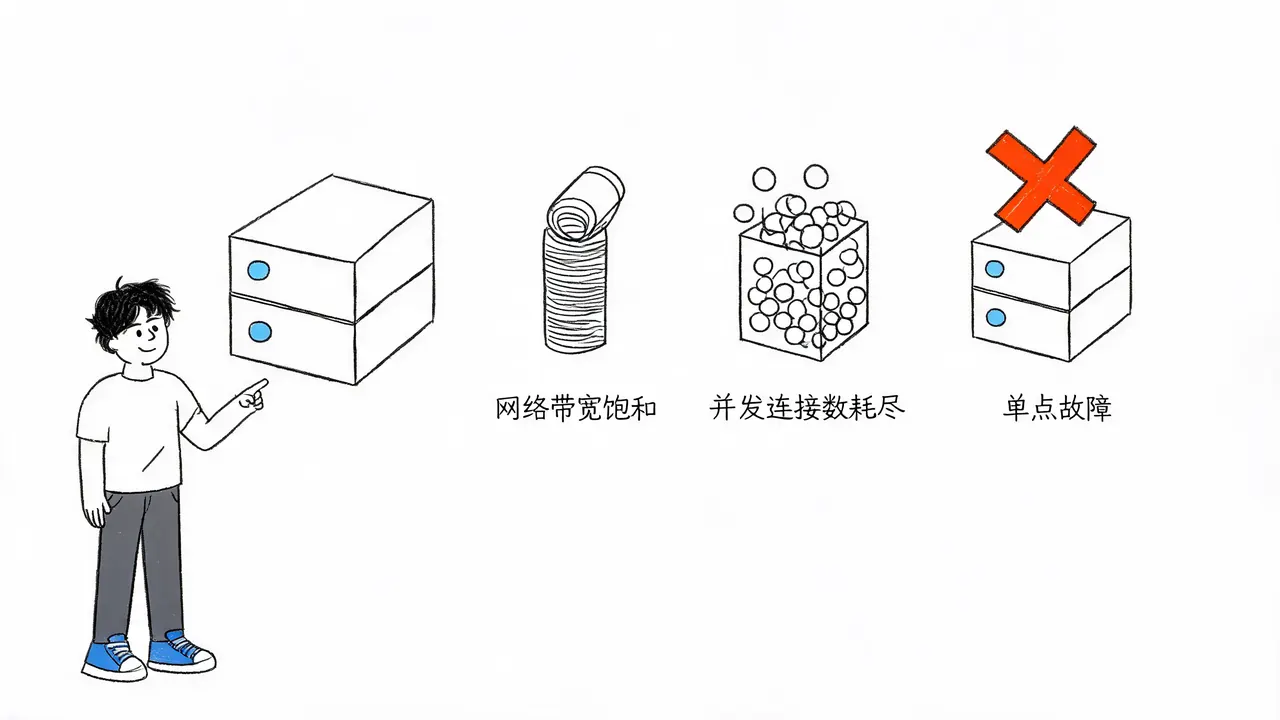
首先要纠正一个常见误区:Nginx 的性能不是无限的。一台单机 Nginx 无法承载所有流量,通常不是因为其计算能力不足,而是受限于以下三个物理边界:
- 网络带宽饱和:进出服务器的网络通道宽度有限,当请求量超过带宽上限时,多余的数据包无法进入。
- 并发连接数耗尽:操作系统能同时维持的 TCP 连接数存在上限,一旦达到阈值,新的连接请求将被拒绝。
- 单点故障(最致命):只要这台 Nginx 服务器因断电、死机或硬件故障停止服务,即使后端有 100 台业务服务器正常运行,用户也无法访问网站。
第一阶段:主备高可用(HA)解决单点故障
为了解决单点故障风险,最基础且有效的做法并非直接构建复杂集群,而是实施主备高可用(High Availability)。
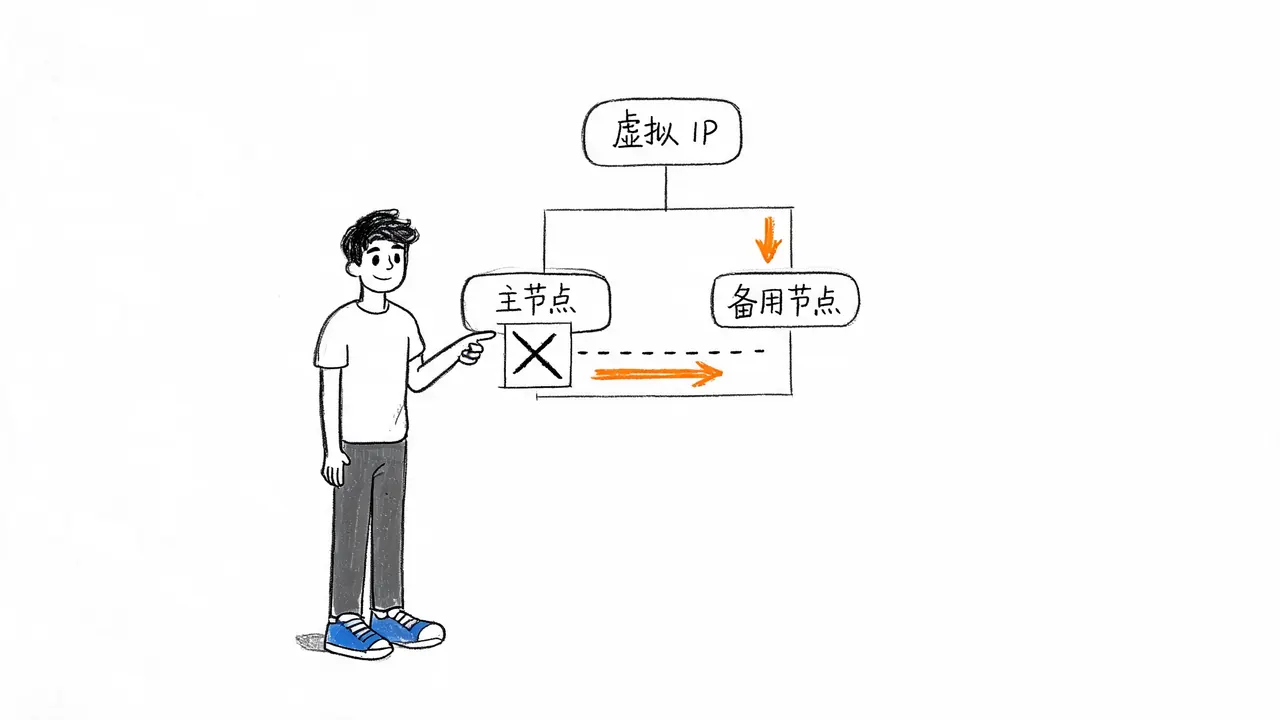
可以将此模式理解为给大门配备一名“替补保安”。在业界,这通常通过 Keepalived 等工具来实现:
- 架构组成:部署两台服务器,一台作为主节点(Master)处理流量,另一台作为备用节点(Backup)实时监控。
- 故障转移:一旦主节点心跳停止或宕机,备用节点会在几秒内接管对外的虚拟 IP(VIP),瞬间顶替主节点的位置,确保服务不中断。
对于绝大多数中小型公司而言,这种主备模式足以解决大部分 Nginx 宕机带来的风险,且实施成本较低。
第二阶段:Nginx 集群应对海量并发
如果业务规模达到电商大促级别或千万级日活,流量大到单台 Nginx 的网卡带宽和连接数均无法处理,此时“替补保安”模式已失效,需要引入真正的 Nginx 集群。
架构方案
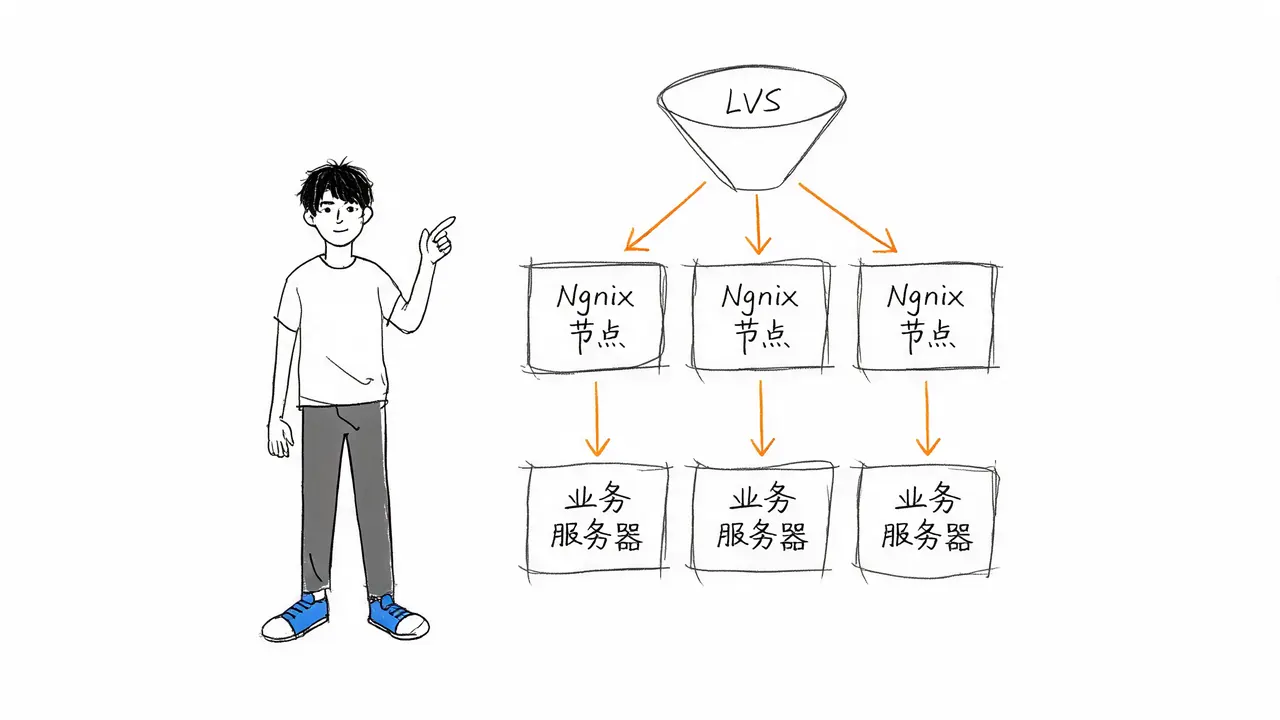
在 Nginx 前方增加一层更底层的总调度器,形成多层漏斗状的流量分发网络:
- 总调度层:使用 LVS(Linux Virtual Server)这种四层负载均衡技术,或直接购买云厂商提供的云负载均衡服务(CLB/ALB)。
- 分发逻辑:总调度负责将海量的网络请求均匀地分发给后端的多台 Nginx 节点。
- 业务处理:多台 Nginx 节点各自接收请求,并进一步分发给后端的业务服务器。
这种架构有效突破了单机的网络与连接数瓶颈,实现了横向扩展。
关键原则:避免过度设计
在架构设计中,必须明确一个边界:不要盲目堆砌资源。
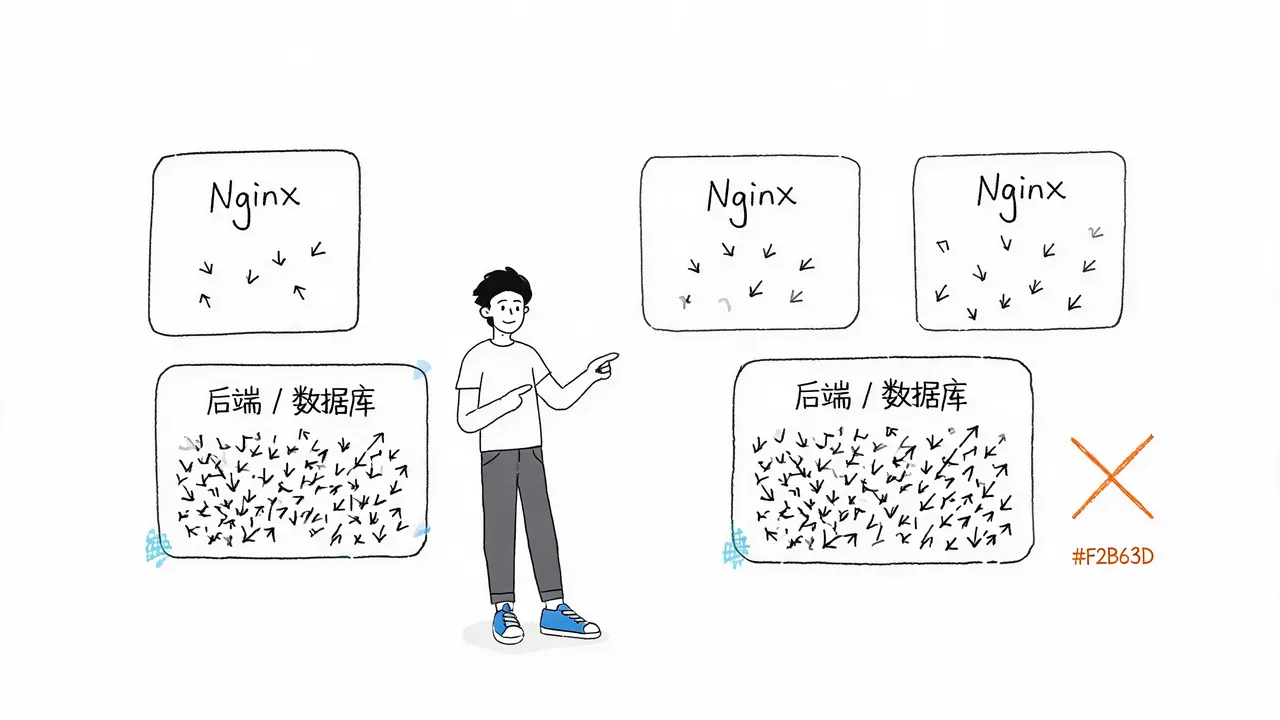
- Nginx 的高并发能力:Nginx 本身的并发处理能力极强,单机通常能轻松支撑数万并发连接。
- 真正的瓶颈往往在后端:在多数情况下,系统先扛不住的往往是后端的数据库、缓存服务或业务代码逻辑,而非 Nginx 本身。
排查建议: 如果发现网站响应变慢,第一步应是排查后端应用的瓶颈(如 SQL 查询效率、内存泄漏等),而不是盲目给 Nginx 增加机器。
总结:根据场景选择方案
面对“一台 Nginx 扛不住”的问题,解决方案取决于具体的痛点:
- 怕“生病”(宕机风险):采用主备高可用方案兜底,确保服务连续性。
- 怕“挤爆”(性能瓶颈):在前方加一层总调度(LVS/云负载均衡),构建 Nginx 集群以分散流量。
架构设计从来不是无脑的“叠罗汉”,而是根据真实的流量规模与业务需求,为流量大门配置最合适的“安保团队”。