别迷信多智能体:复杂任务的架构选型与成本陷阱
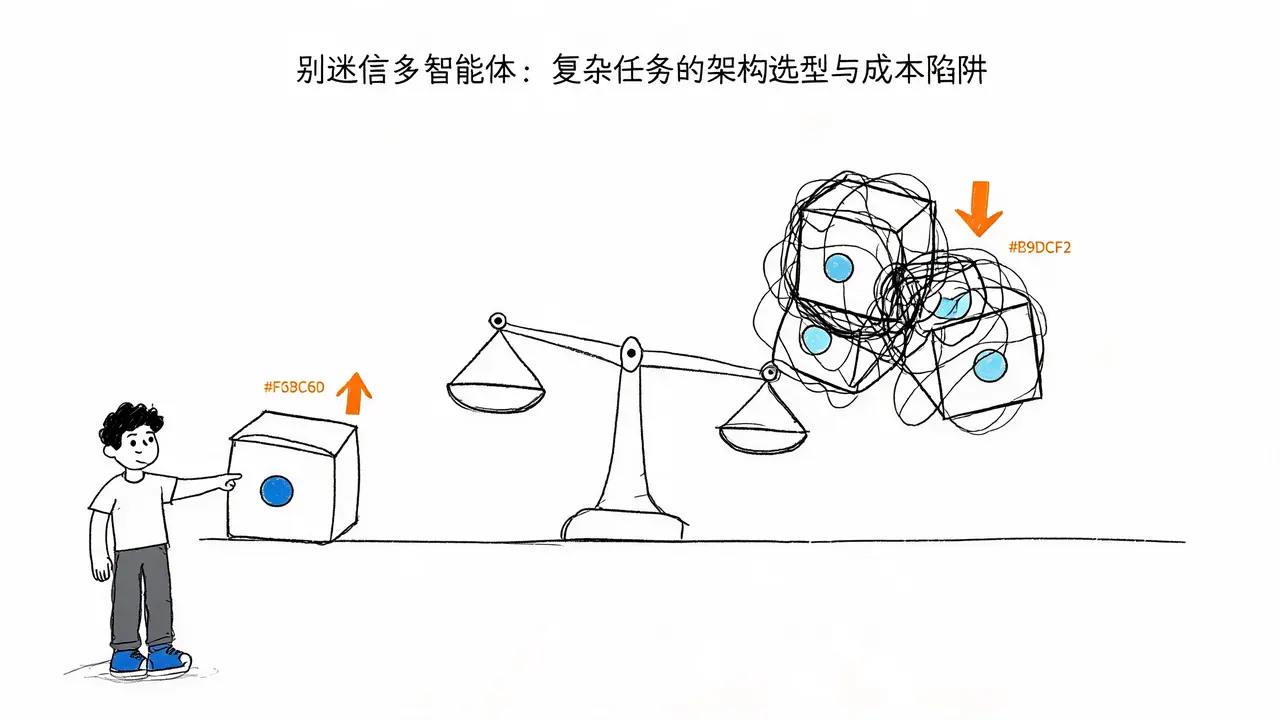
在工程实践中,许多开发者倾向于将复杂的开发任务强行拆分给多个 Agent 并行处理,期望通过“多脑协作”提升效率。然而,实际运行结果往往令人失望:系统执行速度变慢,Token 消耗大幅增加,最终生成的代码甚至频繁报错。
这种反常识的现象并非源于大模型能力的不足,而是任务在工程设计源头就不具备多智能体协作的条件。本文将基于系统日志分析,探讨多智能体架构的适用边界,并分享在复杂任务中进行技术选型的核心原则。
深度串联任务:多智能体的“反模式”
面对复杂的业务流程,最容易踩的坑就是强行将任务切碎,分发给多个 Agent。如果任务链条是深度串联的——即下一步必须依赖上一步的结果,或者多个动作必须紧密绑定在同一批代码文件和长上下文中——引入多智能体往往得不偿失。
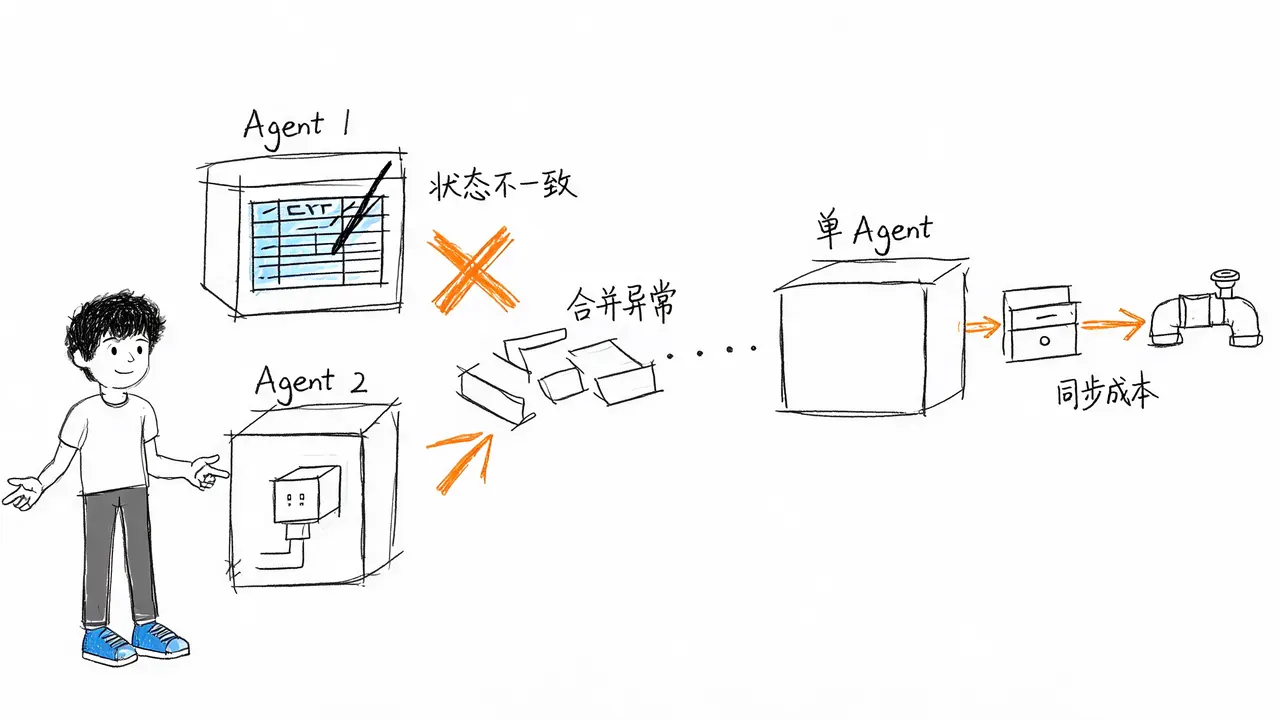
以业务重构为例,假设需要同时修改底层数据库逻辑和对外接口。若派两个 Agent 分头行动,由于这两个动作在物理上高度纠缠,日志中常出现以下冲突场景:
- 状态不一致:数据库 Agent 删除了旧字段,而接口 Agent 仍基于旧表结构生成校验逻辑。
- 合并异常:代码合并时系统抛出异常。
- 高昂的同步成本:为了修复错位,两个 Agent 需反复将对方修改的代码同步进各自上下文,消耗大量 Token 用于“互相解释”。
算上通信延迟和解决冲突的算力消耗,这种模式远不如**“单大脑挂载多工具”**划算。单 Agent 搭配丰富的外部工具,不仅能节省沟通成本,还能在物理层面保持全局逻辑的一致性,是目前许多落地项目最稳妥的做法。
宽度型场景:多智能体的真正价值
多智能体架构并非无用,其真正能“回本”的场景是横向铺开的宽度型任务。判断标准很简单:
- 被拆解的子任务必须能独立探索。
- 最后只需一套固定规则即可完成拼装。
典型应用场景
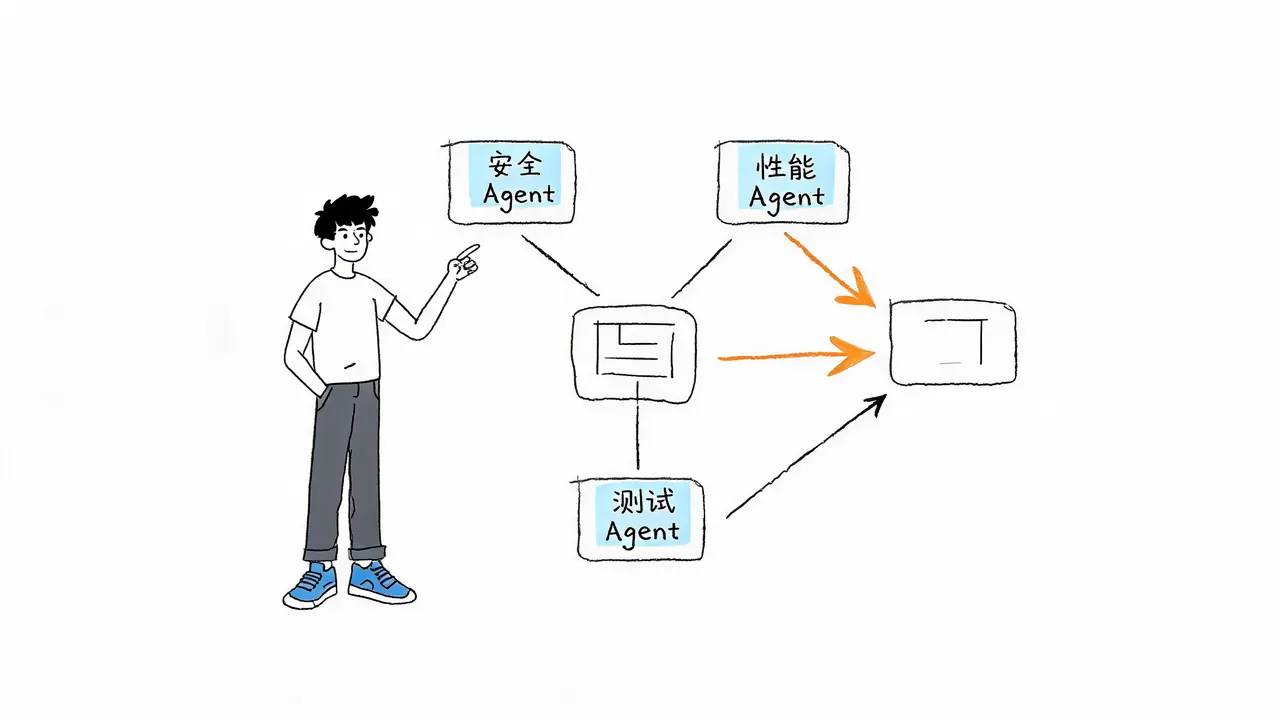
1. 大型项目代码审查 代码审查非常适合并行处理,因为各环节可以充分解耦:
- 安全 Agent:专注扫描 SQL 注入和漏洞。
- 性能 Agent:只抓内存泄漏和运行效率。
- 测试 Agent:检查单元测试覆盖率。
这三个环节无需知晓对方细节,唯一共同点是读取同一份源码。在这种环境下,真正的并行执行能通过更广的覆盖和更高的效率,抵消系统调度开销。
2. 市场数据挖掘 让多个子节点分别去不同平台抓取竞争对手情报,最后由主节点合并成数据透视表。只要信息不需要深度交织,多智能体就能实现事半功倍。
选型决策:三项核心数据指标
在技术评审会上决定引入多智能体之前,建议先在后台算清楚以下三项核心数据,避免被“先进”的名词误导:
1. 看耗时(End-to-End Latency)
测试并行处理之后,系统整体的端到端响应时间是否真正下降。如果并行带来的调度开销超过了计算节省的时间,架构就是失败的。
2. 看成本(Cost-Benefit Analysis)
将多消耗的 API 费用单独列出,对比最终任务成功率的涨幅。评估投入产出比是否合理,避免为了追求架构复杂度而牺牲经济性。
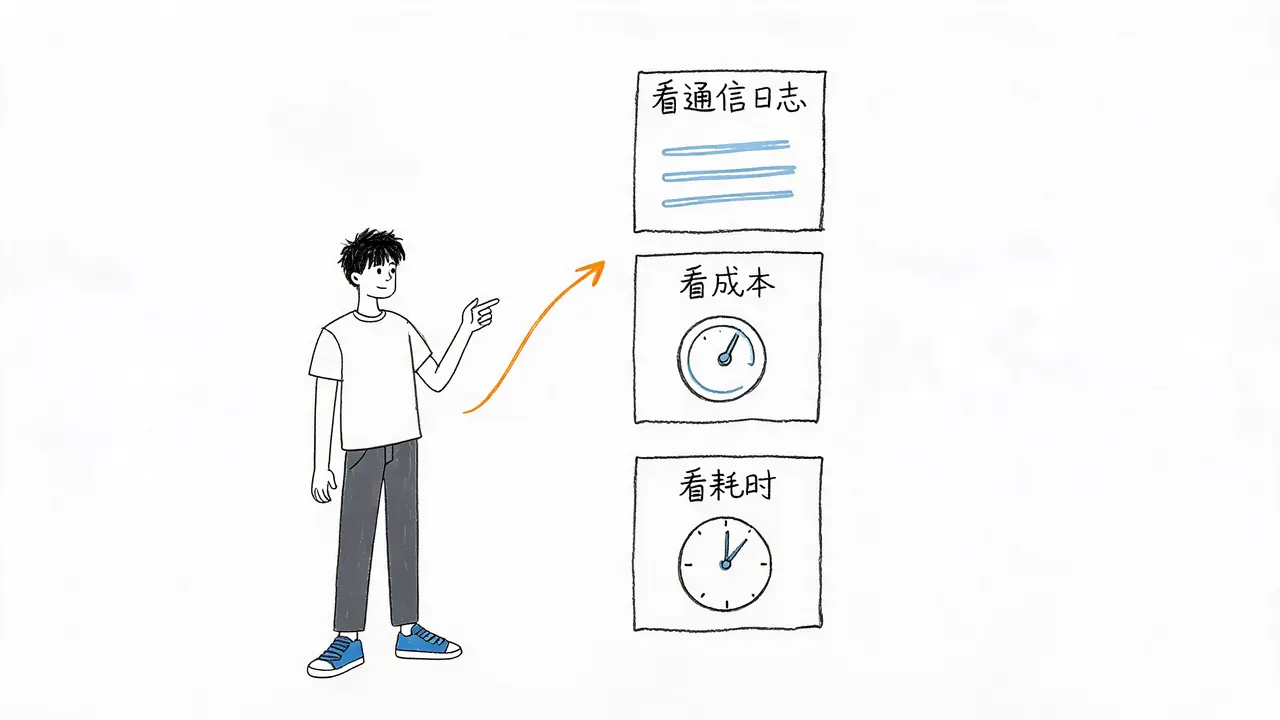
3. 看通信日志(Communication Logs)
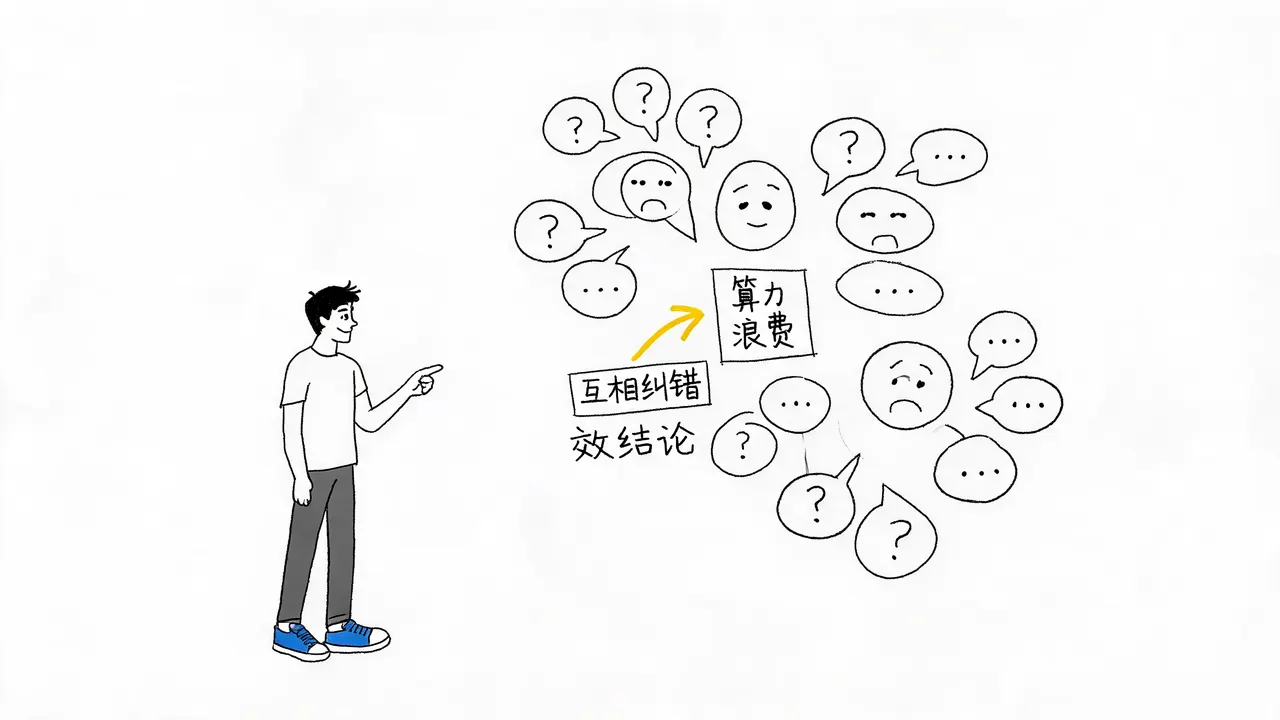
这是最重要的一点。抽查系统日志,观察有多少对话是为了解决合并冲突和互相纠错而产生的“废话”。
- 警示信号:如果几个虚拟角色在沙盒里来回讨论十几轮,互相客气半天却未给出有效结论,这并非“智能涌现”,而是毫无意义的算力浪费。
- 理想状态:我们需要的是独立的有效信息能够真正铺开,而非堆砌听起来先进的名字。
结语
架构选型的本质是匹配任务特性与系统能力。只要一个问题不能被干净利落地物理切分,就先别让高昂的沟通成本去伪装高级的人工智能。
在引入多智能体之前,请牢记:独立有效信息的并行处理才是多智能体的核心价值,而深度耦合任务的强行拆分只会带来性能与成本的双重灾难。