大模型知识库信息冲突处理:Agent 该信谁?
在构建基于大模型的智能体(Agent)系统时,检索增强生成(RAG)是核心环节。然而,当检索结果出现矛盾——例如一份是最新出炉的普通文档,另一份是权威但已过期的手册——直接将两者同时输入大模型,往往会导致模型生成看似合理实则错误的“缝合怪”答案。由于大模型缺乏真实的业务常识,为了强行保持中立,它甚至可能捏造出并不存在的折中方案。
面对这种信息打架的局面,指望模型在生成阶段自行判断并不可靠。真正的解决方案在于工程实施层面,即在检索链路中建立一套硬性的证据优先级规则。
静态文档冲突:建立元数据证据链
解决静态文档冲突的关键,在于数据处理阶段对元数据(Metadata)的精细化治理。
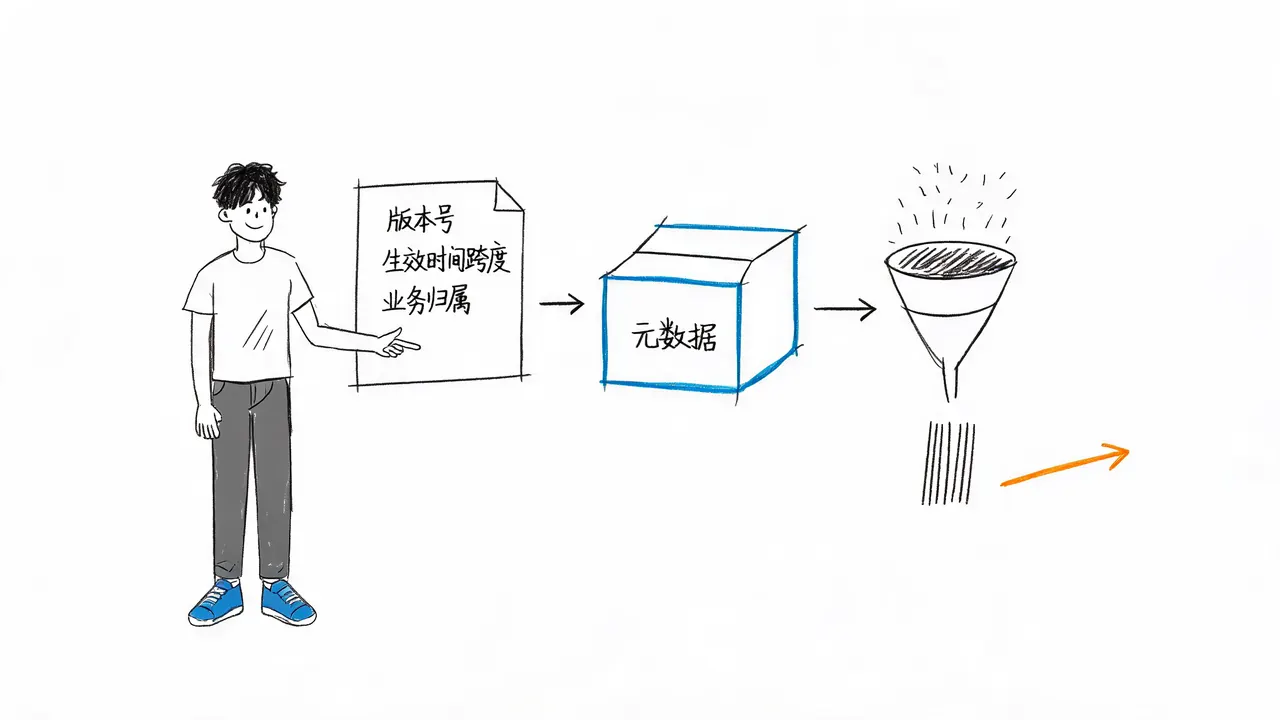
在将原始文档切片并存入向量数据库时,不能仅存储纯文本内容。每一个文本块都必须挂载详尽的元数据,这相当于内容的“数字身份证明”。这些结构化标签必须包含以下关键信息:
- 来源渠道:文档的具体出处。
- 版本号:当前文档的版本标识。
- 生效时间跨度:文档的有效起止时间。
- 业务归属:文档所属的具体业务部门。
通过校验这些元数据,系统可以在进入大模型生成环节之前,利用规则引擎过滤噪音。这类似于处理售后纠纷:针对特定大促(如双11)的退换规则,其优先级天然高于日常通用条款;而官方发布的新版说明,会自动使旧版本条例失效。
因此,Agent 能够剔除那些虽然语义相似度很高,但根据元数据判断已失去效力的文档,从而确保输入给模型的信息在时效性和权威性上的一致性。
动态数据陷阱:意图路由与实时接口
除了静态文档的版本冲突,另一种隐蔽且极易出错的场景是错把实施状态当成离线知识来检索。
用户的订单走向、商品当下的实际库存、刚刚更新的物流报价等数据时刻都在变化。如果将这些动态数据打包塞进离线的向量知识库,Agent 每次查出的结果注定是过期的。
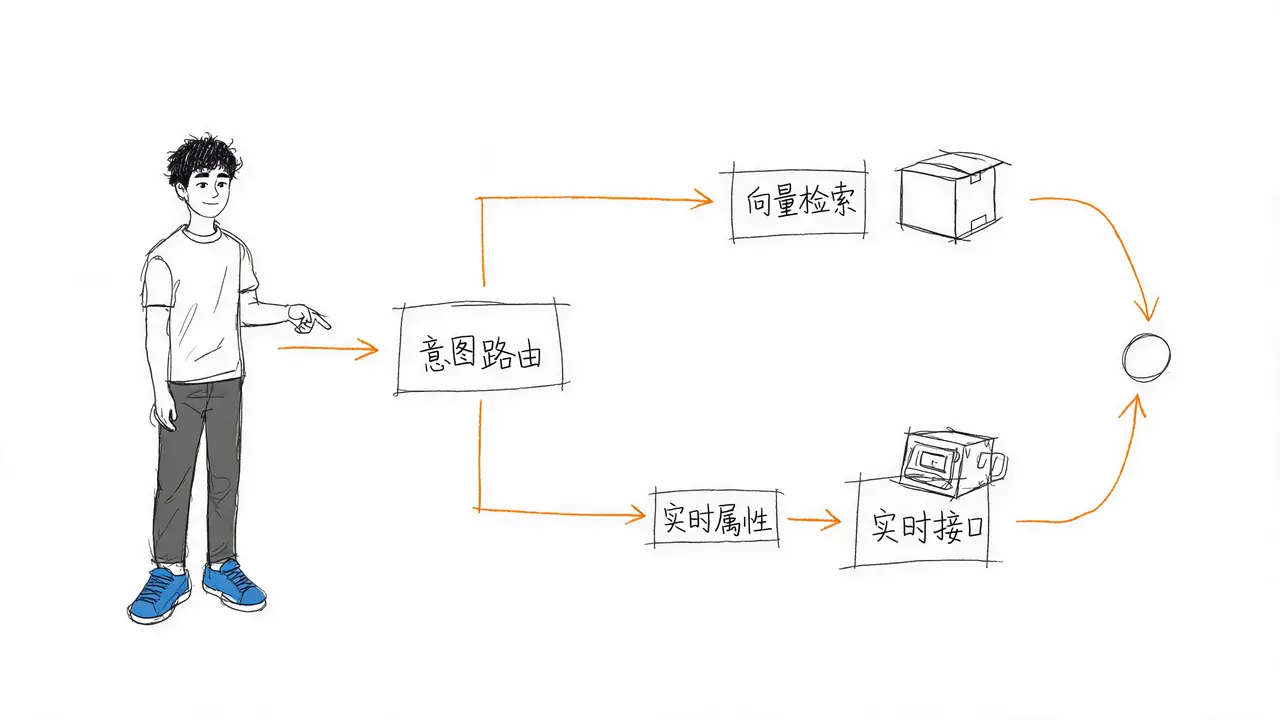
为此,系统必须引入一层**意图路由(Intent Routing)**机制:
- 识别实时属性:当 Agent 检测到用户提问带有明确的实时属性时,应立刻跳过默认的向量检索路径。
- 调用实时接口:转而直接调用业务数据库接口或使用搜索引擎等外部工具获取最新数据。
- 明确数据边界:向量库更适合存放和解释相对稳定的业务规则,而变动的客观事实应交给实时接口处理。
此外,有一个容易被忽略的细节:当 Agent 输出最终答案且用到了实时数据时,必须标注数据返回的具体时间节点。这有助于界定回答的有效范围,避免用户误以为数据是永久的。
极端冲突处理:人工介入与知识治理
即使经过了严格的优先级校验,系统仍可能面临极端情况:两个同等权威、同等新鲜却截然相反的业务指令同时存在。
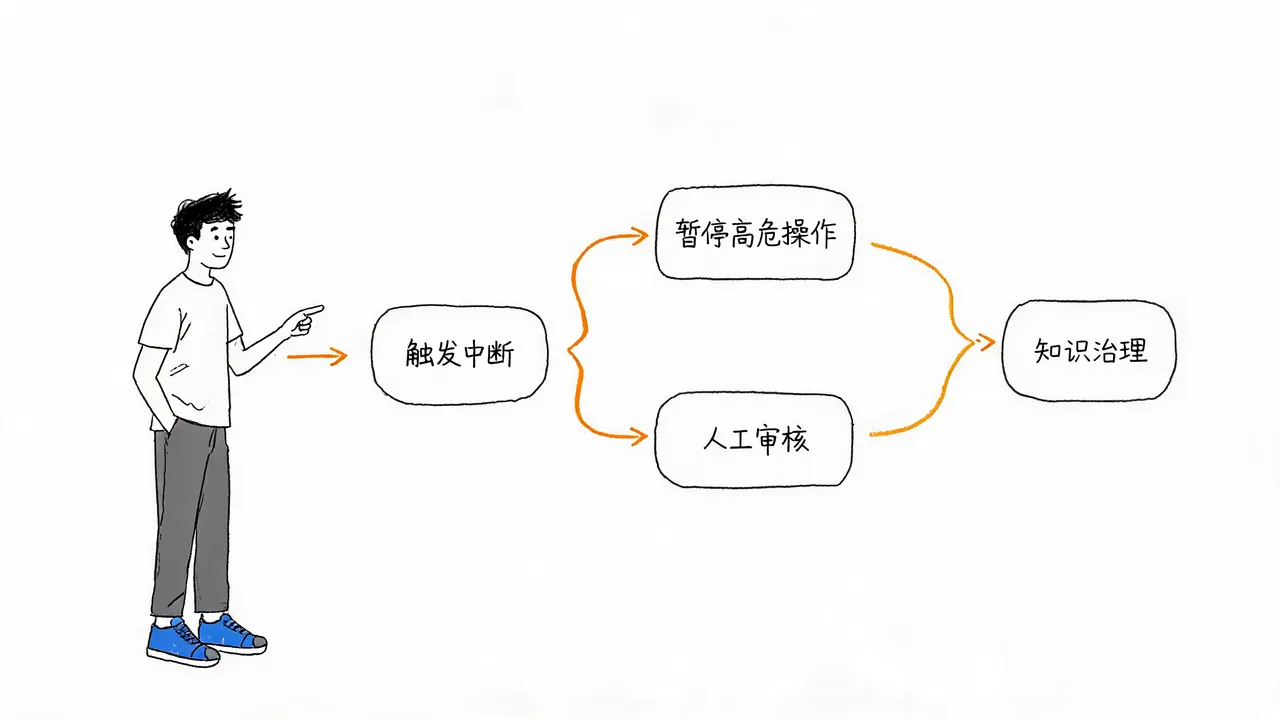
在这种局面下,工程系统不能代替真实的业务管理层做决定。合理的机制是触发中断(Interruption):
- 暂停高危操作:立刻暂停所有如退款、退库之类的高危自动化操作。
- 上报人工审核:系统将矛盾的具体细节(包括两份冲突文件的出处)抛给人工审核专员进行裁决。
人工介入决断后,流程并未结束。这个业务上的管理矛盾必须顺着系统回流到企业的知识治理体系中,去修正或下线造成冲突的源头文件。只靠修改系统里的提示词(Prompt)来掩盖现实中的管理漏洞,是完全行不通的。
结语:从“连连看”到证据链条
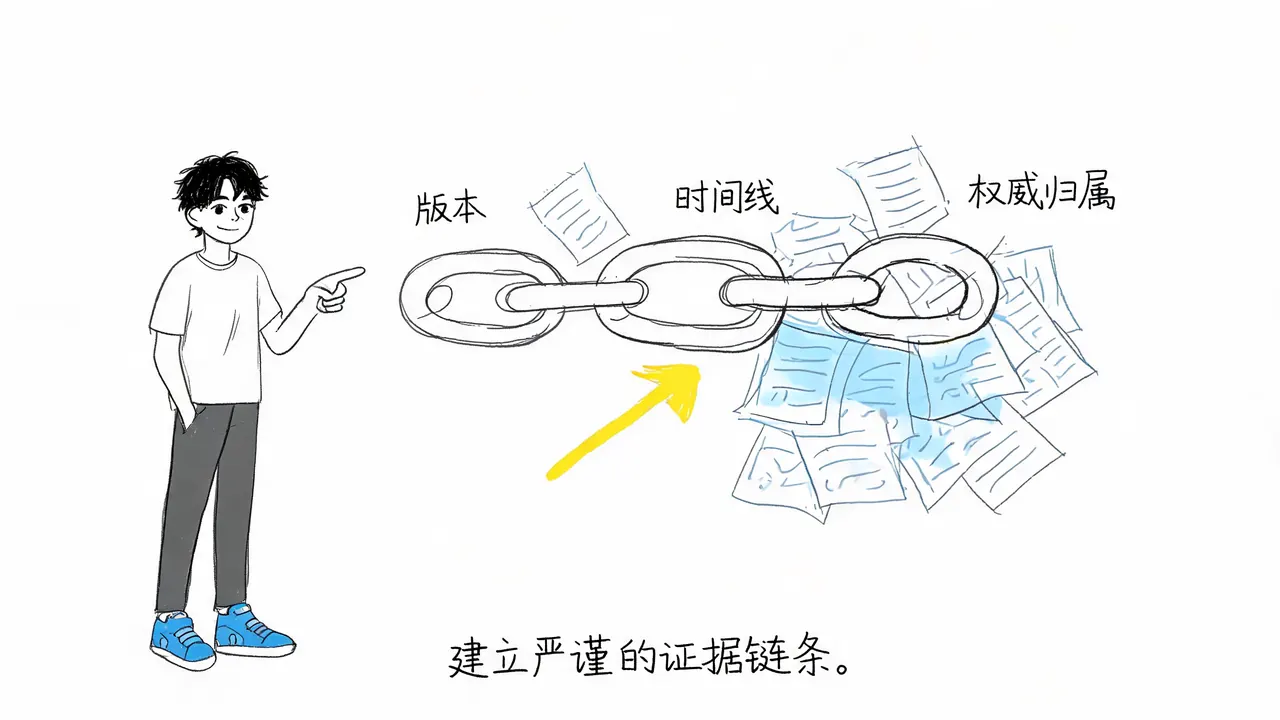
检索增强技术(RAG)的核心价值,并非单纯在海量文字里玩“连连看”,而是在无序的信息堆里建立严谨的证据链条。
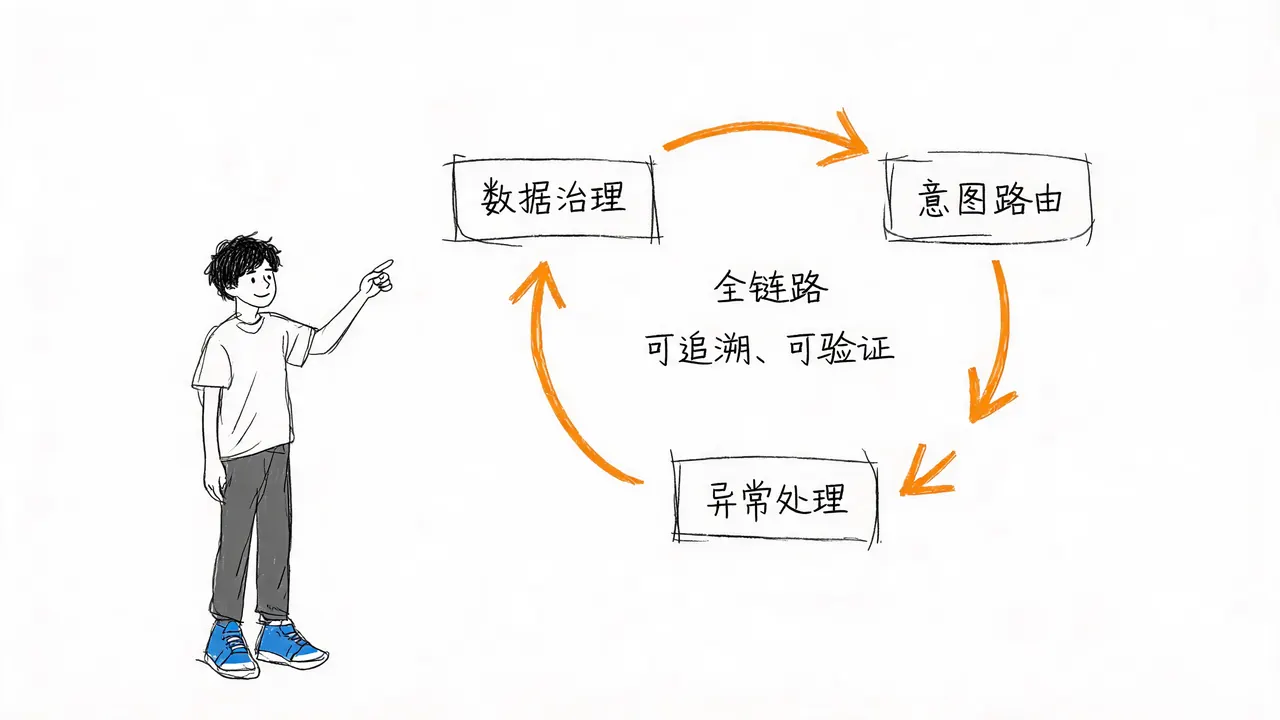
如果不去约束数据的版本、时间线和权威归属,给模型喂进去的数据越杂,Agent 只会在混合矛盾信息的道路上错得越来越离谱。构建可靠的 Agent 系统,需要从数据治理、意图路由到异常处理的全链路工程化设计,确保每一条进入模型的信息都具备可追溯、可验证的证据属性。