大模型总调错工具?教你写好工具说明
在开发 AI 智能体(Agent)时,开发者常遇到大模型选错工具或填错参数的情况。这往往不是模型能力不足,而是 Tool Schema(工具说明)设计不当所致。当工具数量增多,将所有工具说明一次性塞入上下文不仅负担沉重,还容易干扰模型判断。
`` 是摘要与正文的分隔标记,请保留。动态加载:解决上下文负担与发现遗漏
将工具按需加载确实能减少上下文负担,但也会引入一个新问题:如果在“发现阶段”就漏掉了正确的工具,那么无论模型多聪明,后续都无法选中它。
对于 Agent 而言,工具动态加载不仅仅是为了“少放一点说明书”,更关乎整个任务能否顺畅跑通。在工程实现上,一种常见的做法是将工具加载分为两层:
- 第一层:能力目录(Capability Catalog)
- 特点:轻量级。
- 内容:仅包含工具名称、大概用途、适用范围及必要的风险提示。
- 作用:模型理解当前任务后,首先从这个简略目录中筛选出一批候选工具。
- 第二层:完整定义(Full Definition)
- 触发条件:候选范围圈定后。
- 内容:加载具体工具的完整参数要求、返回数据结构及详细使用限制。
- 作用:让模型基于详细信息进行最终选择和参数填充。
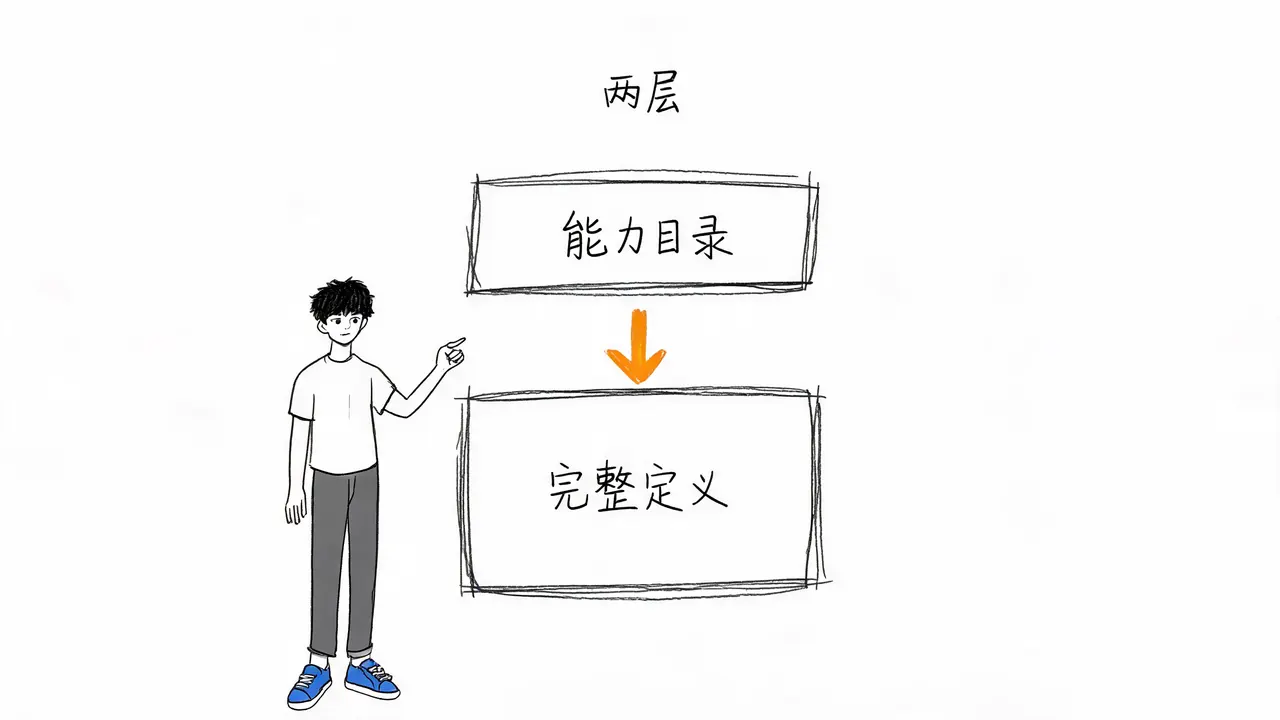
第一层的目录检索(筛选)方式非常灵活,可以基于规则匹配、语义搜索,甚至使用一个小模型来判断,并不依赖某一种特定技术。
电商客服场景示例
假设在一个电商客服场景中,用户要求查询某个订单的发货情况。系统目录中可能同时存在以下工具:
query_order(查询订单)query_logistics(查询物流)modify_address(修改收货地址)
在发现阶段,系统应准确找出与“查询”相关的工具。它不应因为 modify_address 名字里也带有“订单”相关语义,就将这种带有写入性质的工具一股脑开放出去,以防引起不必要的误操作。
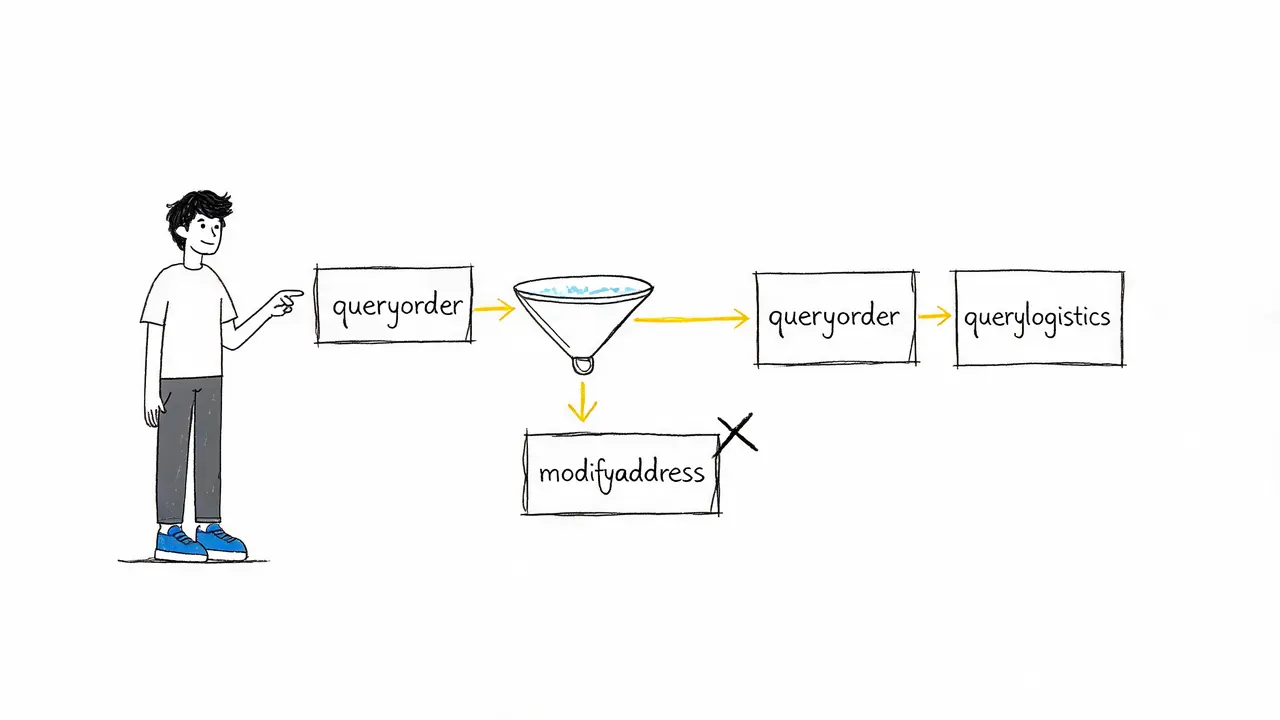
当合适的工具被加载进来后,模型有了详细说明,就能进一步确认:
- 哪个工具需要填入订单编号?
- 哪个工具执行后会返回物流单号?
确认清楚后,再沿着真实的业务依赖关系继续执行。
评测指标拆分:定位问题根源
既然采用了动态加载机制,系统评测时也需要将指标拆开来看,以便精准定位问题:
| 问题类型 | 现象描述 | 优化方向 |
|---|---|---|
| 发现问题 | 正确的工具根本没有进入候选集。 | 优化检索算法或扩大候选范围。 |
| 选择问题 | 候选集里有正确工具,但模型最后选错了。 | 优化工具描述、区分度或模型微调。 |
| 调用问题 | 工具选对了,但该填的参数依然填错。 | 优化参数 Schema 描述、增加示例或校验。 |
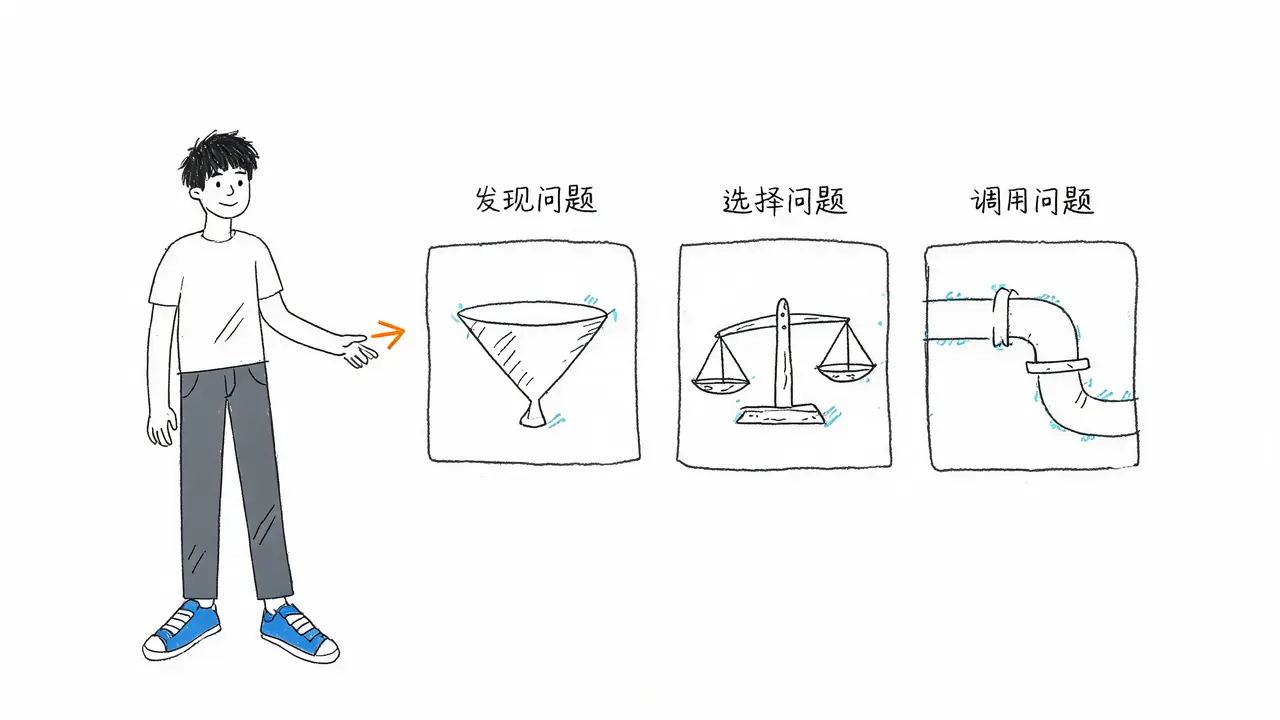
如果不拆分,只盯着最终的任务成功率,会将这三类截然不同的问题混在一起,导致难以排查。
开发中的常见误区
在实际开发中,如果发现工具经常漏选,可以适当扩大候选工具的范围,或者给系统提供一次受控的重新搜索机会。
注意:不能因为怕漏选就依靠“无限加载”来保底。那样做会把“动态发现”又变回“全量塞入”,失去了动态加载的意义。
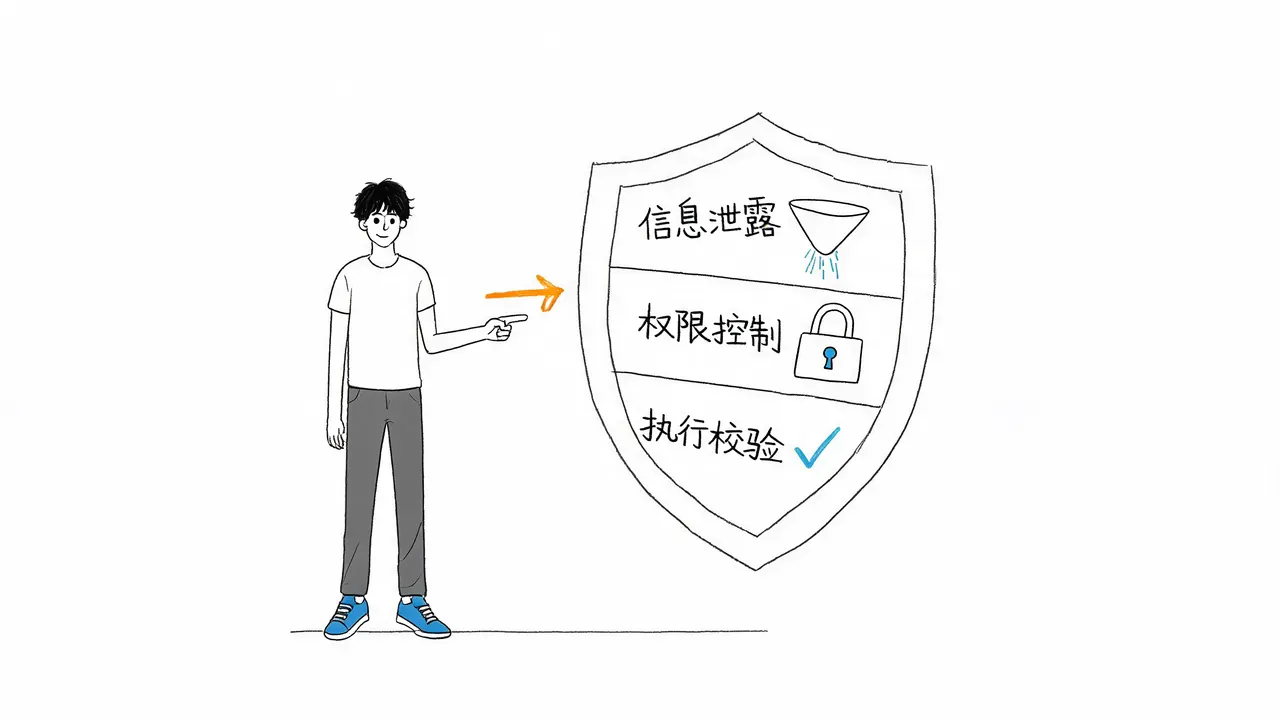
安全考量:权限与可见性
动态加载机制下,安全不能等到工具执行时才第一次考虑。
- 信息泄露风险:即使是轻量的能力目录,工具名称也可能泄露内部系统的存在;详细描述中也可能包含敏感信息。
- 权限控制:必须根据当前用户的身份,限制工具的可见范围。
- 执行校验:在真正执行工具之前,不论是读取还是写入,系统仍要进行相应的权限校验。
取舍建议:何时引入动态加载?
工具动态加载并非万能药,需要根据实际场景权衡:
- 工具很少时:增加发现步骤未必划算,直接全量加载可能更简单高效。
- 工具数量或描述体积影响决策质量时:可以重点评测这种设计。
建议通过实际业务测试,判断“发现步骤”带来的收益是否值得额外的检索开销。
总结
写好 Tool Schema 是 AI Agent 开发的关键。通过两层动态加载架构,可以有效平衡上下文负担与工具覆盖率。同时,建立清晰的评测指标体系(发现、选择、调用)和严格的安全权限控制,是确保 Agent 稳定运行的基础。