Kafka为什么也要搞集群?一台Kafka不够用吗?
很多人存在一个误解,认为 Kafka 需要组建集群是因为单机性能太差。事实上,只要服务器配置合理,单机 Kafka 每秒能处理百万级别的消息。对于绝大多数中小型业务或开发测试环境,一台 Kafka 完全够用。
然而,在生产环境中,尤其是大厂和核心业务场景下,几乎清一色都采用 Kafka 集群架构。这并非因为单机能力不行,而是为了应对单机无法逾越的三个物理边界:存储容量、单点故障风险以及读写并发极限。
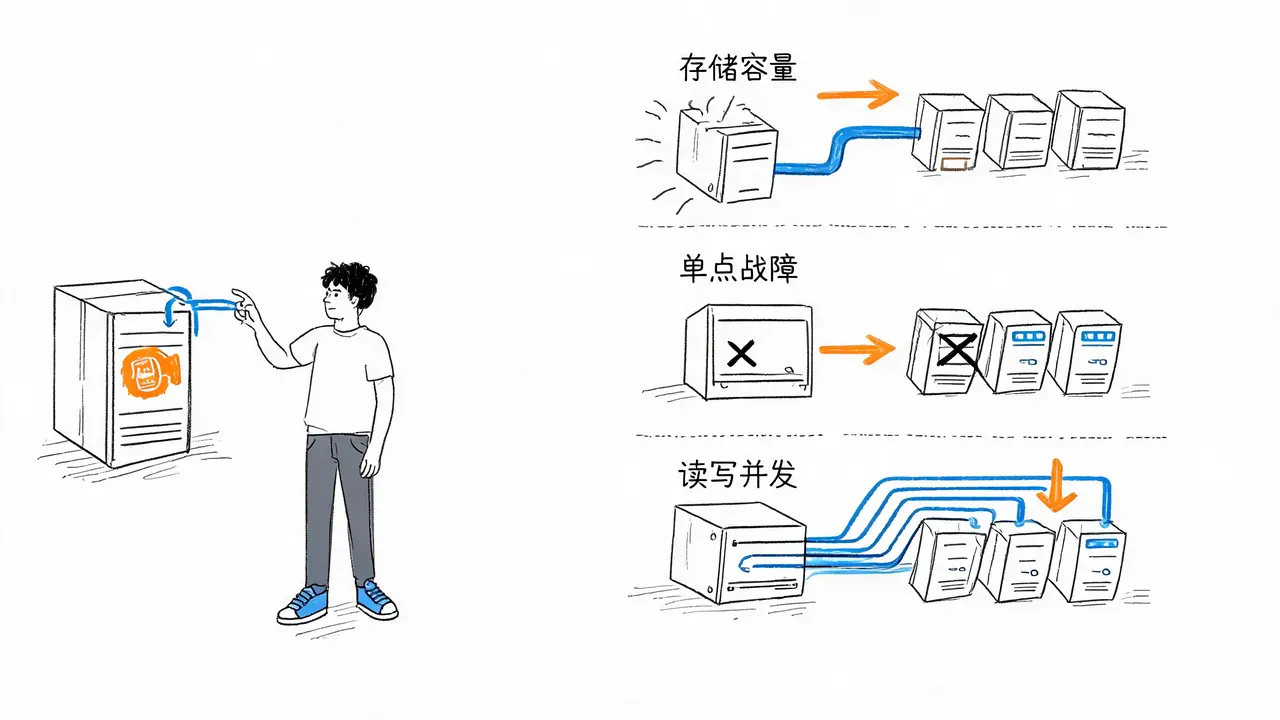
打破存储上限:分区(Partition)机制
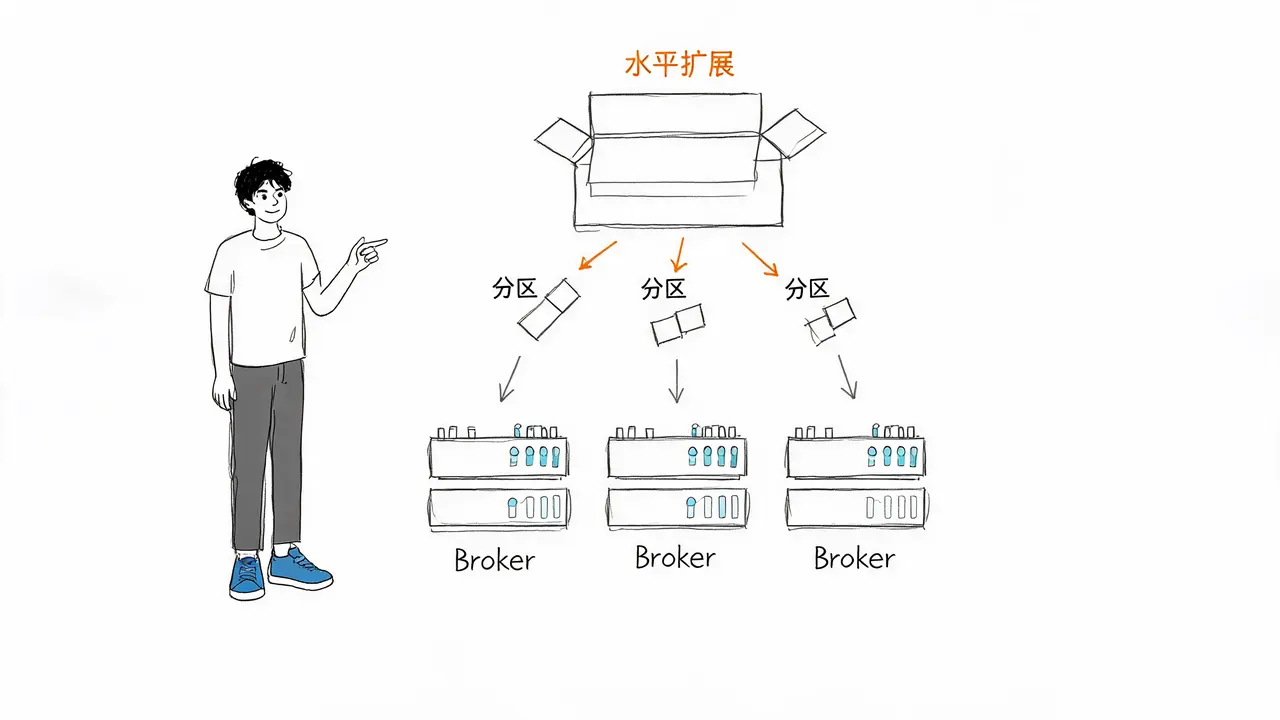
Kafka 天生用于存储海量日志和消息。如果一个核心业务每天产生几个 TB 的数据,单台服务器的硬盘很快就会塞满。为了解决这一存储瓶颈,Kafka 引入了**分区(Partition)**的概念。
可以将一个数据主题(Topic)想象成一个大仓库,而分区则是仓库里的不同货架。在集群模式下,这些“货架”会被分散摆放到不同的服务器上。每台服务器(Broker)只负责存储一部分数据,从而打破了单台机器的存储上限,实现了数据的水平扩展。
消除单点故障:副本(Replica)机制
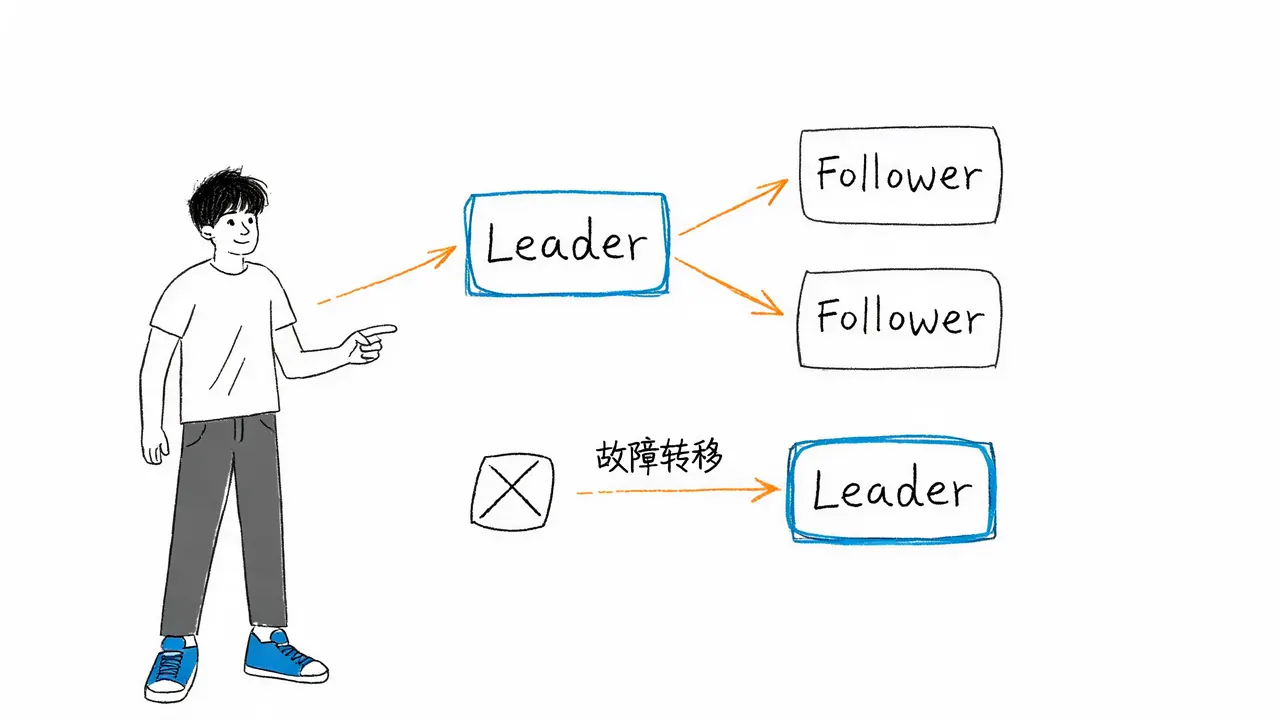
只要是一台机器,就始终面临断电、硬盘损坏或网络中断的风险。如果单机 Kafka 宕机,不仅数据可能丢失,整个业务也会随之瘫痪。为了保证数据不丢且服务高可用,Kafka 集群引入了副本机制。
- Leader 与 Follower:每一个分区都会有一个 Leader(主节点)和若干个 Follower(从节点),它们分别存放在不同的机器上。
- 读写分离:Leader 负责响应所有的读写请求,而 Follower 则在后台默默同步数据。
- 故障转移:一旦 Leader 所在的机器发生故障,集群会立刻将某个 Follower 提拔为新的 Leader。这一过程对业务而言几乎是透明的,用户完全感觉不到中断。
应对高并发:水平扩展能力
虽然单机吞吐量能达百万级,但当用户量从十万暴涨到千万时,同时读写的人太多,单台机器的 CPU 和网卡带宽会被彻底打满,成为性能瓶颈。
在 Kafka 集群中,每一台服务器被称为一个 Broker 节点。当系统压力变大时,只需向集群中添加新的 Broker 节点,并将现有的分区重新分配(Rebalance)到新机器上,整个系统的处理能力就能随之线性增长。这种水平扩展能力是单机架构无法比拟的。
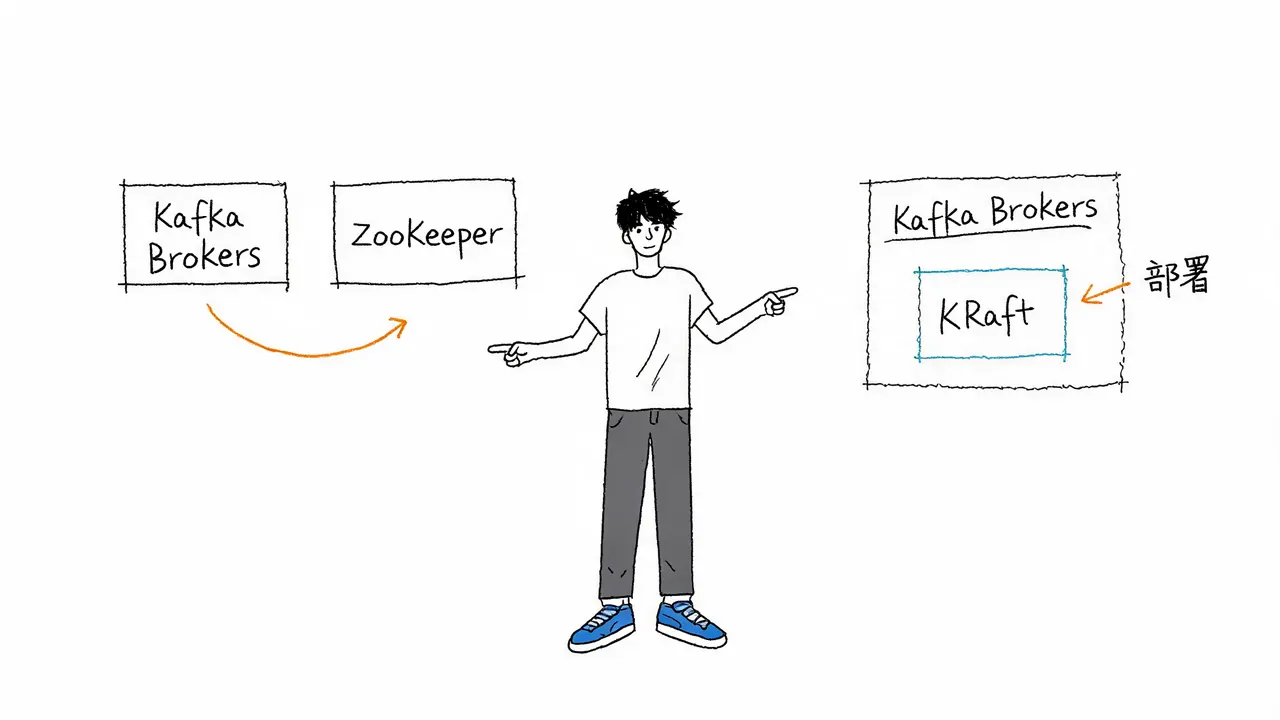
集群协调者:从 ZooKeeper 到 KRaft
这么多台机器协同工作,谁来负责指挥和记账?
- 传统架构:在经典的 Kafka 架构中,这个角色由 ZooKeeper 集群扮演。它负责记录哪些机器还活着、哪个分区的主节点在哪台机器上。
- 现代架构:在较新的 Kafka 版本中,协调工作被内置的 KRaft 机制接管。Kafka 不再依赖外部的 ZooKeeper,这使得集群的部署和运维变得更加清晰、简洁。
总结:何时选择集群?
集群并非万能,它也有自己的适用边界:
- 单机场景:如果你只是在进行本地代码调试、运行单元测试,或者业务流量非常小,强行上集群反而会增加运维负担和机器成本。此时,单机部署是最合理的选择。
- 集群场景:只有当你的数据量大到单机存不下、业务重要到不能容忍哪怕一分钟的宕机,或者并发高到单机扛不住时,集群才是必然的选择。
Kafka 搞集群,从来不是因为单机能力不行,而是为了打破单台机器的物理上限,守住数据不丢的容灾底线。理解了这一点,你就能明白分布式系统的本质:用群体的冗余和协作,去对抗单点的脆弱和极限。