下一炉的原料不是数据是经验:算力如何换取模型进化的闭环
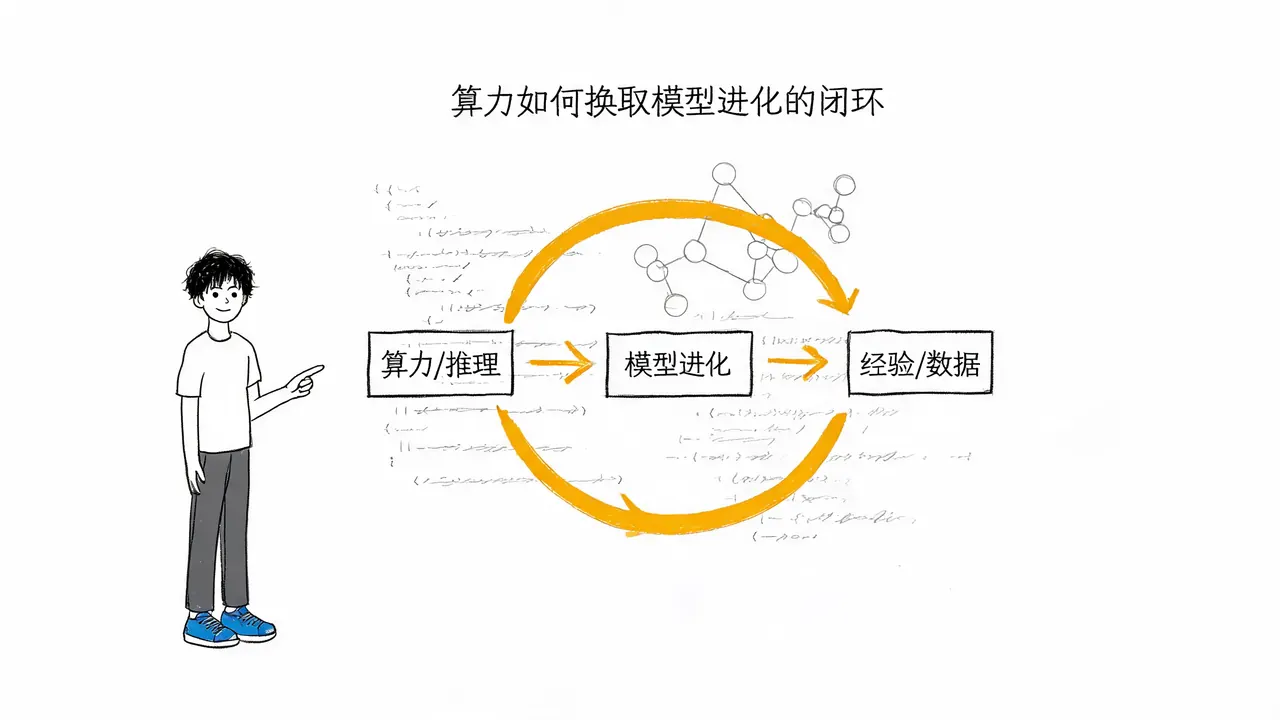
人类写下的高质量文本正逐渐被训练殆尽,下一代大模型的原料必须依靠自身生成。许多人认为这是“互联网没数据了”,但这并不准确。互联网上的文字依然海量,真正的问题在于:合法、干净、高质量且覆盖长尾场景的数据越来越昂贵。
稀缺的从来不是文本本身,而是带结果标签的文本。互联网上有无穷多的观点,但极少有记录能告诉你“这句话后来被证明是对的”。绝大多数内容只有观点,没有结局。模型从文本中习得的是“人们通常怎么说”,却难以学到“这么说之后结果如何”。
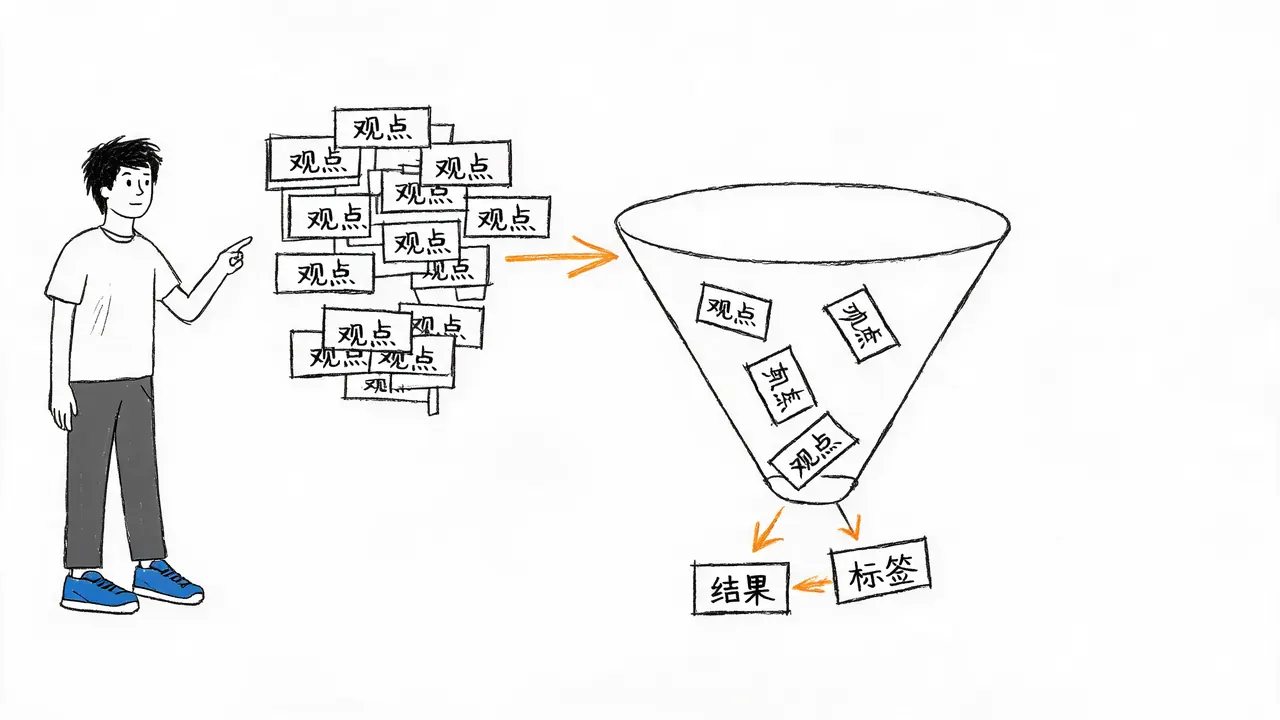
这就好比教科书读完了,接下来只能靠做题。而做题比读书慢得多,也贵得多,因为每一道题都需要有人批改。
合成数据的陷阱:没有裁判的复印
关于新原料的来源,一个流传甚广的答案是“让模型互相训练”,即用上一代生成的内容去训练下一代。这个说法只对了一半。
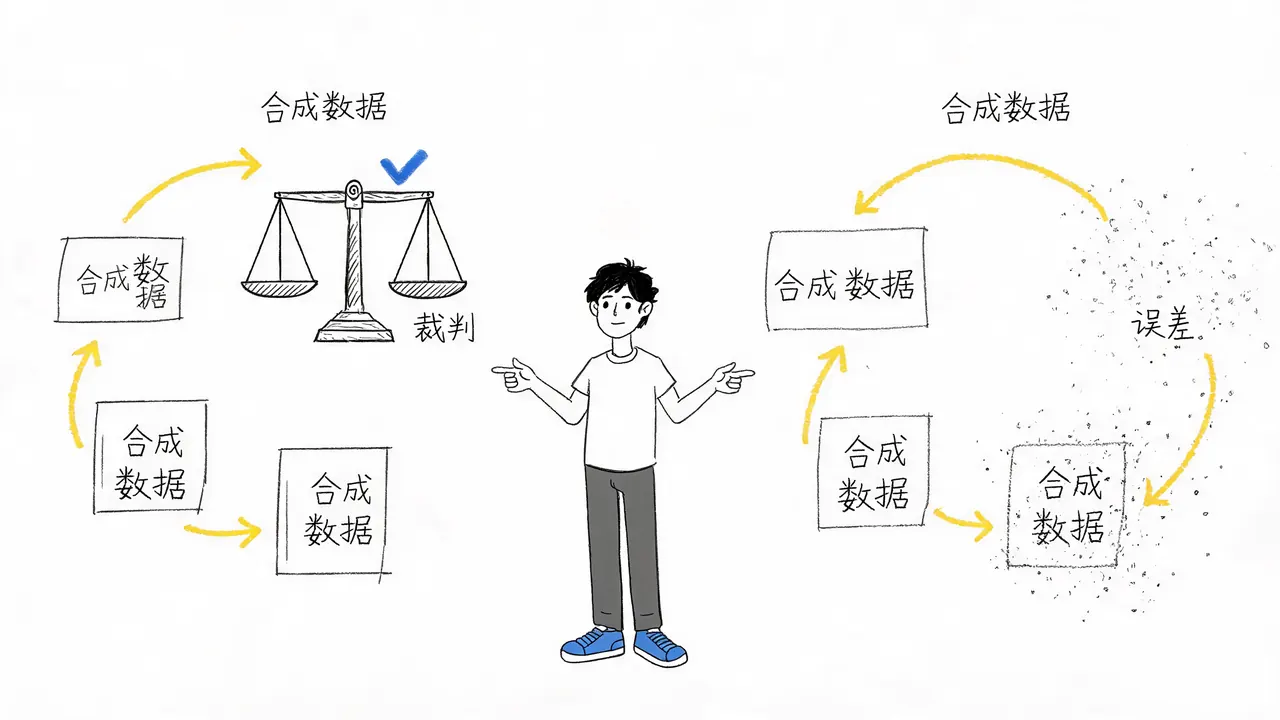
如果不加筛选地这样做,存在明确的风险,学界称之为模型崩溃(Model Collapse)。直接使用生成数据训练,会导致长尾信息丢失、偏差累积,模型一代比一代窄,最终越训越糊涂。
道理并不复杂:你把一张图复印一遍,再拿复印件去复印,印上十几代,原图就没了。误差是会累积的。
那么,为什么在有些地方合成数据又确实非常有用?关键差别只有一个:有没有一个能判对错的裁判。
- 代码领域:代码能不能跑,跑一下就知道。
- 数学领域:题目对不对,验算一下就知道。
- 任务执行:任务完没完成,执行一遍就知道。
在这些有明确裁判的领域,合成数据就是真金白银的原料。而在没有裁判的领域,合成数据只是在重复一代代的复印误差。因此,判断一个领域能否靠自己造原料,不看模型多强,而看这个领域有没有一个不会看错的裁判。
经验轨迹:真正的新原料
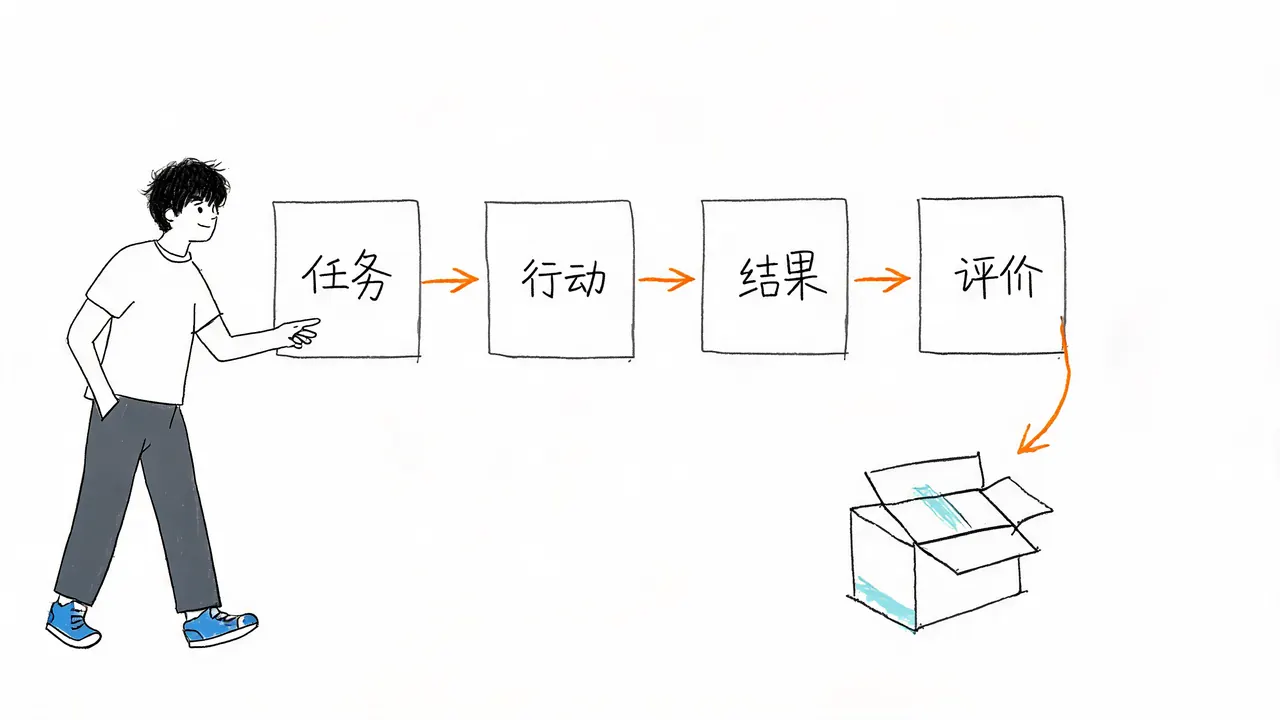
真正的新原料是经验轨迹(Experience Trajectories)。
这是一条由“任务、行动、结果、评价”四段连在一起的完整记录。例如,一个人在真实工作中用模型完成一件事:
- 他提了什么需求?
- 模型做了什么?
- 结果成没成?
- 失败在哪?
- 后来被怎么修改的?
这条完整的轨迹才是下一代的原料。单看模型输出的那段文字,价值有限;有价值的是它后面跟着的那个结局。
这就引出一件被严重低估的事:大规模应用本身就是数据资产。
一个没有大规模真实使用的模型,连原料都拿不到。它可以很聪明,但没有任何人在真实场景里替它验证过“什么该做,什么不该做”。因此,这一轮的先发优势不在参数量,而在使用量。谁的模型正在被几千万人拿去干真活,谁就在源源不断地攒下一代的原料。
算力的新角色:从训练到采购原料
大规模使用需要消耗推理算力。之前我们讨论过,一支团队的算力要同时喂三张嘴:训练、实验、对外推理。现在多了一层含义:分给推理的那一份算力,不只是在做生意,它同时在采购下一代的原料。
这里有一个很多人会想反的地方:新范式听起来像是不用堆算力了,改成让模型自己学。恰恰相反,强化学习需要海量的试错回合。模型自己去试一遍,被打分,再更新一点点,然后再试。这个过程要跑成千上万次,它比预训练还要费算力。
准确的说法是:新范式不是让算力变次要,而是让算力更重要,且变重要的方式变了。
- 过去:算力买的是“训一次模型”,一年一两次的事。
- 现在:算力买的是“模型每天能做多少次实验”。
我们之前把训练大模型比作开炉炼丹,“炉”指每一次训练或推理实验,“炉次”就是实验的次数。以前是一支团队一年开几炉,以后是一个模型一天开几炉。模型不下班,它可以24小时不停地出题、尝试、被打分、修正。这个循环转得多快,只取决于你给它多少算力。
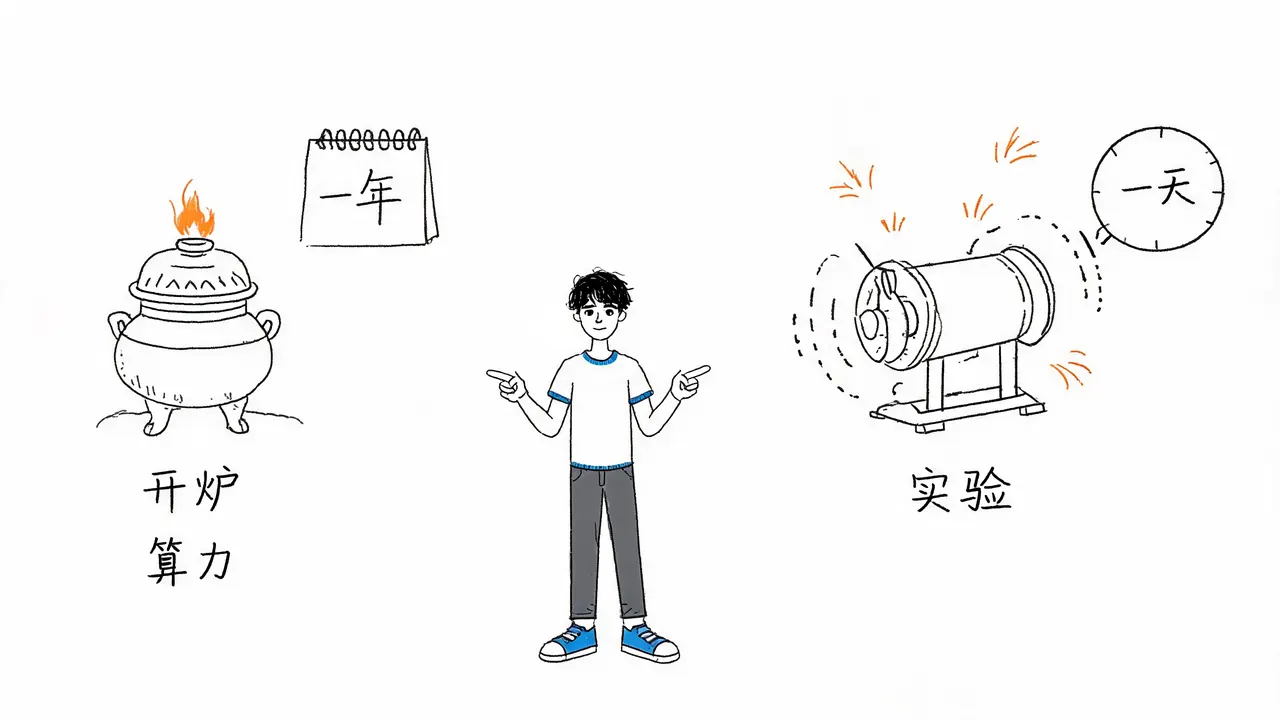
所以,算力是命门这一判断不但没有过期,反而更硬了。原来今天算力是命门,接下来算力只会更是命门。
自动化实验室与验证器边界
如果这个循环一直转下去会怎样?先说清楚,这一页是推演,不是已经发生的事实。
理想形态不是一座更大的炉子,而是一座自动化实验室:能自己提配方、自己开炉、自己验单、记住失败,并且安全地修改下一炉。一旦这个闭环真的转起来,速度会和今天完全不在一个量级。
- 更强的模型产生更高质量的经验。
- 更高质量的经验又训出更强的模型。
- 算力决定这个循环转得多快。
这是飞轮效应。到那时候,领先者的领先可能会变得很难追。
但这个闭环的瓶颈不在模型智力,而在验证器(Verifier)。能被可靠验证的任务范围有多大,自主学习的边界就有多大。
- 围棋:之所以能靠自我对弈走通,是因为它有一个永远不会看错的裁判——规则明确,胜负清晰,一步都不会判错。
- 开放世界:现在还没有这样的裁判。一个商业方案好不好、一段文案合不合适、一个决策对不对,往往几个月后才知道,甚至永远不会有确定答案。
所以,真正该盯着的不是模型又涨了几分,而是可靠验证的边界推到了哪。那条边界推进一格,自主学习的地盘就大一块。
从炼金术到化学:大模型的青春期
最后,回到一开始那个没答完的问题:炼金术后来变成了化学,它是怎么变的?靠两件事:
- 拉瓦锡把天平搬进了实验室:在他之前,炼金术士描述结果靠颜色、气味、形态;拉瓦锡开始称重,反应前称一次,反应后称一次。从那一刻起,实验第一次可以被定量、被对照、被重复。
- 门捷列夫画出了周期表:在他之前,元素是一堆孤立的事实;周期表出来之后,人类第一次可以预测“这个位置应该有一种元素,它大概长这样”,后来真的找到了。
可定量、可预测,这两件事一起做到,炼金术就成了化学。
那大模型现在到哪一步了?
- 天平已经有了:评测体系、损失曲线、消融实验都是在“称重”。虽然还很粗糙,现在的评测连推理时愿意烧多少算力这一位都还没测到。
- 周期表有雏形了:就是规模法则(Scaling Laws)。它能预测投入多少算力,损失大概落在哪。但它也很粗,能预测损失,预测不了能力,更预测不了哪一次会冒出什么新东西。
所以,这门手艺现在的位置很清楚:它有了自己的第一架天平,和第一张很潦草的周期表。
这就是这五集最后攒下的那句话:我们不是在围观一门玄学,我们是在围观一门学科的青春期。
那你觉得,这一轮先出现的会是它的天平,还是它的周期表?