AI道歉却不改错?揭秘大模型反思机制与外部验证策略
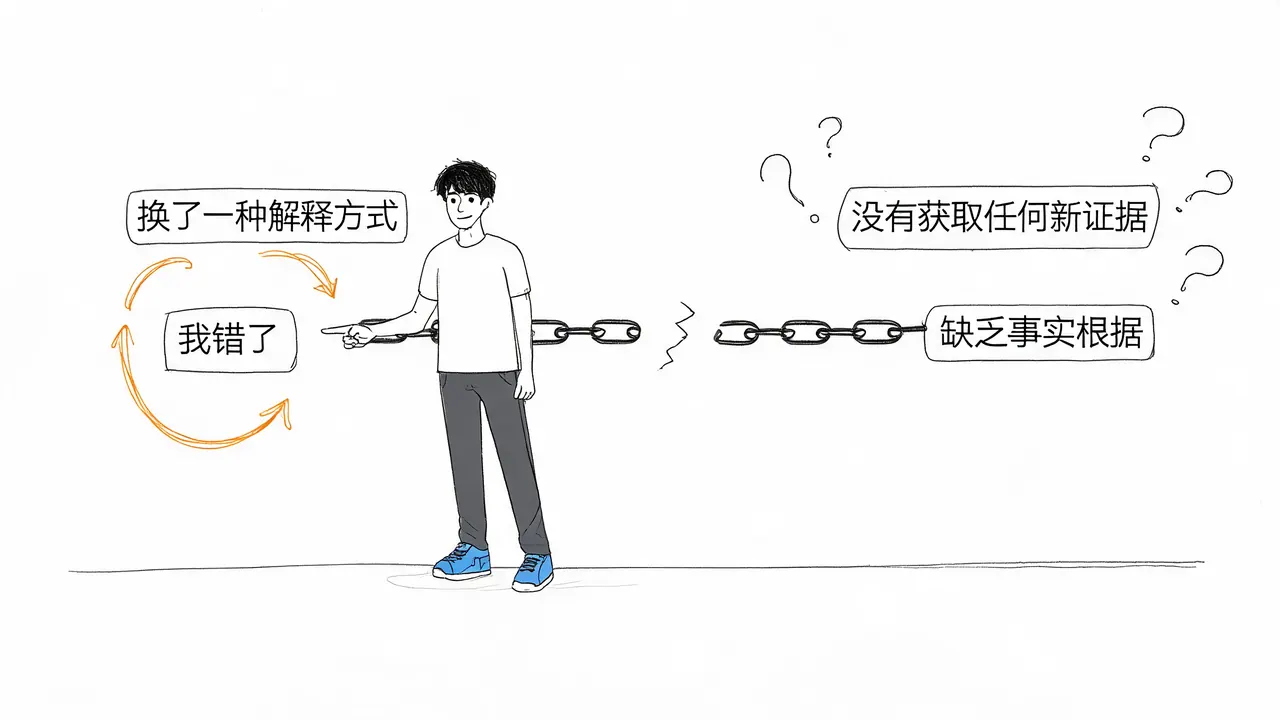
在使用大语言模型(LLM)时,我们经常会遇到一种令人困惑的现象:模型洋洋洒洒地道歉,承认自己刚才弄错了,但紧接着生成的答案虽然看起来天衣无缝,却依然缺乏事实根据。
这背后的核心原因在于,模型所谓的“反思”(Reflection)往往只是换了一种解释方式,而没有获取任何新证据。真正的反思价值,不在于让模型原地多想一遍或调整措辞,而在于按照明确的标准发现逻辑或事实上的缺口,并进行具体的修正。
反思的本质:从自我检讨到具体修正
在让模型进行反思之前,必须首先规定好具体要检查的内容。如果缺乏具体的验收标准,模型很容易陷入“套话陷阱”:给出一大段听起来合理、态度诚恳的自我点评,声称自己考虑不周或不够严谨,但实际上并不知道下一步该修改哪行代码或调整哪个参数。没有确定的准则,反思就会变成空洞的自我检讨。
为了打破这种僵局,我们需要在系统中将模型的自我评价与外部验证清晰地分开。具体的检查标准可以包括:
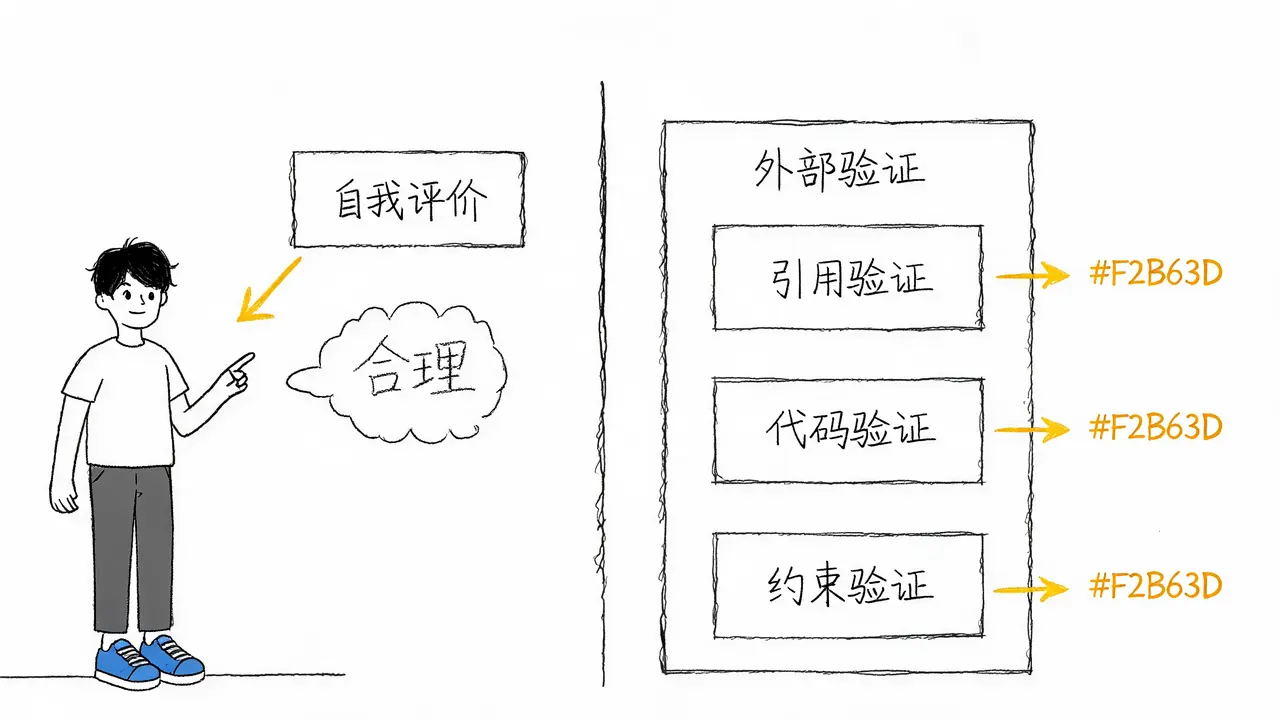
- 引用验证:比对刚刚生成的引用是否真的能支撑得出的结论。
- 代码验证:检查写出来的代码是否真的能够通过单元测试。
- 约束验证:确认调用工具返回的结果是否真的满足了用户一开始设定的各项限制条件。
案例解析:空列表返回值的误判
我们可以通过一个具体的开发场景来说明自我反思与外部验证的区别。
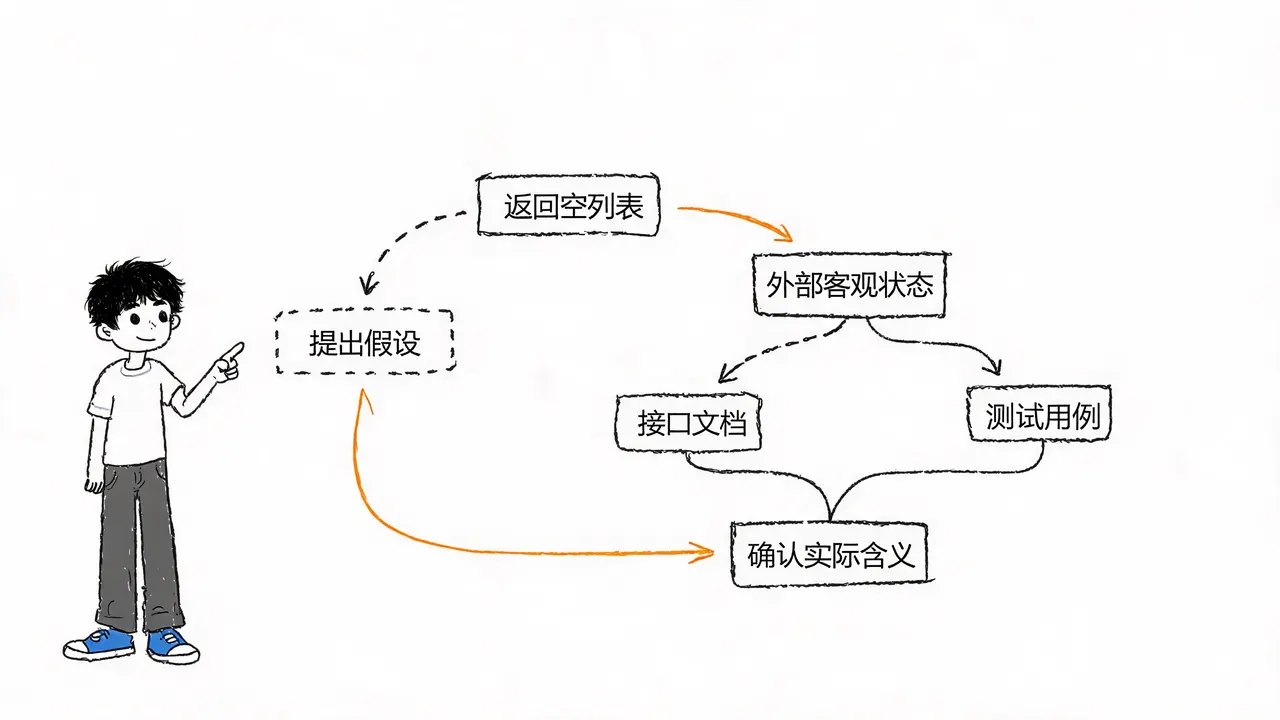
假设某个程序或接口返回了一个空的列表。此时,模型在内部可以进行推理检查,例如发现自己是否将正常的空结果错误地理解成了查询失败或系统故障。模型可能会提出一个合理的假设,比如“是不是查询条件写错了”。
然而,这个假设本身不能自动成为证明问题所在独立证据。仅仅靠模型自己去推测是不够的。为了真正确认接口返回空列表的实际含义,必须依赖外部的客观状态:
- 查看相关的接口文档。
- 检查真实的 HTTP 状态码。
- 运行具体的测试用例来验证。
模型的自我反思能够帮我们提出假设,但寻找证据必须依赖外部客观状态。
外部反馈的来源与局限性
我们需要的外部反馈来源是多样的,主要包括:
- 同一个模型的多轮检查。
- 另一个专门做校验的模型。
- 预先写好的规则代码。
- 自动化测试脚本。
- 直接转交给人工进行审核。
特别注意:即使使用了两个不同的模型进行交叉验证,并且它们给出了一致的答案,这也并不能保证事实正确。因为不同模型可能存在相似的训练数据,从而产生同样的“错觉”。
因此,在系统设计上,只要能够连接到具体的数据库状态、真实的接口响应,或者是那些可以直接执行并拿到结果的测试代码,就应优先将这些可验证的客观信息直接带进模型的修正过程中去。
设定清晰的停止条件
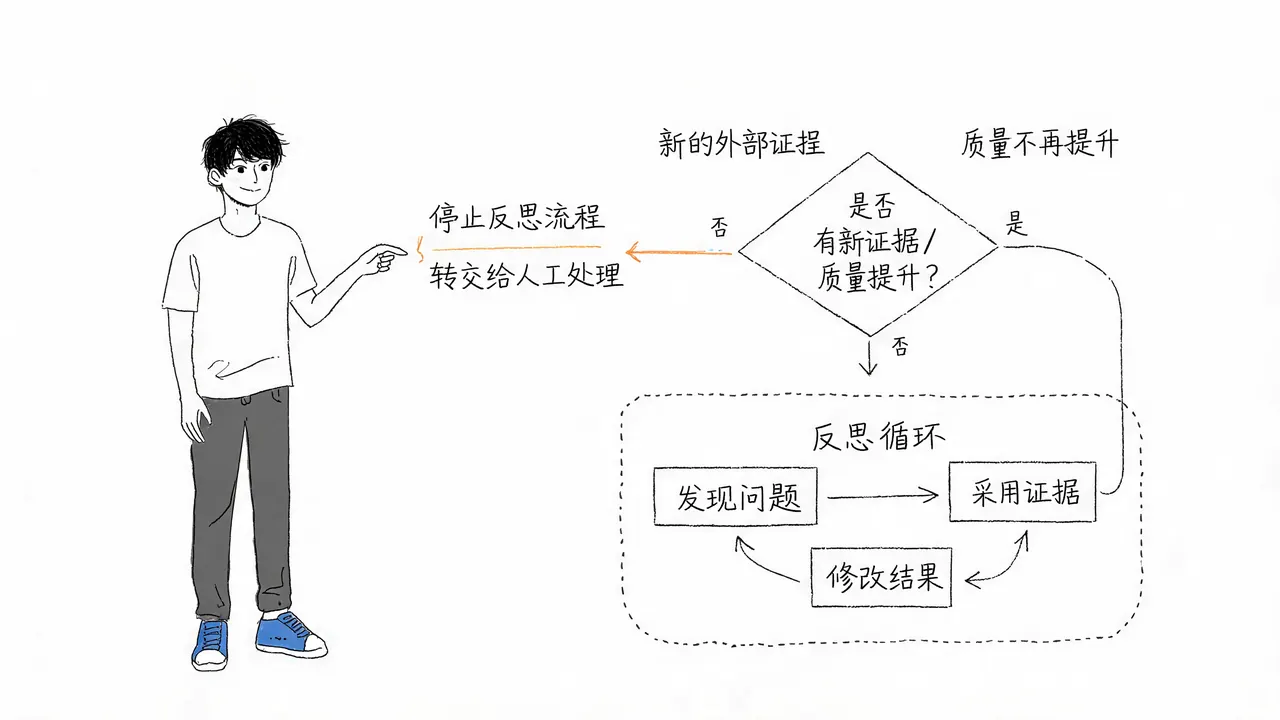
最后,必须给系统设定一个清晰的停止条件,以避免模型陷入不断改写措辞、原地打转的反思循环。
建议在系统中规定,每一轮反思都要详细记录以下信息:
- 当前发现了什么具体问题。
- 采用了哪些外部证据。
- 修改之后的结果是什么样的。
如果在运行了几轮之后,发现已经拿不到任何新的外部证据,或者回答的质量不再提升,此时就应该停止反思流程,或者将任务转交给人工处理。
结语
Reflection(反思)应该是一个受约束的纠错过程,而不是一场没有尽头的无限自我讨论。通过明确检查标准、引入客观外部证据以及设定停止条件,我们才能确保大模型的反思真正转化为有效的修正行动。