为什么微服务一多,就必须做链路追踪?
简单来说,链路追踪就是给分布式系统装上的一双“全局透视眼”。
当你的系统从一个大单体应用拆分成几十个甚至上百个微服务时,一个用户请求就要经过网关、认证、订单、库存、支付等十几个节点。如果没有链路追踪,一旦出错,你根本不知道是哪一环搞砸了。
那传统看日志的方法为什么失效了?它到底靠什么机制把散落的节点串起来?又在什么情况下其实不需要用它?今天我们把这套分布式排障的核心逻辑讲透。
``传统日志排障为何失效?
很多人觉得,每个服务自己记好日志,出了问题挨个查不就行了?
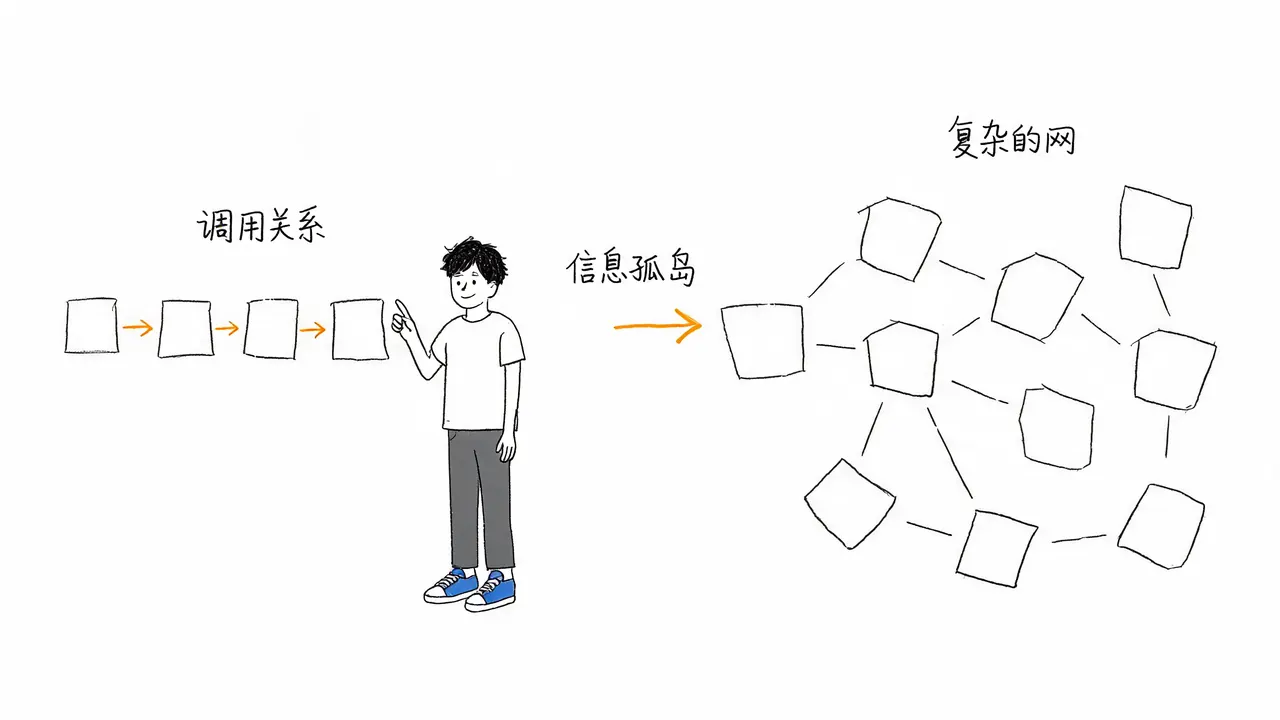
在单体应用或者只有两三个服务的时候,这招确实管用。但微服务一多,服务之间的调用关系就从一条直线变成了一张复杂的网。一个下单请求,可能同时触发了库存扣减、积分增加和消息推送。
如果只看单个服务的本地日志,你看到的只是一个个信息孤岛,根本拼凑不出这个请求完整的来龙去脉。这就引出了微服务变多后的第一个致命痛点:故障定位如同大海捞针。
链路追踪解决的核心痛点
1. 快速锁定故障点
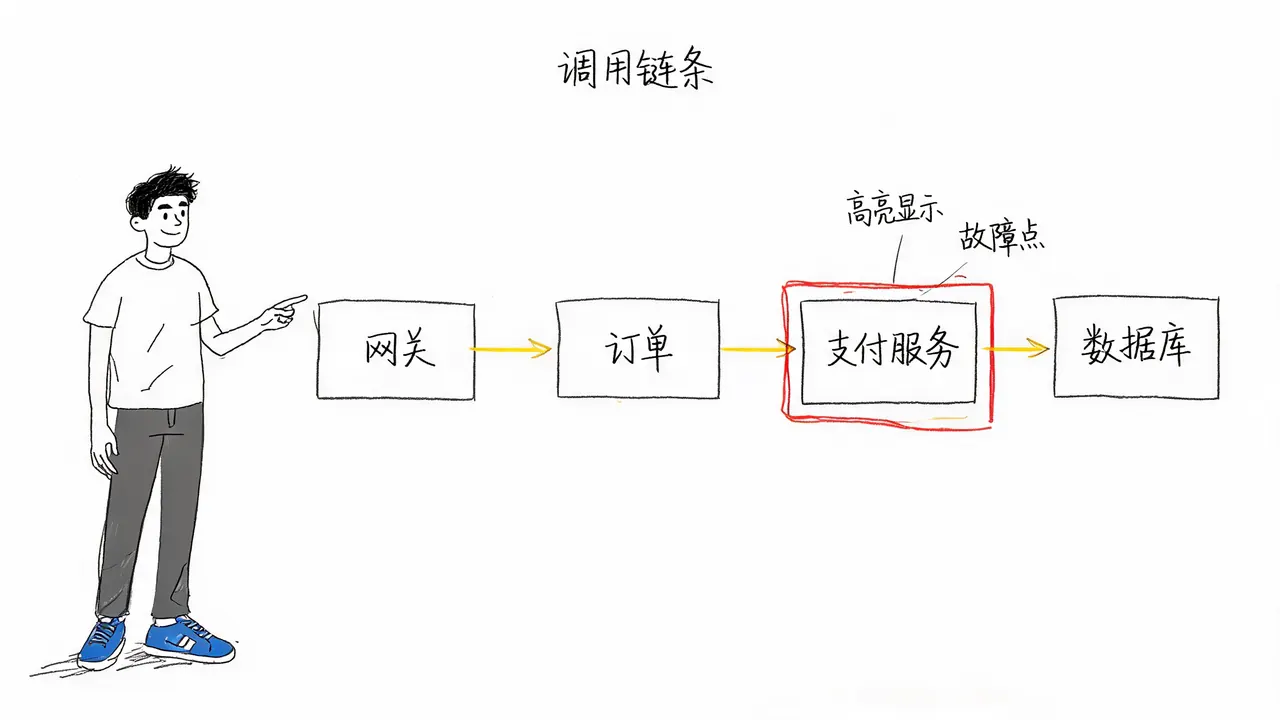
假设用户反馈下单失败,前端只返回了一个“系统异常”。运维人员去查网关,网关说请求正常转发了;去查订单服务,订单服务说调用支付服务超时了;再去查支付服务,发现是底层的数据库连接池满了。
如果没有链路追踪,排查这个问题需要登录多台服务器,靠人工比对时间戳来拆解。而有了链路追踪,整个调用链条上的第一故障点会直接高亮显示,一秒钟就能锁定是谁的问题。
2. 揪出隐蔽的性能瓶颈
除了找故障,链路追踪还能揪出隐蔽的性能瓶颈。有时候系统整体响应很慢,但你挨个检查每个微服务,发现它们的单次处理都只要几十毫秒,各项指标也很正常。
问题出在哪?出在跨服务的串行等待上。A服务调用B,B再调用C,中间还夹杂着网络传输和重试逻辑。链路追踪会把每个节点上的耗时精确记录下来,你一眼就能看出,原本以为只要 200 毫秒的请求,其实有 800 毫秒都卡在了某个不起眼的第三方接口调用上。
核心机制:TraceID 与 Span
那它是怎么做到把散落在几十台机器上的数据串联起来的呢?核心靠的是两个标准组件:TraceID 和 Span。
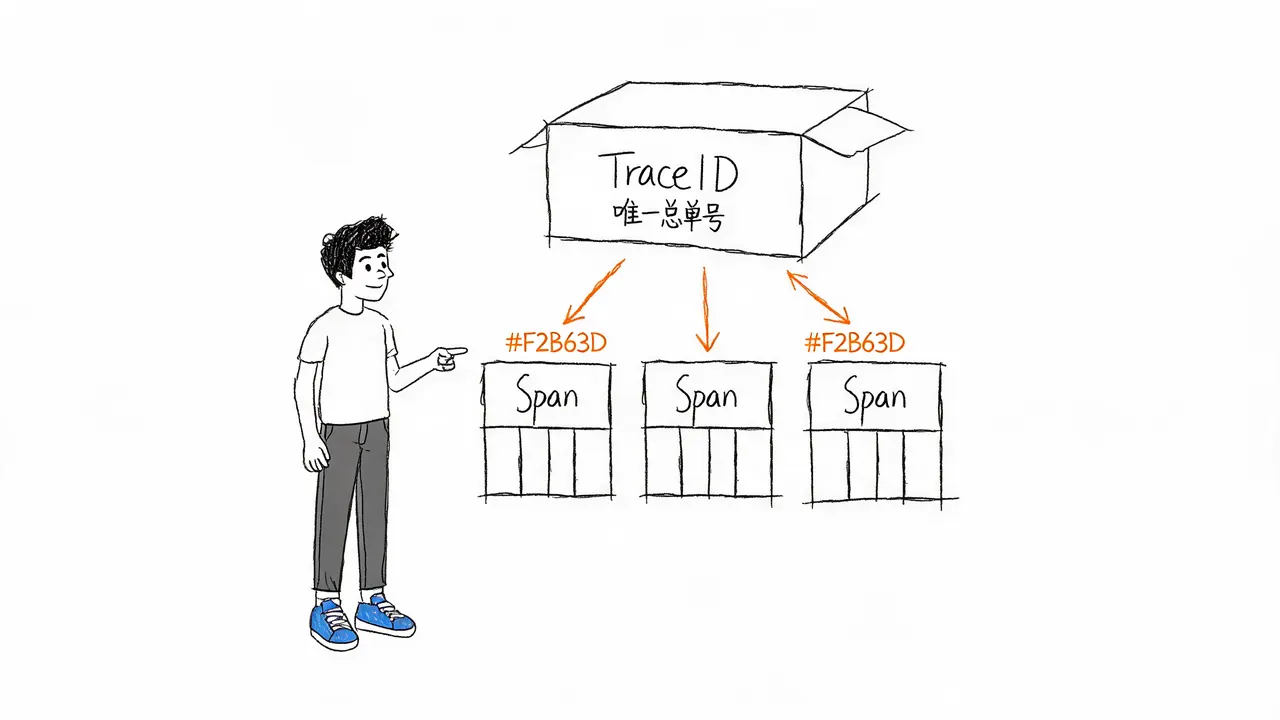
你可以把 TraceID 想象成一个快递包裹的唯一总单号。当用户的请求进入系统的第一个网关时,系统就会给它生成一个全局唯一的 TraceID。之后这个请求无论流转到订单、库存还是支付服务,这个总单号都会跟着上下文一路传递。
而 Span 就是包裹在每个中转站的处理记录。每个服务在接收到请求时,会生成一个属于自己的 Span,记录下处理了什么操作、花了多少时间、有没有报错。
最后,把这些带有同一个总单号的 Span 数据统一汇总到分析平台,就能还原出完整的调用树。
适用场景与性能权衡
不过,链路追踪也不是在所有场景下都必须上。
- 无需引入的场景:如果你的系统还是传统的单体架构,或者微服务数量极少、调用关系非常简单,强行引入链路追踪反而是一种负担。因为每一次生成标识、传递上下文和上报数据,都会消耗一定的计算和网络资源。
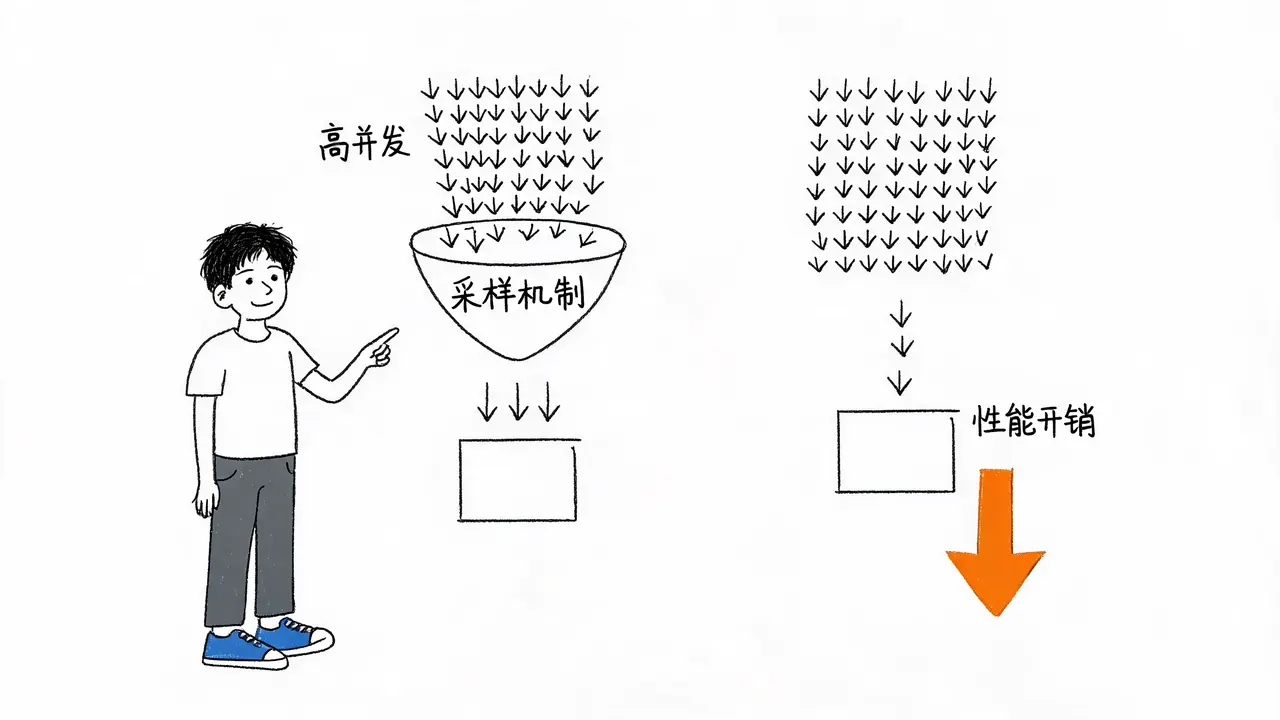
- 高并发场景的优化:在请求量极大的高并发场景下,通常还会采用采样机制,比如只追踪 10% 的请求,以此来平衡监控需求和系统性能开销。
结语
从单体到微服务,架构的拆分换来了开发的敏捷和系统的弹性,但也把复杂性推给了运维和排障。
链路追踪本质上就是用一套标准化的数据契约,把打散的分布式系统重新在逻辑上缝合起来。看懂了这条链路,才算真正拥有了驾驭复杂分布式架构的全局视角。