什么是注意力机制?为什么大模型离不开它?
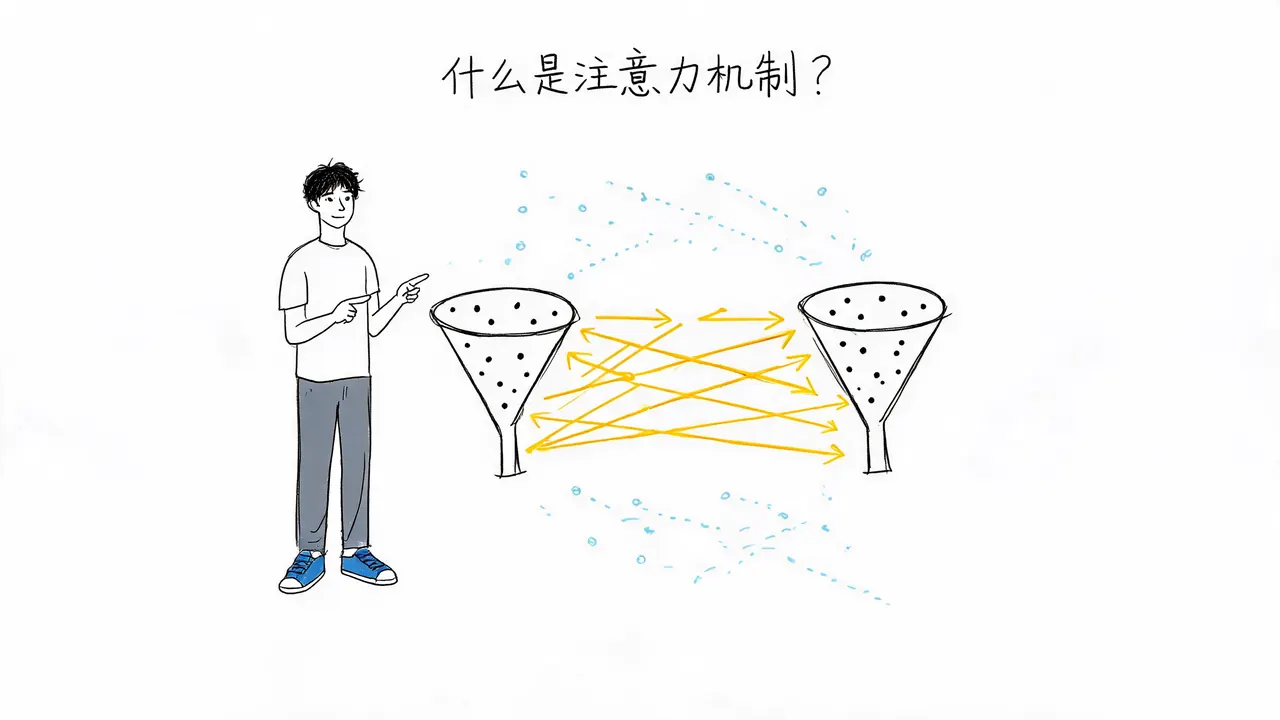
注意力机制本质上是人工智能在处理信息时,用来计算不同信息片段之间关联程度和重要性的一套数学规则。
过去,人们常误以为 AI 像人类一样拥有“注意力”这种心理活动。事实上,AI 并没有意识,它只是在执行极其精密的数学打分。正是这套打分规则,让大模型从死记硬背的机器,进化为能够理解上下文的智能体。
`` 是摘要与正文的分隔标记,请保留。早期语言模型的困境:线性读取的局限
要理解注意力机制的重要性,首先需要回顾在没有它之前,AI 是如何工作的。
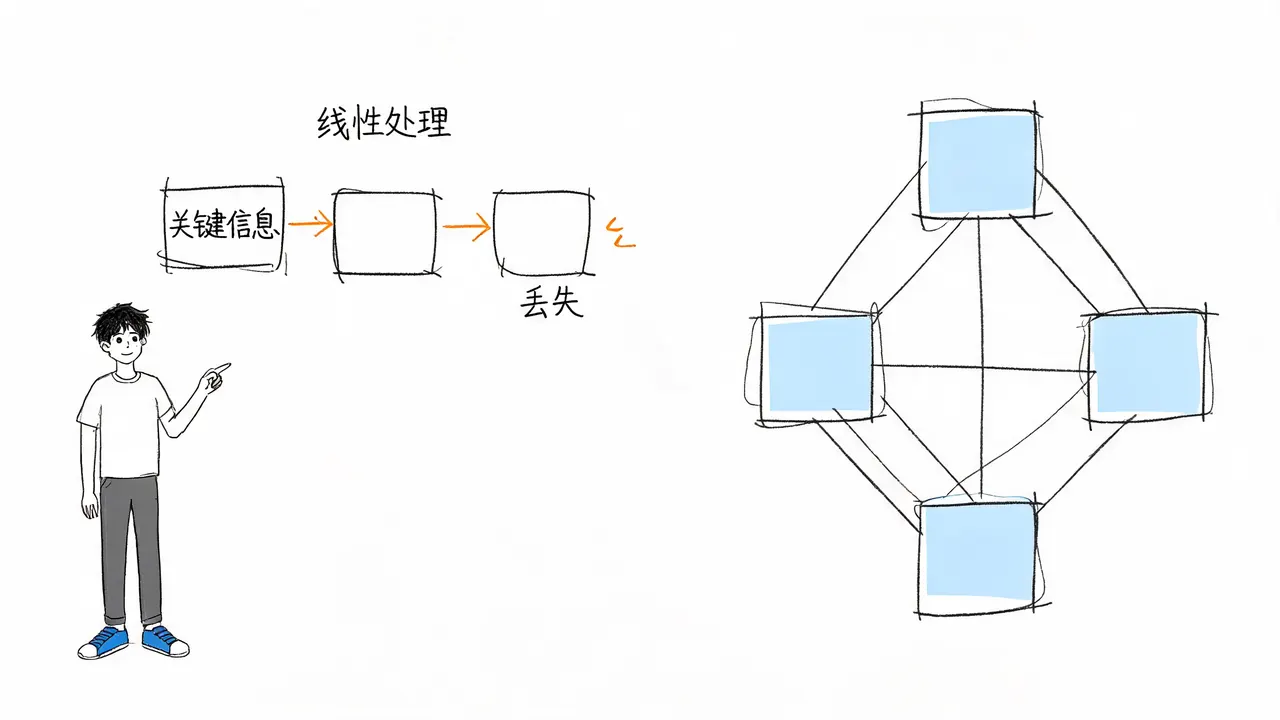
早期的语言模型采用的是逐字阅读的流水线模式。这就像阅读一本书时,只能从第一个字读到最后一个字。当读到后文时,前文的记忆会逐渐模糊。
- 短文本尚可:如果句子很短,这种线性处理方式尚能应付。
- 长文本失效:一旦遇到长篇文章,AI 读到结尾时,往往已经忘记了开头在说什么。
这种线性处理方式直接锁死了 AI 理解长文本的能力,导致关键信息在传输过程中丢失。
注意力机制:从逐字阅读到全局统筹
注意力机制彻底打破了这种线性限制,让 AI 从“逐字阅读”转变为“全局统筹”。
我们可以用一个生动的比喻来理解这一过程:
想象你在看一张大合影。你不需要从左到右挨个审视每个人的脸,而是一眼看到所有人。当有人问“谁戴着红帽子”时,你的大脑会自动给戴红帽子的人分配极高的关注度,而忽略背景中的树木或其他无关元素。
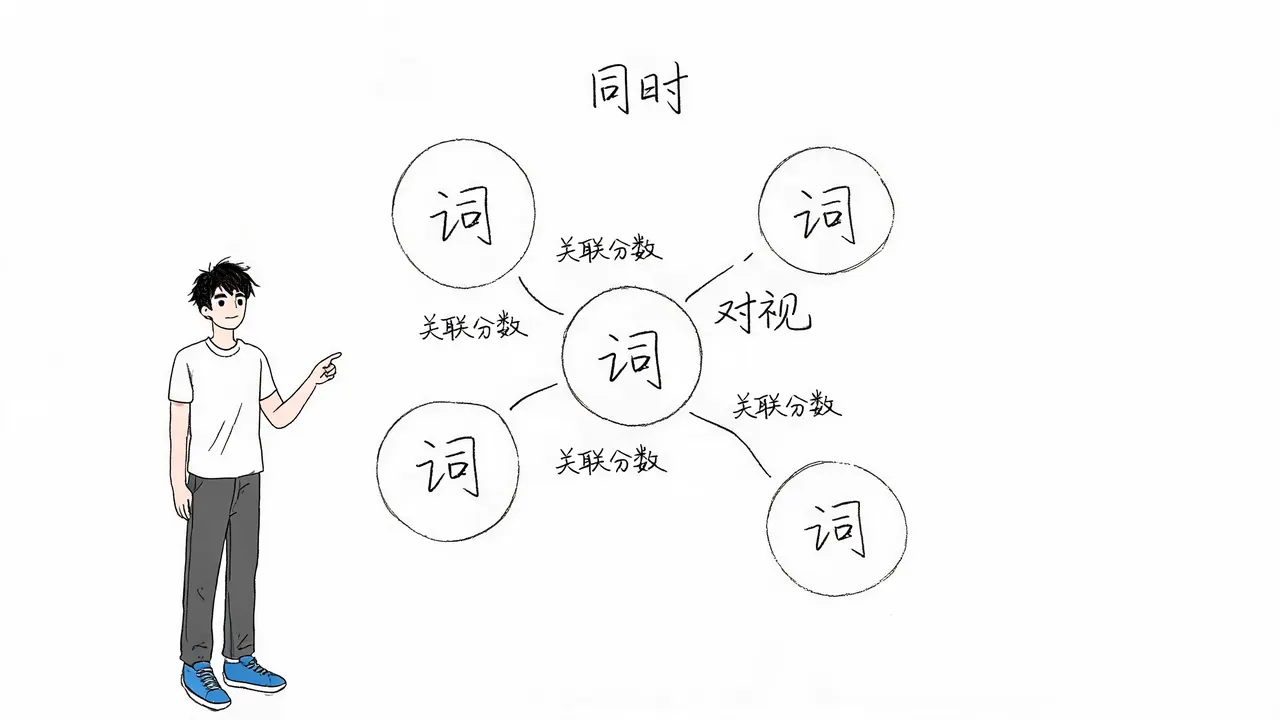
在 AI 处理文本时,注意力机制让句子里的每一个词同时和句子里的所有其他词“对视”,并计算出一个关联分数。这个分数在技术上被称为权重。这种自己和自己计算关联的机制,被称为自注意力(Self-Attention)。
解决一词多义与上下文依赖
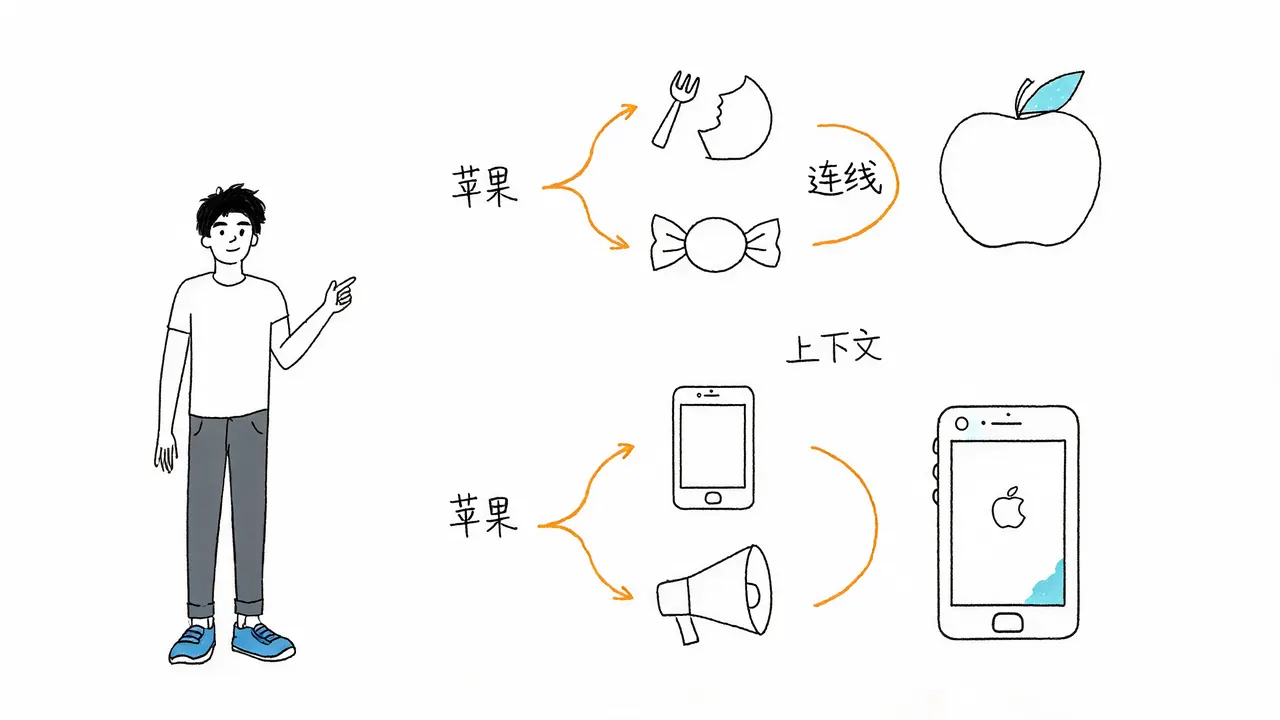
自注意力机制能精准解决语言中的一词多义和上下文依赖问题。以“苹果”这个词为例:
- 当它与“吃”、“甜”等词连线时,权重指向水果。
- 当它与“手机”、“发布”等词连线时,权重指向科技产品。
通过这种全局连线,每个词在输入模型的那一刻,就已经携带了完整的上下文语境。AI 再也不会因为读得太远而丢失关键信息。
为什么大模型绝对离不开它?
注意力机制之所以成为大模型的核心,主要归功于以下两大优势:
1. 并行计算能力
由于所有词是同时计算关联的,不需要排队等待,这使得 AI 可以利用成千上万张显卡进行并行计算。这种架构极大地提升了训练效率,从而推动了互联网级别的海量数据处理。
2. 超长上下文处理能力
得益于全局关联的计算方式,大模型具备了处理超长上下文的能力。无论是写几十万字的小说,还是分析几百页的财报,只要算力跟得上,它都能记住前文的每一个细节。
可以说,没有注意力机制,就没有今天大模型的涌现智能。
物理边界:计算成本的挑战
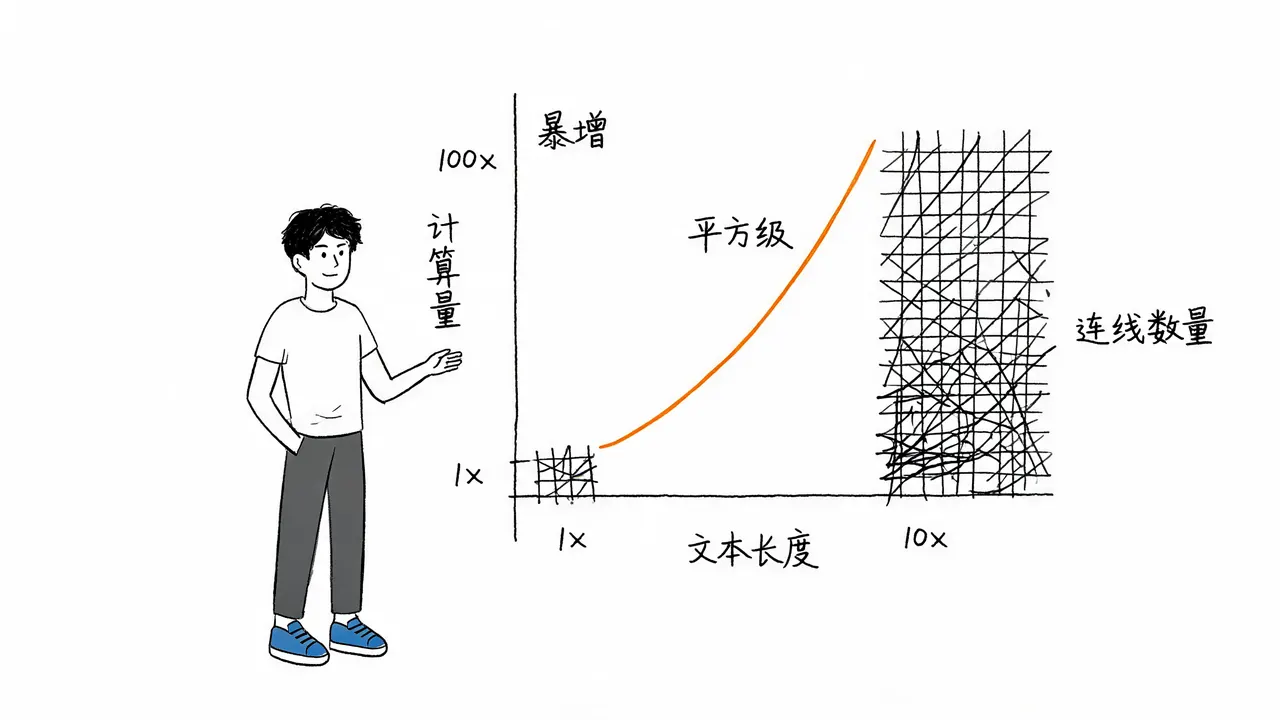
尽管注意力机制强大,但它也存在一个明显的物理边界:计算成本会随着文本长度呈平方级暴增。
- 如果文本长度增加 10 倍;
- 词与词之间需要计算的连线数量就会增加 100 倍。
这就是为什么大模型在处理百万字超长文本时,不仅响应速度会变慢,还会遇到上下文窗口的极限。
未来展望:稀疏注意力算法
为了解决算力消耗过高的问题,现在的工程师们正在研发各种稀疏注意力算法。其目标是在保留全局理解能力的同时,降低算力消耗,突破当前的性能瓶颈。
结语
从逐字读取的流水线,到全局连线的关系网,注意力机制改变了机器理解世界的方式。它让我们看到,真正的智能不一定需要模仿人类的意识。有时候,只要把事物之间的关联计算得足够精准,量变就会引发质变。