深入理解 WebDriver:浏览器自动化的核心标准与架构解析
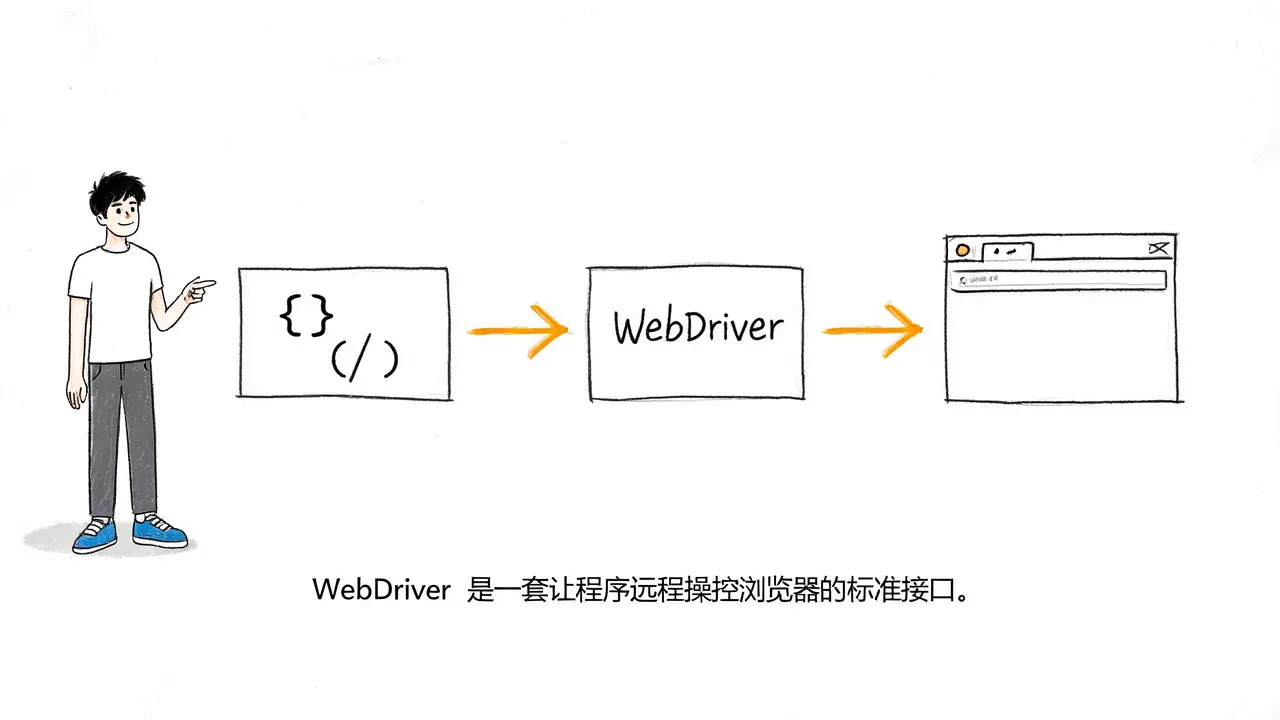
WebDriver 是一套让程序远程操控浏览器的标准接口。它并不直接操作网页元素,而是如同为浏览器安装了一个“遥控器”,使自动化脚本能够指示浏览器打开特定网址、点击按钮、输入文字,并读取页面显示的内容。作为 Selenium 的核心组件,WebDriver 也是 W3C 制定的官方标准,几乎所有主流浏览器都原生支持这一协议。
`` 是摘要与正文的分隔标记,请保留。解决浏览器自动化碎片化问题
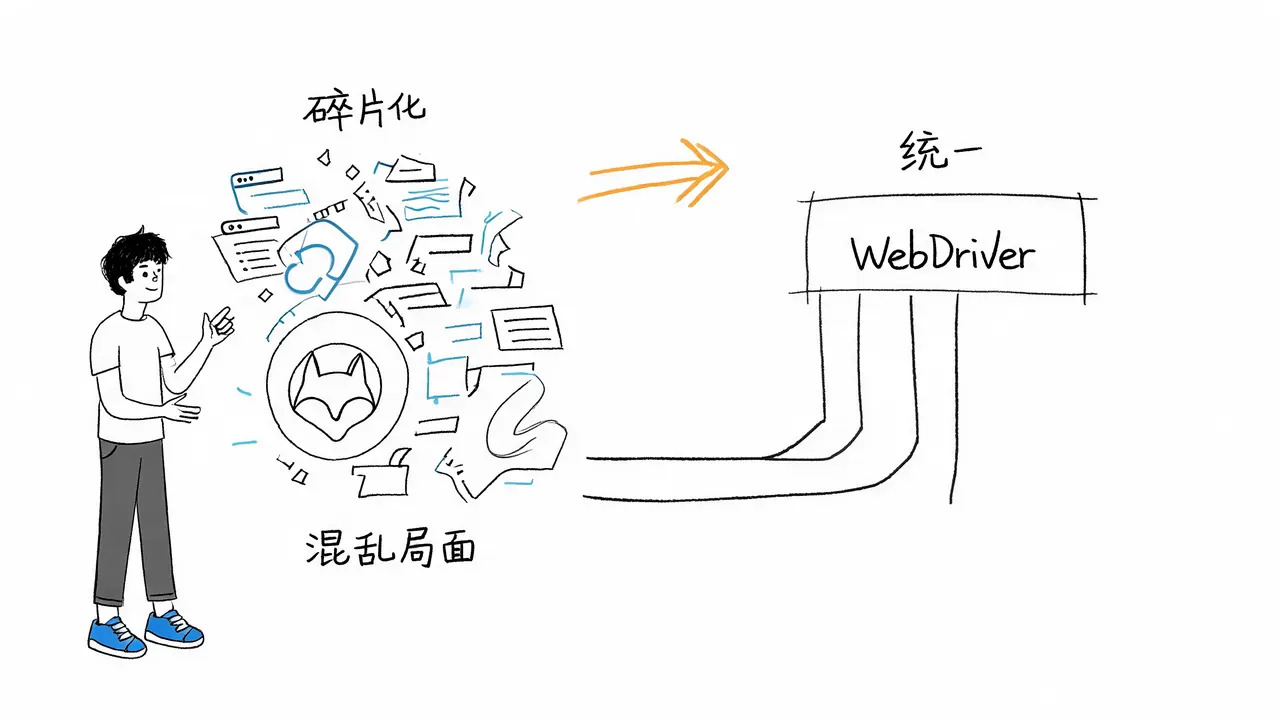
要理解 WebDriver 的价值,首先需要回顾早期浏览器自动化的困境。在 WebDriver 出现之前,各家浏览器拥有各自的私有自动化方案:老版本 IE 依赖 COM 接口,Firefox 早期则采用插件方式。这种碎片化导致开发者每更换一个浏览器,往往需要重写整套脚本,维护成本极高。
WebDriver 的出现旨在统一这一混乱局面。它定义了一套语言无关的协议,无论是 Python、Java、JavaScript 还是 C#,只要通过 HTTP 请求发送标准命令,就能驱动 Chrome、Firefox、Safari 或 Edge 执行相同的操作。这种“一次编写,处处运行”的能力,使得自动化测试、网页爬虫和端到端验证变得更加可靠和标准化。
WebDriver 的三层架构与工作原理
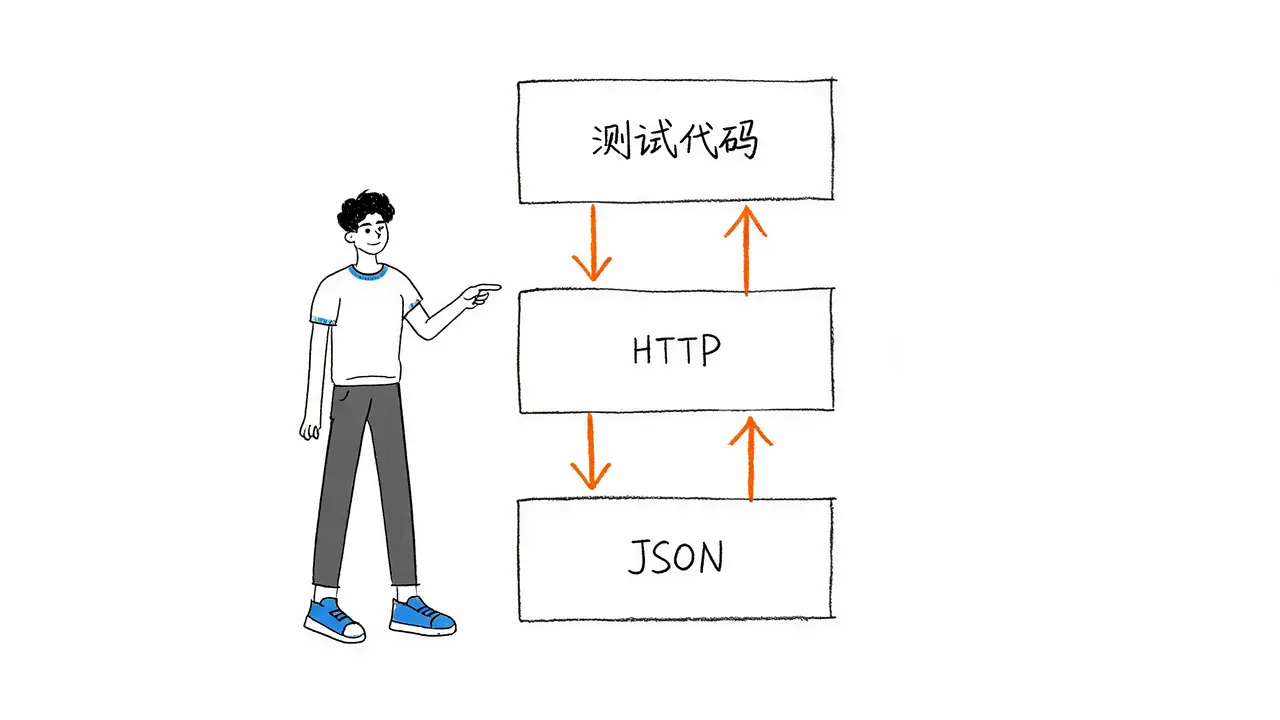
WebDriver 的工作机制基于清晰的三层架构设计:
- 顶层:测试代码 这是开发者编写的脚本,例如使用 Selenium 库编写的测试用例。
- 中间层:WebDriver 协议 本质上是基于 HTTP 的 RESTful API。每个操作对应一个特定的端点(Endpoint)。例如,导航到某个 URL 就是向特定地址发送 POST 请求。
- 底层:浏览器驱动
由浏览器厂商实现的具体驱动,如 Chrome 的
ChromeDriver或 Firefox 的GeckoDriver。它们作为小型本地服务器运行,接收协议指令后,将其转化为浏览器内部的原生自动化接口调用。
整个流程是:代码发出命令 $\rightarrow$ 驱动接收并执行 $\rightarrow$ 结果以 JSON 格式返回。
关键设计优势: WebDriver 不依赖 JavaScript 注入来操作页面,而是直接调用浏览器底层功能。这意味着它能模拟真实的用户行为,包括处理弹窗、文件上传、多窗口切换等 JavaScript 难以触及或无法完全模拟的场景。
WebDriver 与 DOM 操作的区别
初学者常混淆 WebDriver 与通过 JavaScript 执行的 DOM 操作(如使用 document.querySelector 点击按钮)。两者的核心区别在于:
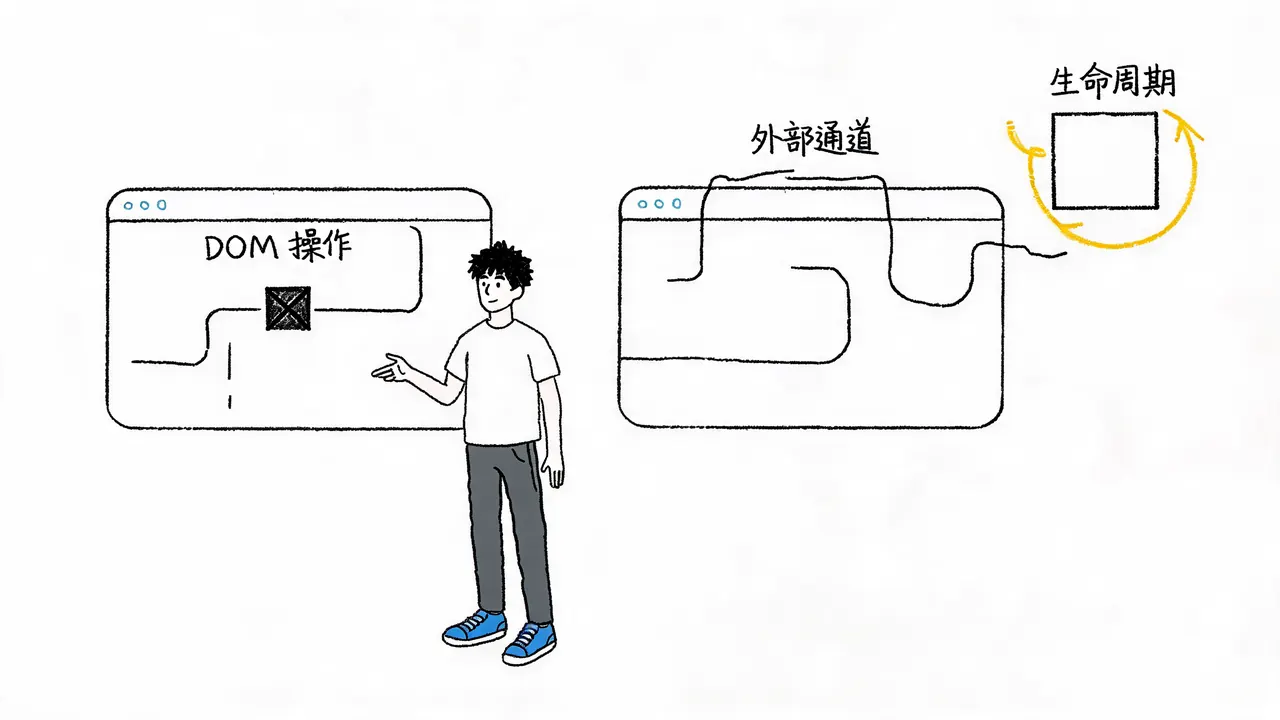
- DOM 操作:仅在前端环境内模拟点击,不触发浏览器层面的真实事件。一旦遇到跨域限制或需要操作系统级交互(如文件选择框),DOM 操作往往失效。
- WebDriver:走的是浏览器外部通道,能够控制浏览器的整个生命周期。这包括启动/关闭浏览器、调整窗口大小、管理 Cookie,甚至模拟地理位置和网络条件。
正是这种对浏览器底层能力的全面掌控,使得 WebDriver 成为 W3C 推荐标准后,所有浏览器厂商都愿意原生支持的原因。它为用户提供的是更稳定的自动化体验,而非依赖某个第三方库的私有实现。
典型应用场景
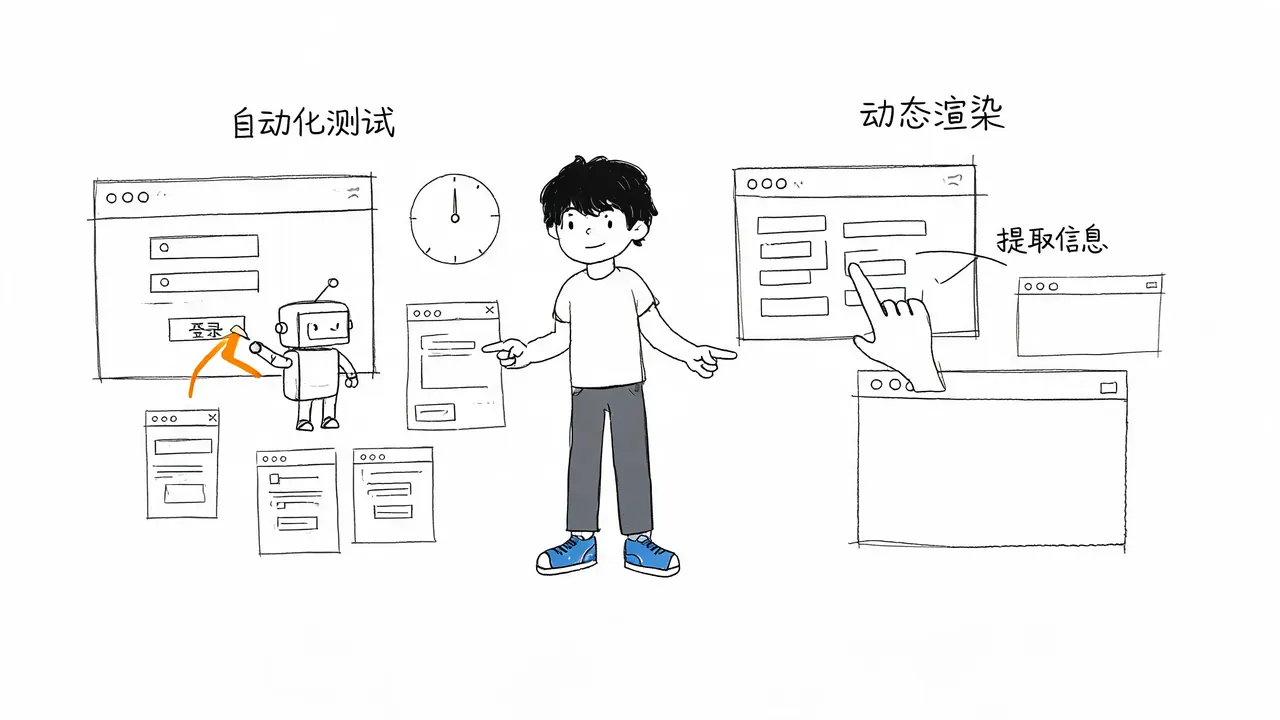
在实际开发中,WebDriver 主要应用于以下两个场景:
1. 自动化测试
这是 WebDriver 最常见的用途。例如,验证登录页面在用户输错密码时是否显示正确提示。传统手动测试需要反复操作浏览器,而 WebDriver 脚本可以在一分钟内跑完几十种输入组合,极大提升测试效率。
2. 网页数据采集
对于依赖 JavaScript 动态渲染内容的网站,直接抓取 HTML 源码往往无法获取有效数据。使用 WebDriver 驱动真实浏览器,可以等待页面完全加载和渲染后再提取信息,从而解决动态内容抓取难题。
局限性与适用边界
尽管功能强大,WebDriver 也有明显的局限性:
- 性能瓶颈:由于需要启动真实浏览器实例,其速度远慢于纯 HTTP 请求。
- 反爬检测:WebDriver 模拟的是用户操作,但如果页面部署了复杂的验证码或行为检测机制,自动化脚本仍可能被拦截。
因此,WebDriver 适合需要真实交互的场景,但不适合大规模、高并发的数据抓取任务。
总结
WebDriver 不是一个具体的软件库,而是一个定义浏览器自动化通用语言的开放标准。其核心价值在于解耦——将测试逻辑与浏览器具体实现分离,确保同一套脚本能在不同浏览器上运行。
理解 WebDriver 的架构,有助于开发者明确其处理复杂交互的能力来源,同时也清楚其性能瓶颈所在。对于进入自动化测试或网页工具开发领域的开发者而言,WebDriver 是绕不开的第一块基石。