揭秘Redis单线程高性能:为何能扛住高并发?
很多人听说 Redis 是单线程的,第一反应往往是质疑:在现代多核 CPU 的服务器环境下,单线程怎么可能实现高性能?
然而现实情况是,在合适的硬件配置和负载条件下,单个 Redis 实例就能达到极高的吞吐量。Redis 之所以快,并非因为“单线程”本身有什么魔法,而是因为它巧妙地避开了多线程带来的额外开销,并将核心数据存储在内存中。
本文将深入探讨 Redis 到底是不是纯单线程,它依靠什么机制以“一人之力”处理海量请求,以及这种设计在什么情况下会遭遇瓶颈。
澄清误解:Redis 并非纯单线程
首先,我们需要纠正一个最大的误解:Redis 并不是从头到尾只有一个线程。
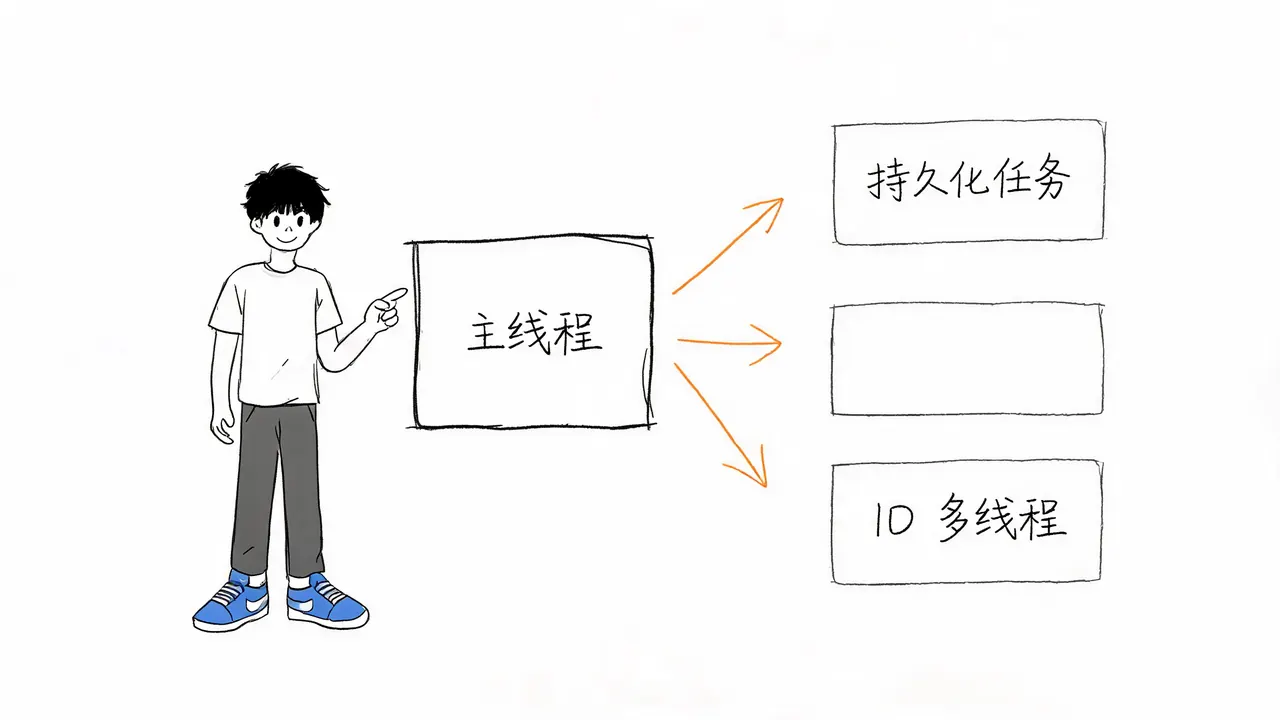
我们常说的“Redis 单线程”,主要指的是其核心命令的执行由主线程串行完成。但在后台,Redis 实际上拥有其他线程和子进程来处理部分“脏活累活”,例如:
- 持久化任务:RDB 和 AOF 的后台写入。
- 异步内存释放:避免大 Key 删除时阻塞主线程。
- IO 多线程:自 Redis 6.0 版本引入,协助处理网络数据的读写。
通过将部分外围工作(如网络 IO)分发给辅助线程,主线程才能专心致志地处理核心命令逻辑。
核心优势:为何主线程选择串行执行?
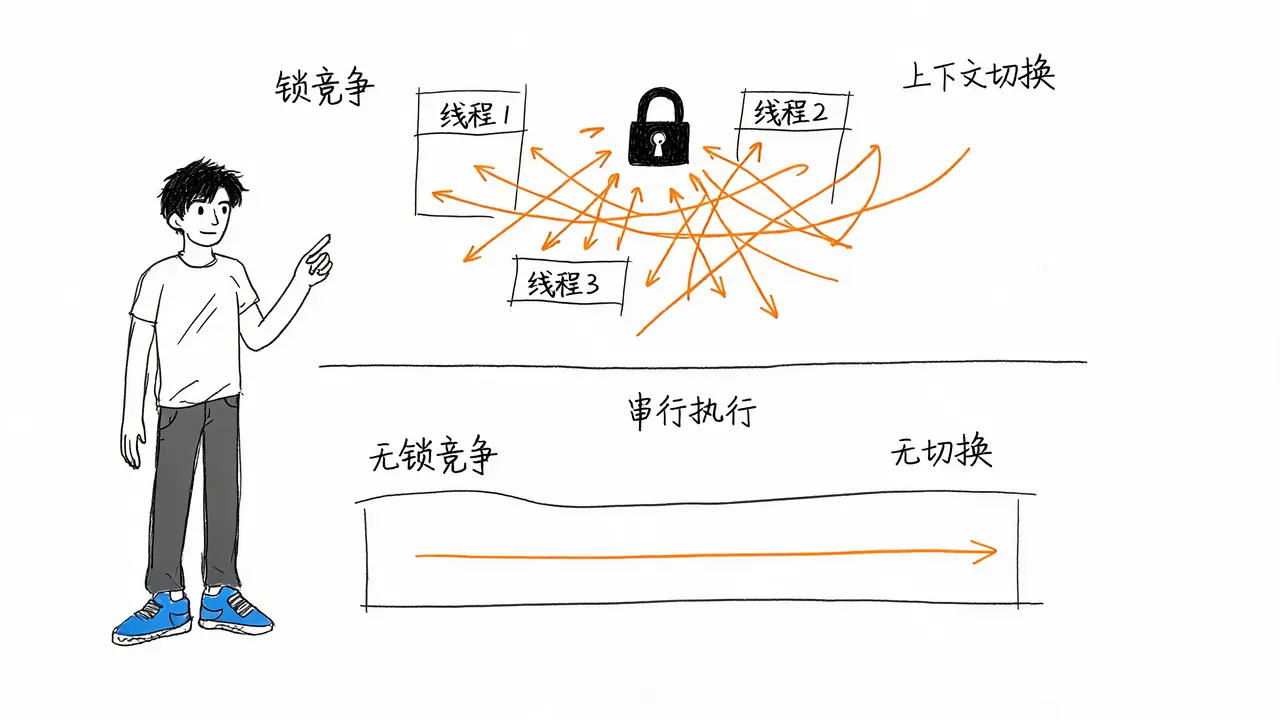
既然有多核 CPU,为什么核心命令执行非要采用单线程串行模式?这主要为了规避多线程模型中的两大性能杀手:
1. 避免锁竞争(Lock Contention)
如果让多个线程同时访问共享数据(如内存中的数据结构),为了防止数据错乱,必须加锁、排队和互相沟通。这种协调过程称为“锁竞争”。在大量并发场景下,获取锁和释放锁的开销巨大。
2. 减少上下文切换(Context Switch)
CPU 在多个线程之间来回切换时,需要保存和恢复执行状态(寄存器、程序计数器等)。对于 Redis 这种执行时间极短的内存操作来说,多线程带来的协调和切换开销,往往会抵消并行计算带来的收益。
Redis 采用单线程串行执行核心命令,就像让一位最熟练的服务员从头到尾完成所有工作,彻底消除了锁竞争和线程切换的麻烦,从而将 CPU 算力最大化地用于业务逻辑处理。
关键机制:IO 多路复用
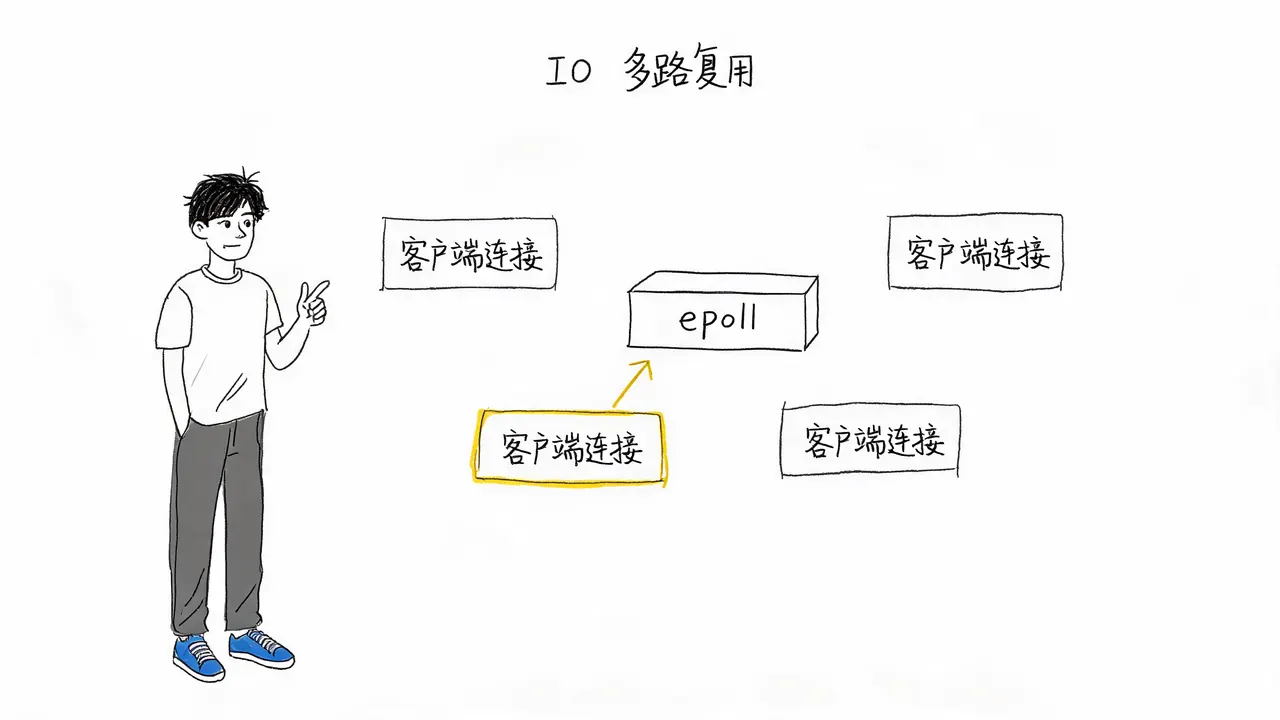
既然只有一个主线程,它如何同时应对上万个客户端连接?这就靠 Redis 的第二个杀手锏:IO 多路复用(IO Multiplexing)。
你可以将其想象为一个“超级前台”:
- 它不会傻等某个顾客点菜,而是给每个连接发一个“号码牌”。
- 前台只盯着叫号系统(在 Linux 中常见机制为
epoll)。 - 只有当某个连接的数据准备好了,操作系统才会通知前台去处理。
通过这种方式,单个线程就能同时监听和管理大量网络连接,无需阻塞等待那些没有数据到达的慢连接。
性能基石:内存操作与高效数据结构
单线程模型能跑得快,还有一个不可或缺的前提:数据主要在内存中。
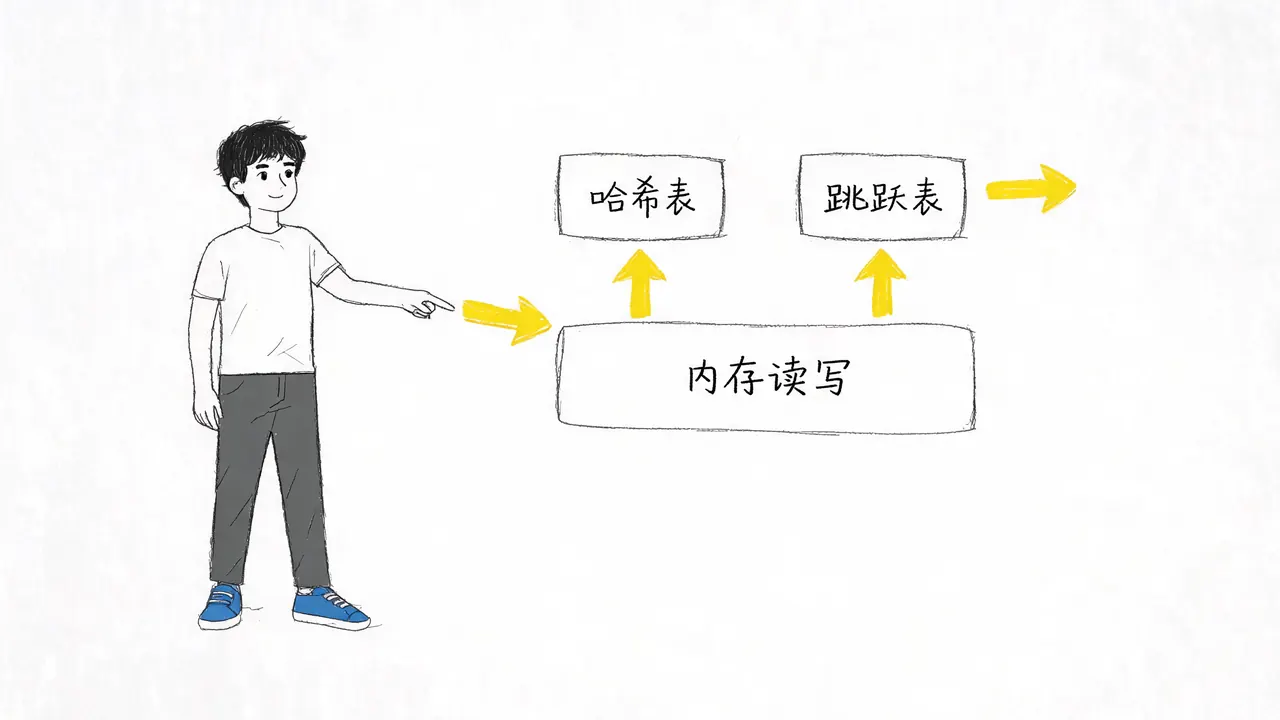
- 内存读写:Redis 的日常读写直接操作内存,无需像传统磁盘数据库那样频繁等待磁盘 IO。内存访问速度极快,使得主线程能迅速处理完一个请求后立即处理下一个。
- 高效数据结构:Redis 底层使用了哈希表(Hash Table)、跳跃表(Skip List)、压缩列表等高效数据结构,使得大量的查找、插入和删除操作都能在极短时间内完成。
致命软肋:慢命令与大 Key 风险
尽管单线程模型在短小内存操作上表现优异,但它也有致命的软肋。
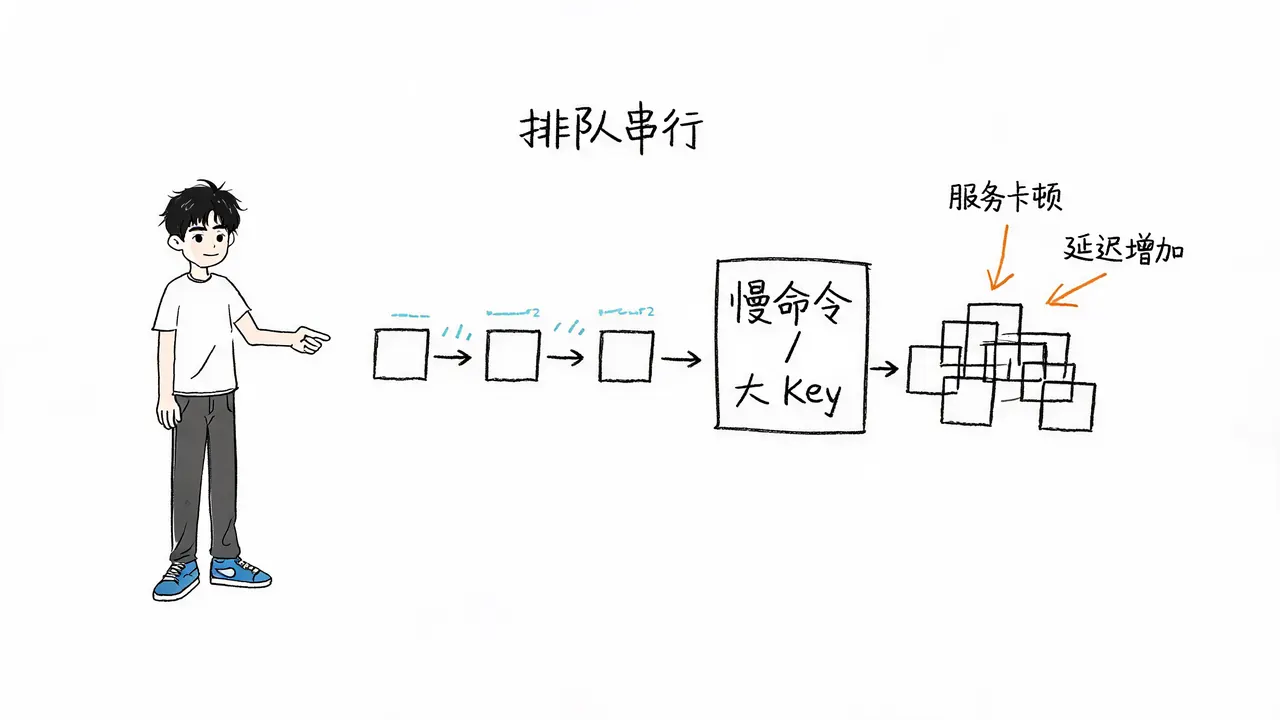
由于核心命令是排队串行执行的,一旦队列中混入一个慢命令,整个服务就会卡顿。例如:
- 执行
KEYS *进行全量扫描。 - 处理一个超级大的 Key(如包含数百万成员的 Set)。
当主线程被这些耗时操作长时间占用时,后面排队的大量正常请求只能等待,导致 Redis 服务出现严重的延迟甚至不可用。
因此,在实际开发中,必须遵循以下最佳实践:
- 避免在生产环境使用
KEYS命令,改用SCAN进行渐进式扫描。 - 严格控制大 Key,避免单个 Key 占用过多内存或包含过多元素。
- 监控慢查询日志,及时发现并优化耗时命令。
总结
Redis 的高性能并非因为单线程天生优于多线程,而是在大量短小内存操作这一特定场景下,通过更简单的执行模型,省去了多线程的协调成本。
理解这一设计取舍,有助于我们掌握高并发系统设计的一条核心原则:没有绝对完美的架构,只有更适合当前瓶颈的设计。