面试官:分布式锁怎么实现才可靠?
在近期的后端面试中,一位拥有四年经验的候选人被问到一个经典问题:“分布式锁怎么实现才可靠?”他自信地回答:使用 Redis 的 SETNX 命令配合过期时间,存储唯一请求标识,遵循“谁加锁谁解锁”的原则,既能防止死锁又能保证互斥,几行代码即可搞定。
然而,当面试官抛出一个真实的线上秒杀超卖事故场景时,这位候选人陷入了沉默。
`` 是摘要与正文的分隔标记,请保留。线上事故复盘:看似完美的锁为何失效?
假设在秒杀库存扣减场景中,使用了标准的 Redis 分布式锁,锁超时时间设置为 3 秒。自测和压测阶段,并发场景下库存扣减准确,未出现超卖。然而,在大促秒杀开场几秒内,后台爆出库存被扣成负数,超卖 20 多单,同时有用户反馈“抢到库存但下单提示无货”。
排查发现:
- 锁的加解锁逻辑没有错误,也没有异常报错。
- 峰值期间,多个请求同时进入了临界区。
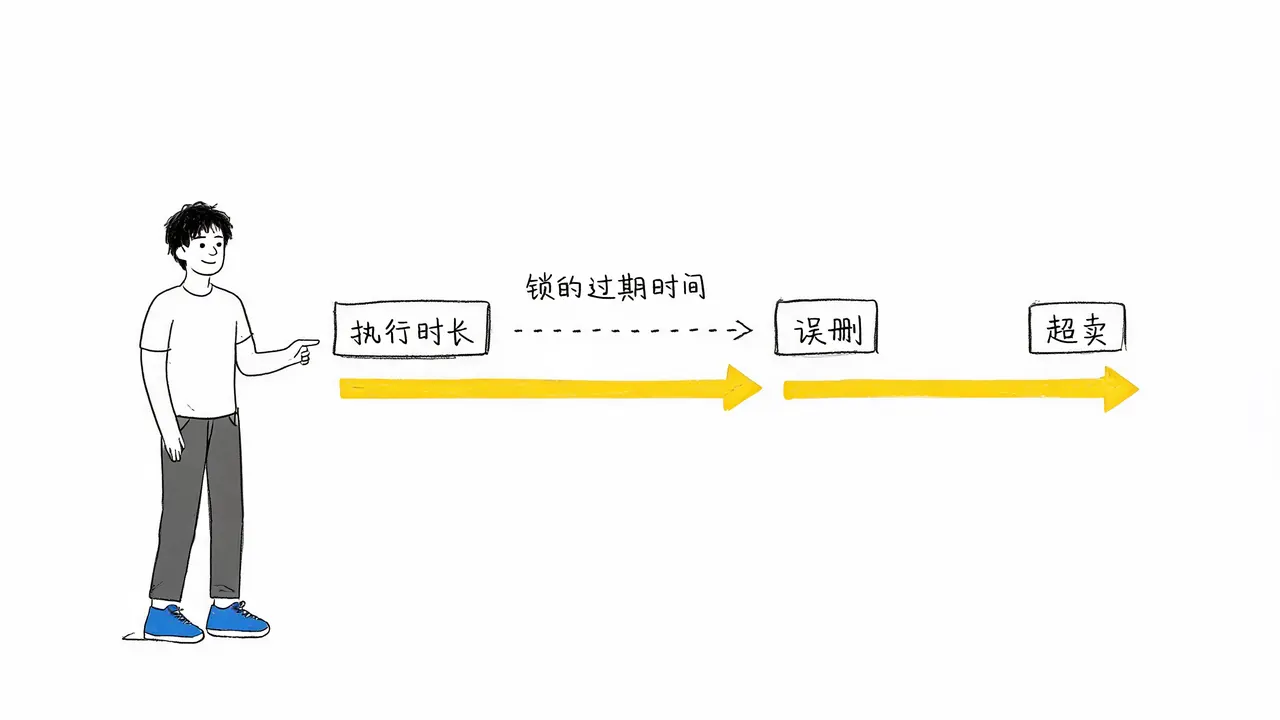
- 第一个请求尚未执行完,锁已过期释放;第二个请求顺利拿到锁。
- 锁的过期时间(3 秒)是压测时业务执行时长的两倍,但线上峰值下,由于数据库卡顿或服务 GC,锁内逻辑执行时长突然飙过过期时间。
- 第一个请求执行完后去解锁,误删了第二个请求刚加的锁。
核心问题: 在业务抖动导致锁超时失效、误解锁的情况下,如何快速定位根因并止损?如何设计真正生产可用的分布式锁方案?难道靠无限加长锁过期时间就能硬扛吗?
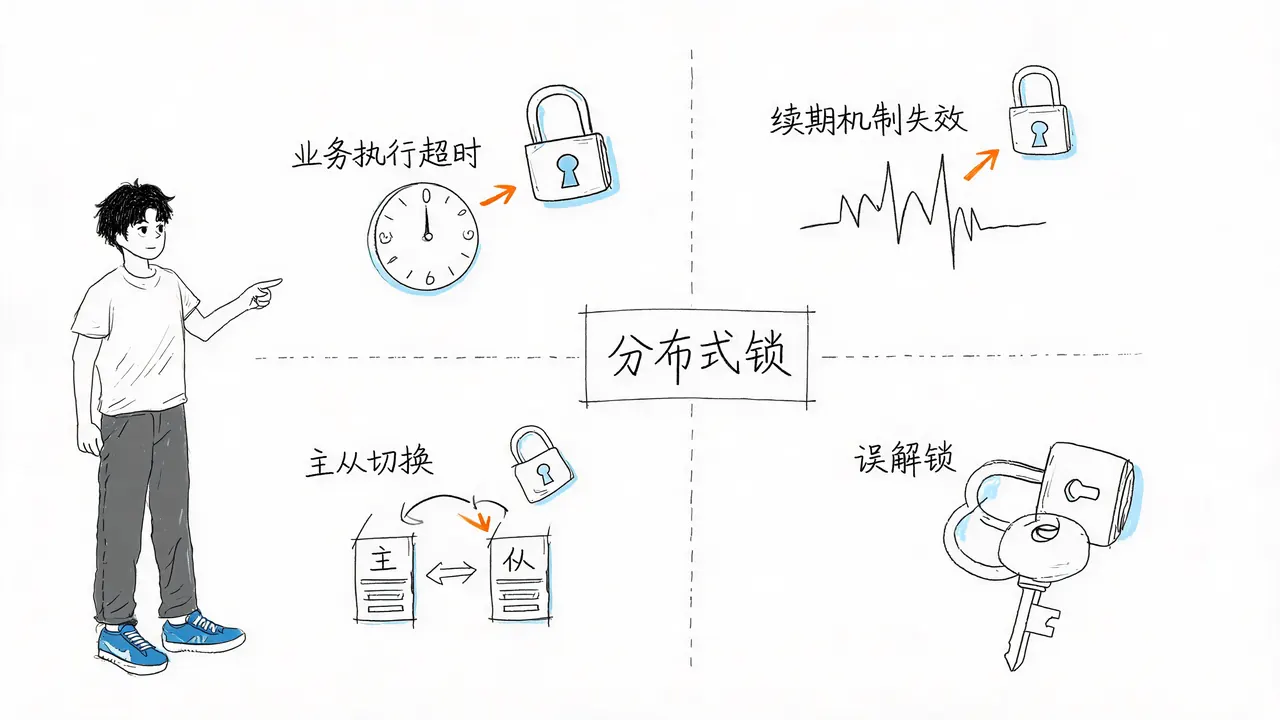
这正是分布式锁最隐蔽的“幽灵陷阱”。许多开发者以为背熟了 SETNX + 过期时间 + 校验解锁的口诀就能做好分布式锁,却忽略了以下风险:
- 业务执行超时导致锁自动释放。
- 续期机制失效。
- 集群主从切换导致锁丢失。
- 误解锁击穿互斥防护。
看似简单的几行代码,实则生产环境一个性能抖动就能击穿所有保障。
为什么这个问题能筛出高手?
这道题考察的不是会不会写分布式锁工具类,而是生产视角下的锁可靠性与风险兜底思维。一个能守住核心并发安全的后端工程师,必须建立三层防御体系。
第一层:业务分级与差异化锁策略
不同业务场景对锁的可靠性要求不同,应采取差异化策略:
-
核心强互斥场景(如库存扣减、资金变更):
- 采用唯一标识 + 看门狗自动续期 + 持有者校验解锁的基础方案。
- 业务未执行完时自动续期,从根源避免锁超时释放。
- 严格管控锁内逻辑:禁止在锁内执行无超时的远程调用、慢 SQL 等长耗时操作,最大限度缩短锁持有时间。
-
非核心场景(如任务去重、幂等标记):
- 使用基础过期锁即可,接受极低概率的锁失效风险。
-
拆分锁粒度:
- 将大业务拆分为细粒度锁,避免粗粒度锁长时间占用资源。
第二层:兜底校验与失效防护
即使分布式锁失效,也必须保证数据一致性:
-
数据库层兜底:
- 加乐观锁或唯一约束,作为最终防线。即使分布式锁完全失效,也绝不会出现超卖、重复执行等脏数据落库。
-
分布式锁监控体系:
- 实时监控锁获取成功率、锁持有时长、续期次数、解锁失败率。
- 指标异常时自动告警。
-
锁误解锁防护:
- 释放锁时严格校验持有者标识,即使锁过期也不会误删别人的锁。
-
极端场景熔断:
- 单位时间内获取锁失败超过阈值时快速失败,避免请求堆积拖垮服务。
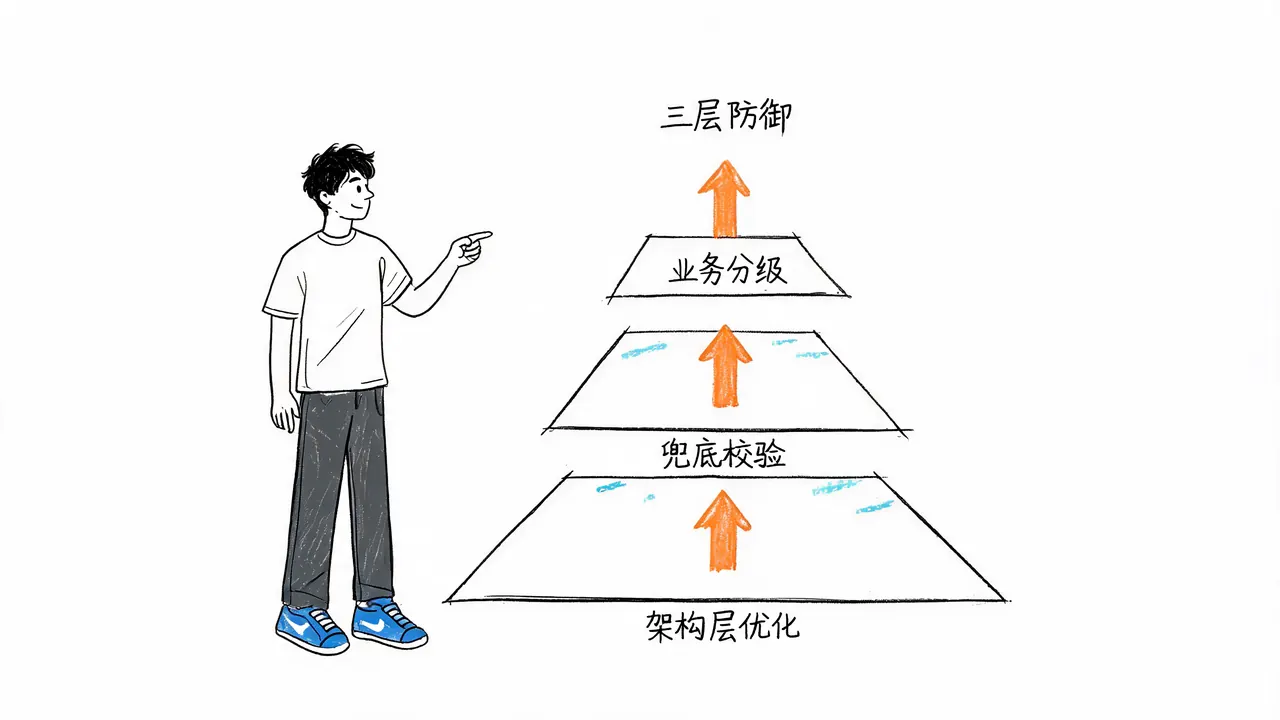
第三层:架构层优化
从根源提升锁可靠性:
-
高可用锁实现:
- 核心高并发场景优先采用多节点 RedLock 或一致性强的锁实现,避免单节点宕机、主从切换导致的锁丢失。
-
组件化与标准化:
- 核心锁逻辑统一组件化,标准化加锁、续期、解锁、异常处理全流程,避免各业务各自实现导致的逻辑漏洞。
-
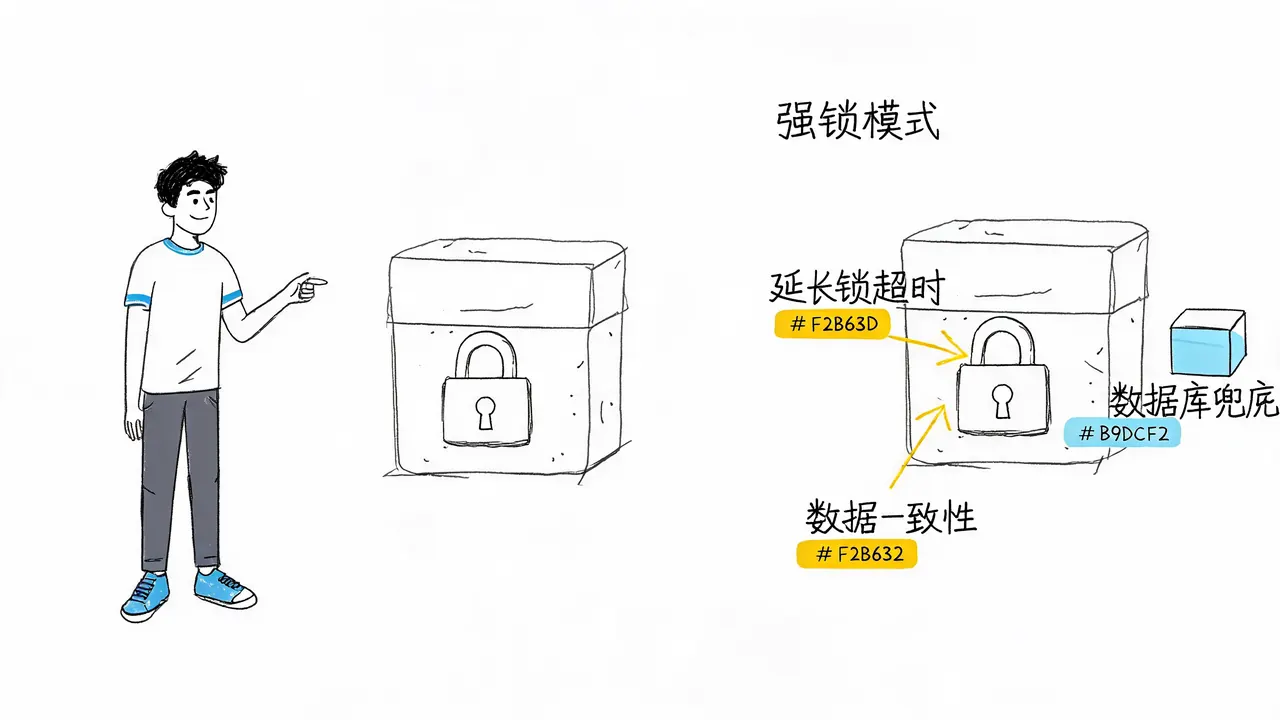
大促强锁模式:
- 核心时段开启强锁模式:延长锁超时冗余、加强续期频率、启用数据库兜底校验。
- 宁可牺牲少量并发性能,也绝不允许分布式锁失效引发数据一致性事故。
总结:从工具使用者到体系设计者
普通开发以为加个带过期的 SETNX 就是分布式锁的全部,而高级工程师知道,在复杂的生产环境与业务抖动面前,分布式锁是一把双刃剑。一个超时续期的细节没考虑到,就可能引发超卖、重复执行的严重线上事故。
真正的专业,是升级为设计全场景高可靠分布式锁体系的工程思维,而非仅仅掌握几行代码。