Redis 五种核心数据类型详解:从 String 到 ZSet 的业务场景与选型指南
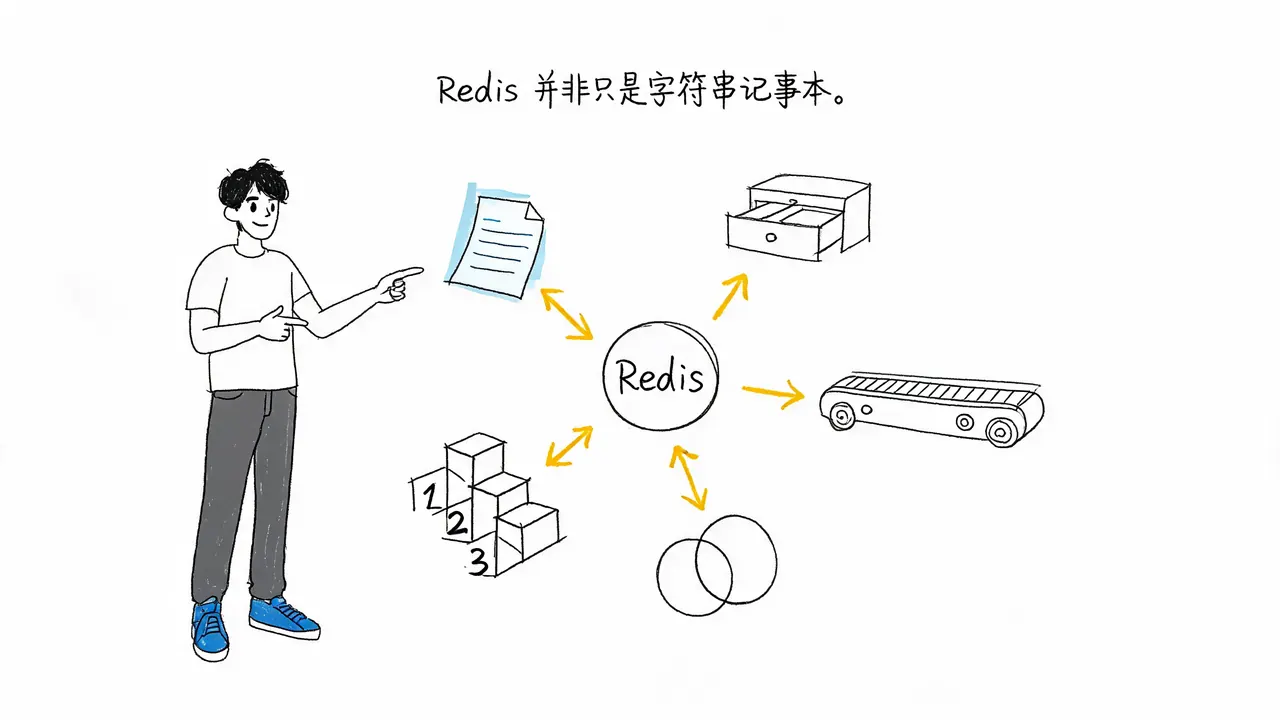
Redis 并非只是字符串记事本:五大核心数据类型详解
许多开发者初识 Redis 时,往往将其视为一个简单的“记事本”,认为它仅能存储键值对形式的普通字符串。然而,Redis 实际上是一个支持多种数据结构的内存数据库。虽然其键(Key)确实是普通的字符串,但其值(Value)却隐藏着五种专门针对不同业务场景优化的核心数据类型。
选对数据类型,不仅是代码层面的简化,更是让系统在极高并发下依然保持毫秒级响应的关键。本文将逐一梳理这五种常见数据类型,解析它们的结构特点、典型业务场景以及选型背后的逻辑。
1. String(字符串):万能的缓存与计数器
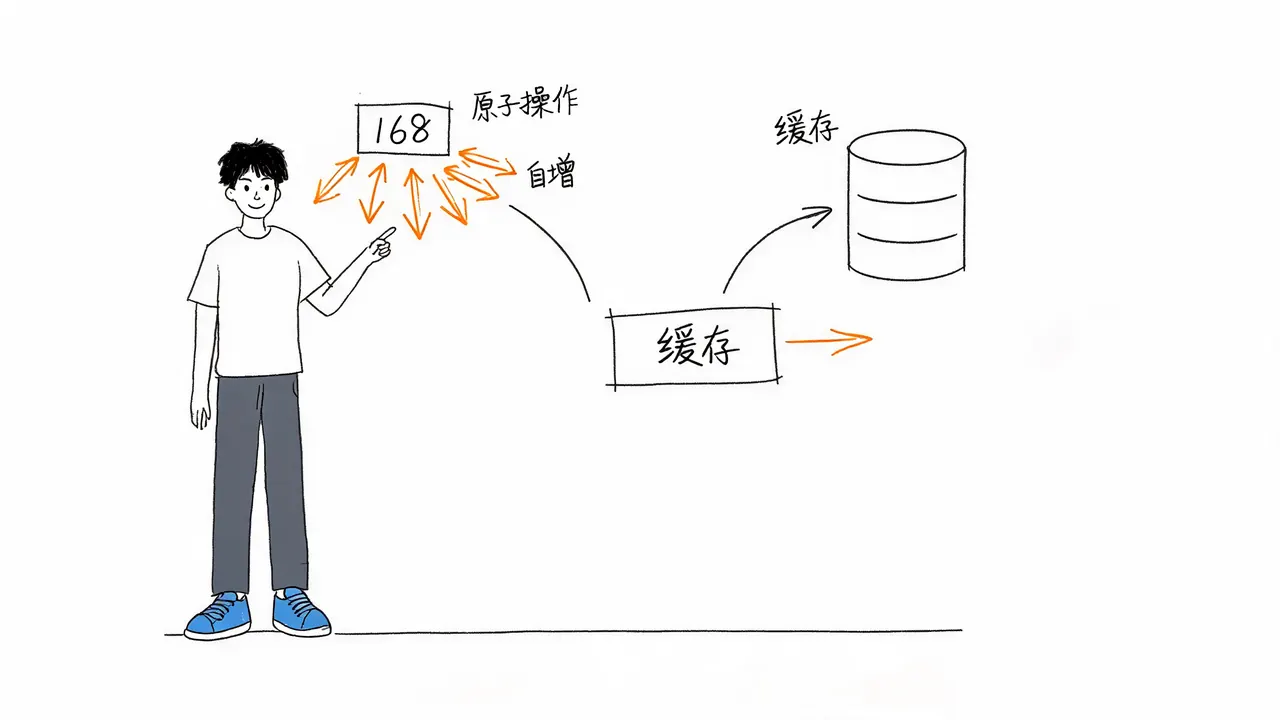
String 是 Redis 中最基础的数据类型,可以将其视为一张“万能的便签纸”。
核心特性
- 多态存储:不仅能存储普通文本,还能存储数字,甚至支持图片等二进制数据。
- 原子操作:Redis 提供了原子的自增/自减命令,保证了并发环境下的数据一致性。
典型应用场景
- 缓存:这是 String 最常见的用途。例如,将数据库查询出的用户信息序列化为文本存储,下次请求时直接读取,避免频繁访问数据库。
- 计数器:适用于文章阅读量、视频点赞数等场景。由于 Redis 的自增命令是原子的,即使有一万人同时点赞,数字也不会出现计算错误。
2. Hash(哈希):高效存储对象属性
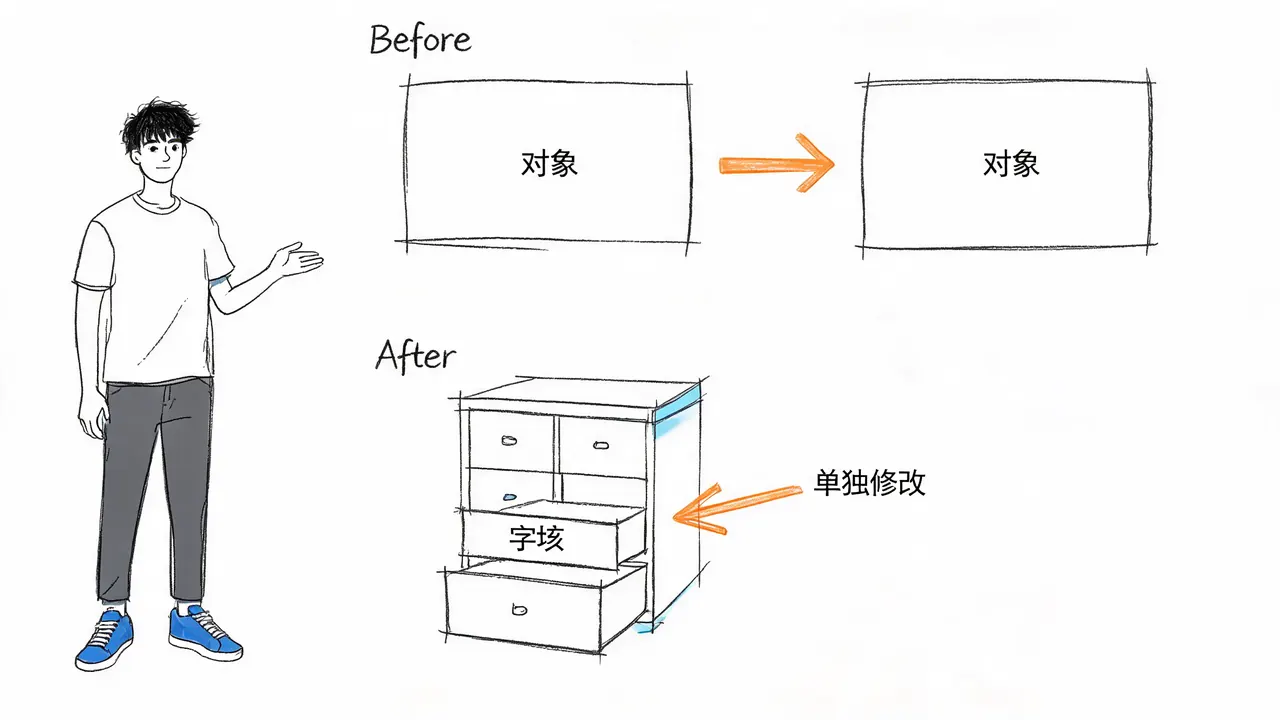
如果说 String 是一张便签纸,那么 Hash 就是一个带有许多小抽屉的储物柜。
核心特性
- 字段级操作:Hash 适合存储带有多个属性的对象。每个属性对应一个“抽屉”(Field),可以单独读取或修改,无需操作整个对象。
- 资源优化:相比 String,使用 Hash 存储对象可以显著节省内存和网络传输开销。
典型应用场景
- 用户信息存储:假设一个用户有姓名、年龄、邮箱等属性。若使用 String 存储,修改年龄时需要取出整段数据,修改后再写回;而使用 Hash,只需单独修改“年龄”这个字段即可。
- 购物车:在电商系统中,购物车通常用 Hash 存储。商品 ID 作为 Field,购买数量作为 Value,方便单独增减某件商品的数量。
3. List(列表):有序队列与时间轴
List 可以想象成一条传送带或一个排队的队列。
核心特性
- 有序且允许重复:数据按照插入顺序排列,且允许存在重复元素。
- 双端操作:数据可以从列表的两端插入(Push)或弹出(Pop),操作效率极高。
典型应用场景
- 消息队列:利用 List 的双端特性,生产者从一端插入任务,消费者从另一端取出执行,天然适合构建简单的消息队列。
- 时间轴与最新列表:微博、朋友圈等按时间顺序排列的动态流,或者“最新十条评论”列表,使用 List 实现非常顺手,只需获取列表前 N 个元素即可。

4. Set(集合):去重与集合运算
Set 与 List 最大的区别在于,Set 是一个自动去重的无序集合。
核心特性
- 唯一性:无论插入多少次相同元素,集合中只保留一个。
- 集合运算:支持数学中的交集、并集、差集运算。
典型应用场景
- 唯一性校验:如给文章打标签(避免重复标签)、记录当天已签到的用户 ID。
- 社交关系计算:在社交软件中,计算“共同好友”或“共同关注的博主”,底层往往就是获取两个用户的关注列表(Set),然后执行交集运算。

5. ZSet(有序集合):自带排名的积分榜
ZSet(Sorted Set)结合了 Set 的去重特性,但为每个元素绑定了一个分数(Score)。
核心特性
- 自动排序:Redis 会根据分数大小自动对元素进行排序。
- 范围查询:支持按名次或分数区间直接查询数据,无需应用层编写复杂的排序算法。
典型应用场景
- 排行榜:游戏的全服战力榜、音乐软件的热歌榜,背后通常都是 ZSet 在支撑。
- 地理位置排序:外卖平台按距离排序的商家列表,也可以利用 ZSet 的分数(距离)来实现快速排序和检索。
高级数据类型与选型总结
除了上述五种核心基础类型,随着版本更新,Redis 还引入了 Bitmap(位图)、HyperLogLog(基数统计)和 GEO(地理位置)等高级数据结构。例如,利用 Bitmap 可以用极小的内存统计上亿用户的签到状态,利用 GEO 可以计算附近的人。
然而,在日常绝大多数业务场景中,前五种基础类型已足够覆盖大部分需求。
为什么选对类型至关重要?
理解 Redis 的数据类型,本质上是在理解“用什么工具干什么活”:
- 关系型数据库(RDBMS):擅长处理复杂的表关联和事务。
- Redis:擅长将数据直接塑造成业务需要的形状,利用内存特性提供极致性能。
选对数据结构,不仅是省下几行代码的事,更是让系统在极高并发下依然能保持毫秒级响应的关键。开发者应根据具体业务场景(如是否需要去重、是否需要排序、是否需要原子计数)来选择最合适的数据类型,从而最大化 Redis 的性能优势。