大厂后端 P7 面试题解析:亿级用户中心系统架构设计
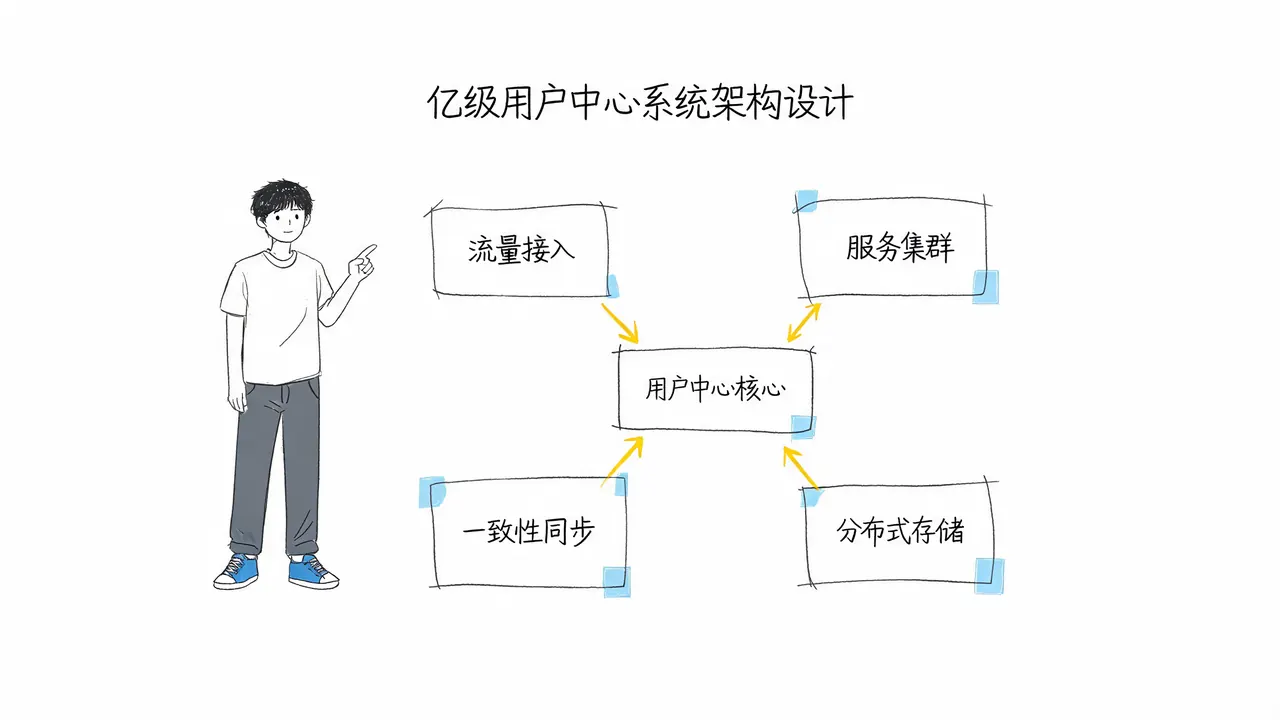
在后端面试中,一道经典的架构设计题往往能直接决定候选人的定级。题目通常要求设计一个支持亿级用户体量的用户中心系统,覆盖账号注册、登录鉴权、信息查询、资料更新全流程,并阐述完整架构与核心优化方案。
许多候选人的第一反应往往是:“建一张用户表,写个登录接口,加上 JWT 鉴权。”如果止步于此,面试基本宣告结束。面试官考察的并非基础 CRUD 能力,而是候选人是否具备将单体服务转化为高可用、高并发、可扩展的分布式系统的工程能力。
本文将这道一线大厂 P7 级面试真题拆解为六个核心得分点:流量分层、服务拆分、存储体系、一致性保障、多集群协同、安全与成本。掌握这六个维度,即可在面试中构建出具备生产级水准的架构方案。
核心考点解析
题目中的关键词“亿级用户”、“全场景”、“完整架构”,背后考察的是四个维度的综合能力:
- 流量管控:如何应对海量并发请求。
- 领域设计:如何合理划分服务边界。
- 数据架构:如何平衡性能、成本与一致性。
- 稳定性与可运维性:如何保障系统在高负载下的稳定运行。
得分点一:流量分层与入口治理
首先,必须避免所有请求直接冲击业务服务,需建立全链路流量分层治理体系,引入网关层与接入层,对不同类型的请求进行分级处理。
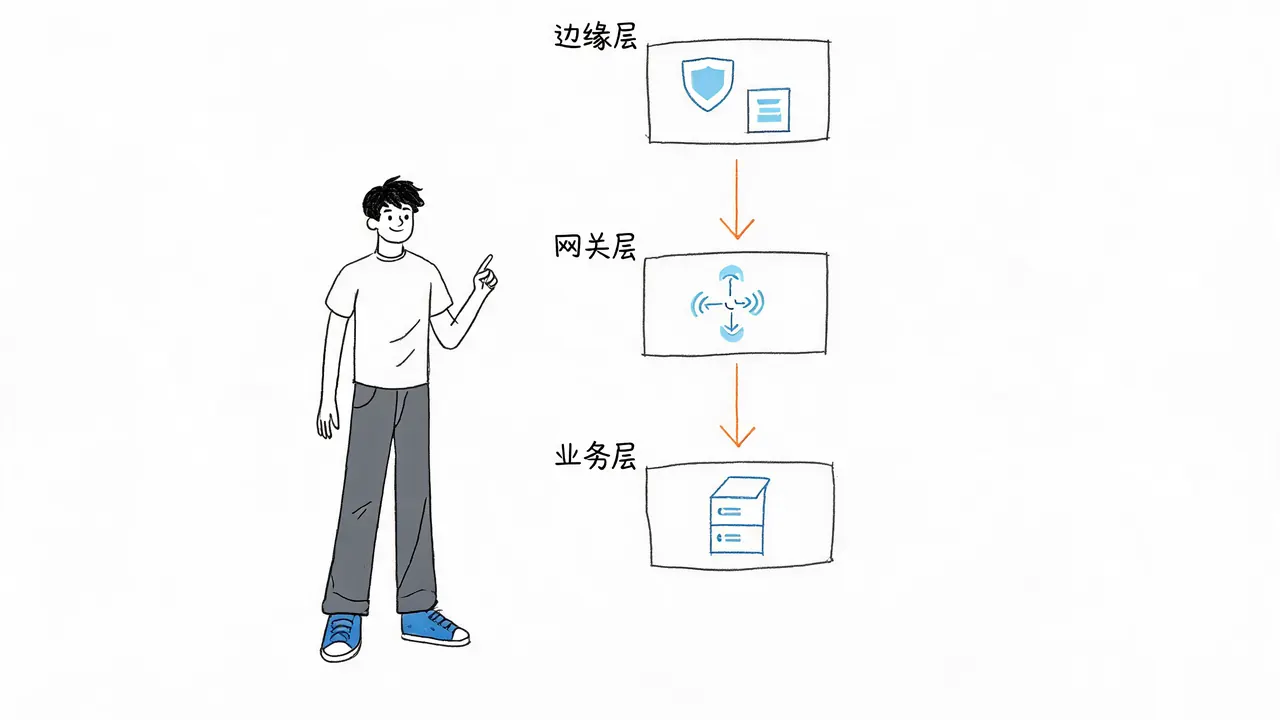
典型的请求链路应拆分为三层:
- 边缘层:负责 CDN 静态资源加速、WAF 安全防护以及地域流量调度。
- 网关层:执行参数校验、接口限流、身份鉴权及灰度发布控制。
- 业务层:处理具体的登录校验、信息查询及资料更新逻辑。
加分项:请求分级与隔离
- 读写隔离:登录请求属于写操作,需加强校验;查询请求属于读操作,需优化高并发性能。两者应进行链路隔离。
- 热点隔离:针对热点用户的查询,应单独建立缓存隔离机制,防止单点热点拖垮整个系统。
- 多级限流:需明确限流粒度,包括按用户 ID、按 IP 地址、按接口维度进行多级限流,确保系统稳定性。
得分点二:服务拆分与领域设计
用户中心不应做成“大而全”的单体服务,而应基于**领域驱动设计(DDD)**划分服务边界,定义标准的领域服务与原子接口。
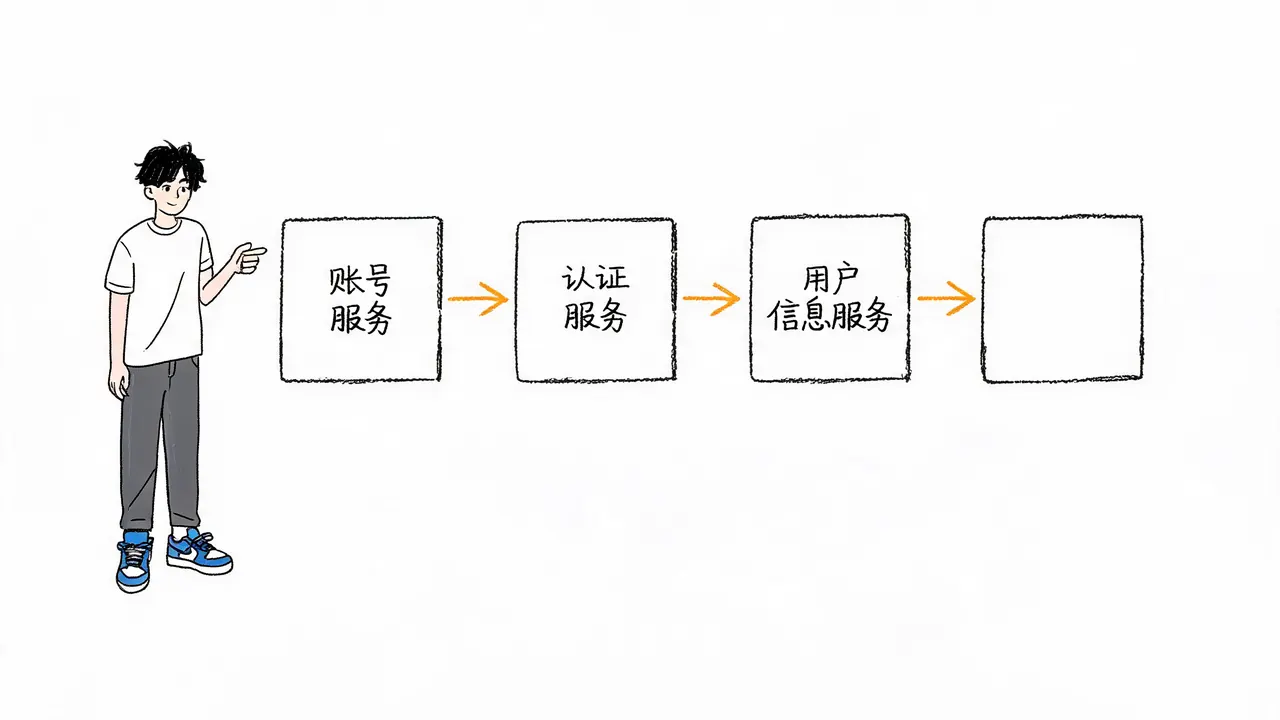
建议拆分为以下核心服务:
- 账号服务:负责注册、注销及账号状态管理。
- 认证服务:负责登录、Token 签发与校验。
- 用户信息服务:负责用户资料的读写操作。
- 权限服务:负责用户权限管理。
关键原则:
- 每个服务只负责单一领域能力。
- 服务间通过内部 RPC 调用,严禁跨库直连,以避免领域逻辑混乱、数据耦合,进而导致系统迭代困难和数据不一致。
得分点三:存储体系:多级缓存与分库分表
亿级用户体量下,不能依赖单一 MySQL 实例扛住所有查询,需设计分层存储体系,匹配不同数据的访问频率与一致性要求。
- 热点缓存层:
- 将用户登录态、基础信息等高频访问数据存入 Redis 集群。
- 采用“本地缓存 + 分布式缓存”的两级缓存架构。
- 设置合理的缓存失效策略与击穿防护机制。
- 业务数据层:
- 用户账号、资料等核心数据实施分库分表。
- 分库策略:按用户 ID 哈希分库。
- 分表策略:按注册时间分表。
- 架构模式:搭配读写分离的主从架构。
- 冷数据层:
- 历史登录日志、操作记录等归档数据存入低成本存储。
- 定期同步至数据仓库,用于离线分析。
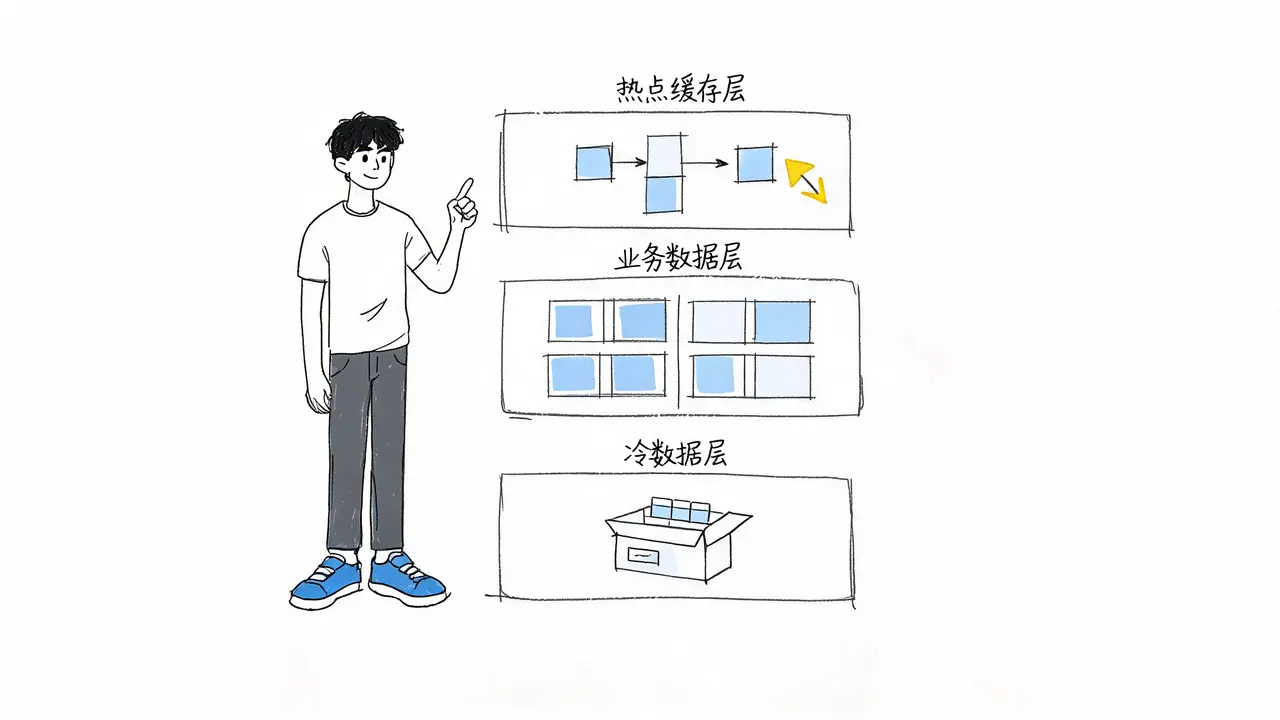
查询流程优化: 用户信息查询优先走缓存,缓存未命中再查数据库。同时需实现缓存预热与更新机制,确保数据新鲜度。
得分点四:一致性保障与异常兜底
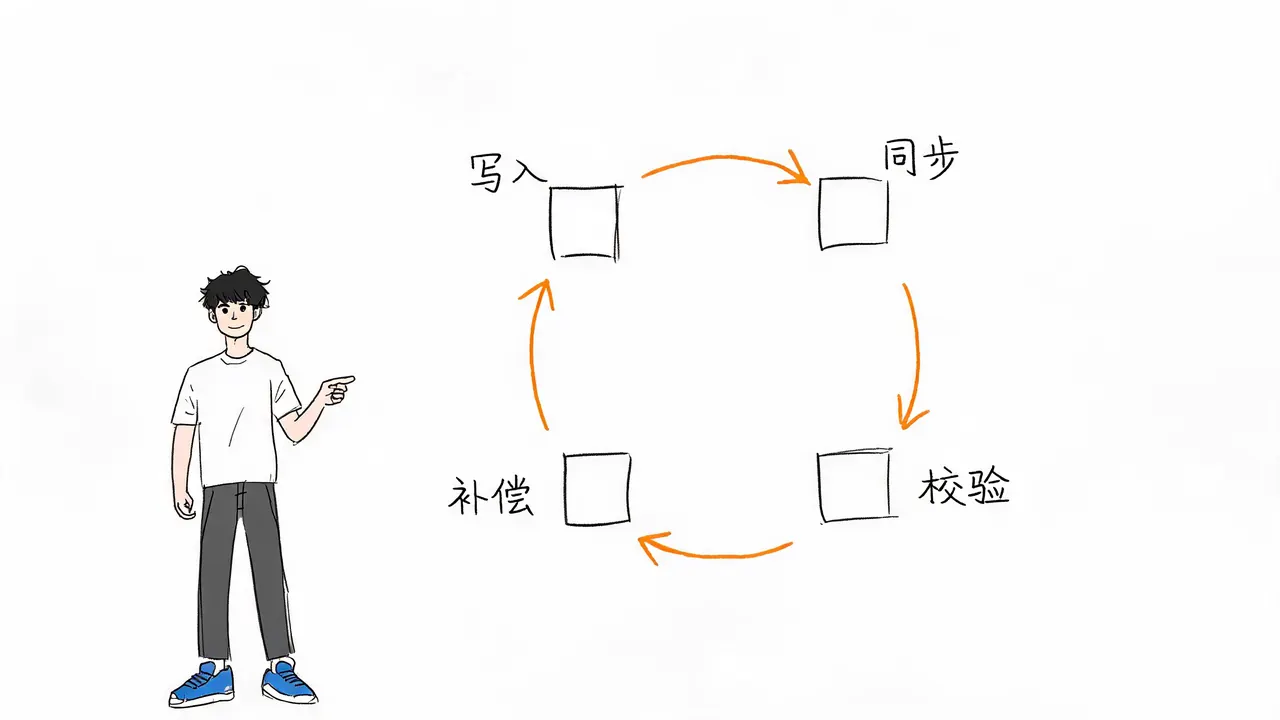
架构设计不能只考虑正常流程,必须采用异常优先的思维,构建“写入-同步-校验-补偿”的闭环一致性设计。
- 缓存一致性:用户更新资料后,采用“先更新数据库,再删除缓存”的延迟双删策略,确保缓存与数据库最终一致。
- Token 平滑刷新:登录 Token 过期前进行平滑刷新,避免用户无感知掉线。
- 读写路由策略:针对数据库主从延迟问题,核心“写后读”场景强制走主库,其他读请求走从库。
关键加分项:数据一致性补偿机制
- 异步对账:通过异步任务定期校验缓存与数据库的数据差异,发现异常数据自动修复。
- 降级策略:极端场景下(如缓存故障),直接降级到数据库查询,同时配合限流保护,体现对系统一致性与可用性权衡的深度理解。
得分点五:多集群协同与容灾架构
当面试官追问跨地域部署或机房故障处理时,需展示异地多活与容灾架构的设计能力。
- 全局流量调度层:负责入口流量的智能分配。
- 多地域集群部署:在多个地域可用区部署独立完整的用户中心集群。
- 数据同步:集群间通过数据同步工具实现准实时数据同步。
- 用户路由:通过全局统一的账号路由服务进行用户定位。例如,北京用户就近接入北京集群;若北京机房故障,流量自动切换至上海集群,用户无感知。
这一部分能证明候选人不仅懂单服务开发,更具备大规模分布式系统的容灾设计视野。
得分点六:安全、成本与可观测性
资深后端工程师必须关注生产级系统的非功能性需求。
1. 安全体系
- 密码存储:加盐哈希存储,严禁明文。
- 敏感信息:接口返回数据脱敏处理。
- 风控策略:登录接口实施封控策略,校验异常设备与异地登录行为。
- 防攻击:接口防刷、防暴力破解。
- 审计日志:所有敏感操作留痕,便于事后追溯。
2. 成本控制
- 资源分级:查询链路使用低成本缓存资源,核心写链路使用高配数据库。
- 冷热分离:冷数据归档存储,降低存储成本。
- 弹性伸缩:业务高峰自动扩容,低峰缩容,实现资源弹性调度。
3. 可观测性
- 全链路监控:对每个接口的 QPS、耗时、错误率进行监控与告警。
- 链路追踪:核心登录链路实施全链路追踪,快速定位性能瓶颈。
- 行为告警:对用户异常行为进行实时封控与告警。
总结
这道用户中心系统设计题的核心,不在于画出复杂的架构图,而在于考察如何将简单的业务需求拆解为高并发、高可用、可扩展的分布式系统。
记住这六个得分点:
- 流量分层:入口治理与读写隔离。
- 服务拆分:基于 DDD 的领域边界划分。
- 存储体系:多级缓存与分库分表。
- 一致性保障:异常优先与补偿机制。
- 多集群协同:异地多活与容灾切换。
- 安全与成本:生产级的风控、成本与监控。
业务功能是表皮,架构设计是骨架。只会写接口,只有表皮;能把系统架构讲清楚,才是能扛事的后端工程师。