上下文工程 vs 提示词工程:从“写指令”到“管信息环境”
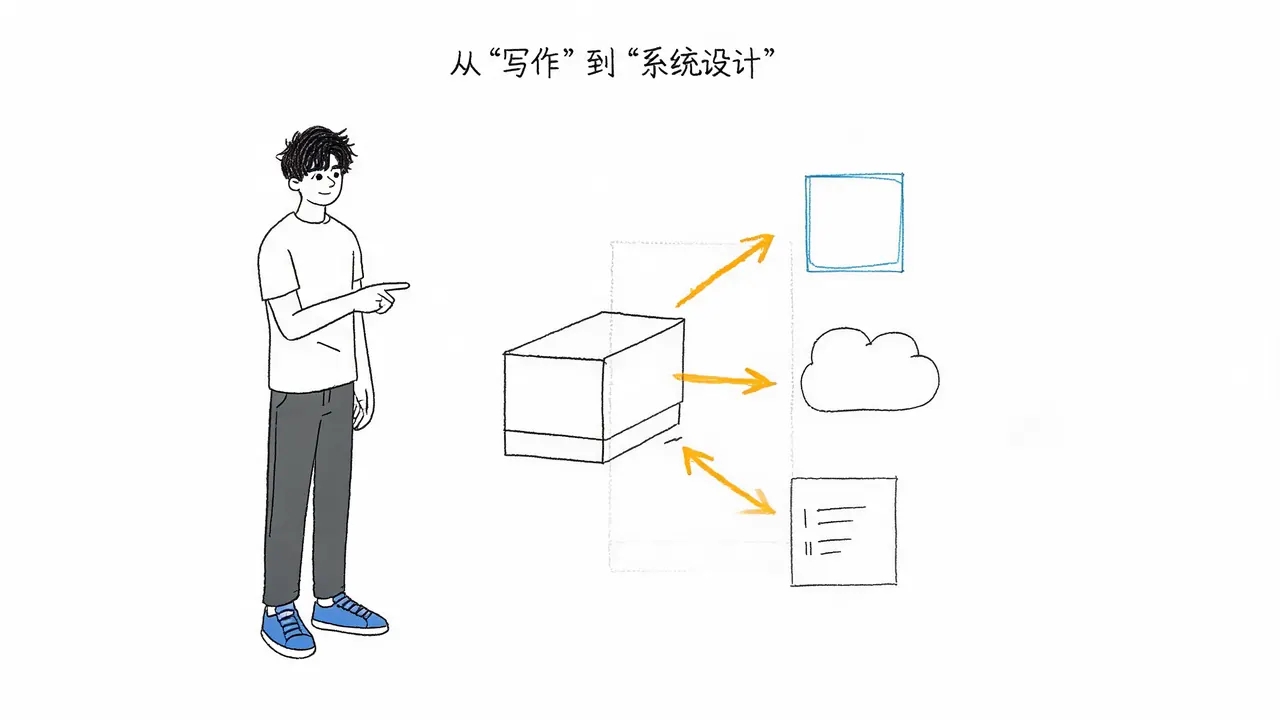
近期,“上下文工程”(Context Engineering)这一概念在技术社区迅速升温。许多人的第一反应是:这是否只是提示词工程(Prompt Engineering)换了个更高级的名字?
答案是否定的。提示词工程关注的是“这句话怎么写,模型更听得懂”,而上下文工程关注的是“这一次调用,到底该把哪些信息放进去,哪些坚决不放,顺序怎么排,太长了怎么压,变了怎么更新,效果怎么验”。
简单来说,提示词工程是在写说明书,而上下文工程是在设计整个工作台。
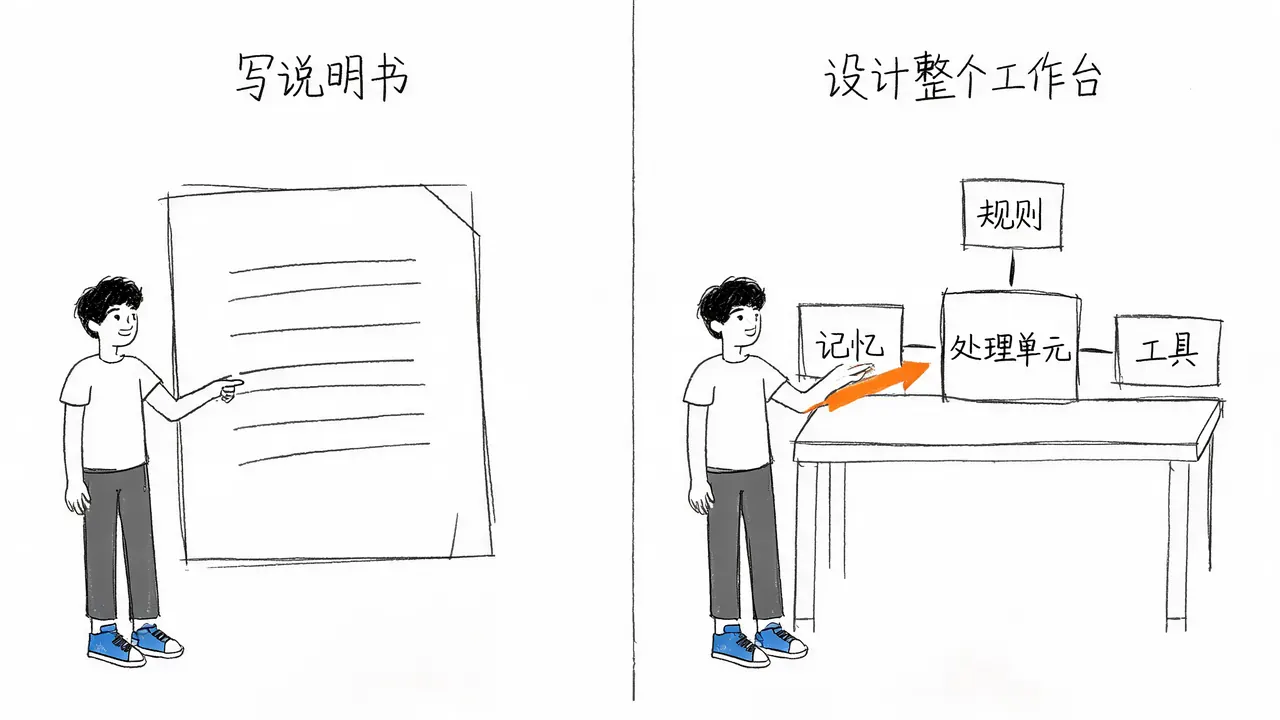
核心定义:从“写作”到“系统设计”
要理解两者的区别,首先需要明确它们各自的设计对象。
提示词工程:设计指令表达
提示词工程的核心在于指令的表达。它关注如何给模型设定角色、如何描述任务、分几步走、输出什么格式,以及是否需要提供示例(Few-shot)。这些要素对于模型理解意图至关重要,但其本质仍属于“写作”范畴。
上下文工程:设计信息环境
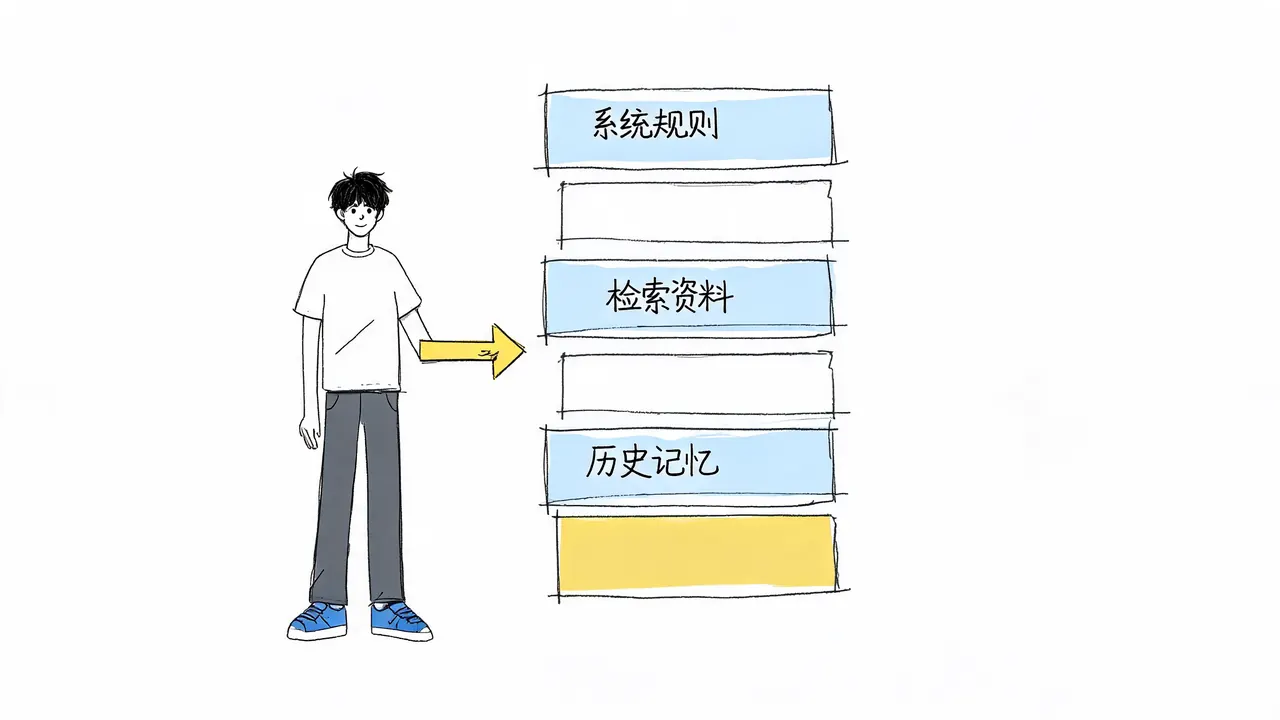
上下文工程的核心在于模型推理时看见的整个信息环境。在一个典型的 LLM 应用系统中,上下文窗口内包含多个层次的信息:
- 系统规则:全局约束和行为准则。
- 用户输入:当前的查询或指令。
- 检索资料:通过 RAG 等技术获取的外部知识。
- 历史记忆:多轮对话中的上下文状态。
- 工具结果:函数调用或 API 返回的数据。
- 输出约束:对最终回答格式或内容的限制。
提示词仅仅是这六层信息中的一部分。上下文工程则是围绕上下文窗口做的一整套系统设计,旨在让有限的上下文承载最有用的信号,而不是堆砌最多的文字。
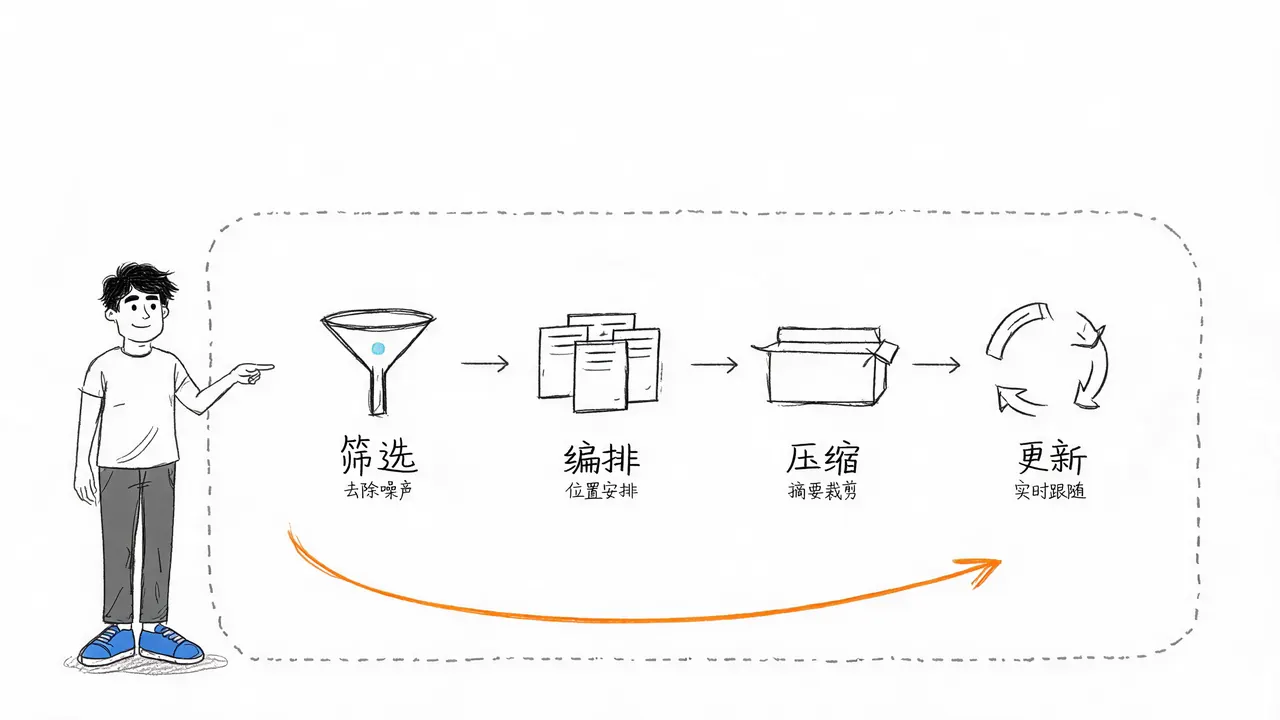
上下文工程的四道工序
在工程实践中,上下文工程主要包含以下四个关键步骤,所有操作都必须在 Token 预算之内进行取舍:
1. 选什么信息(筛选)
并非所有资料都适合导给模型。需要通过检索、重排序、过滤等手段,层层筛选出与当前任务真正相关的内容。这是漏斗模型的重点,目的是去除噪声,保留高价值信号。
2. 怎么排序(编排)
信息的摆放位置和结构直接影响模型的利用程度。关键规则、用户问题、证据材料的位置安排,会显著影响输出的稳定性。这是最容易被忽略但至关重要的一环。
3. 怎么压缩(优化)
上下文窗口虽长但并非无限。面对长对话、长文档或大量工具日志,通常需要进行摘要、裁剪、分块或分层保留,以在有限空间内最大化信息密度。
4. 如何更新(状态管理)
在多轮对话和智能体(Agent)场景中,状态是动态变化的。工具返回新数据、用户修改目标、记忆偏好更新等,都要求上下文能够实时跟随变化进行更新。
五大常见陷阱
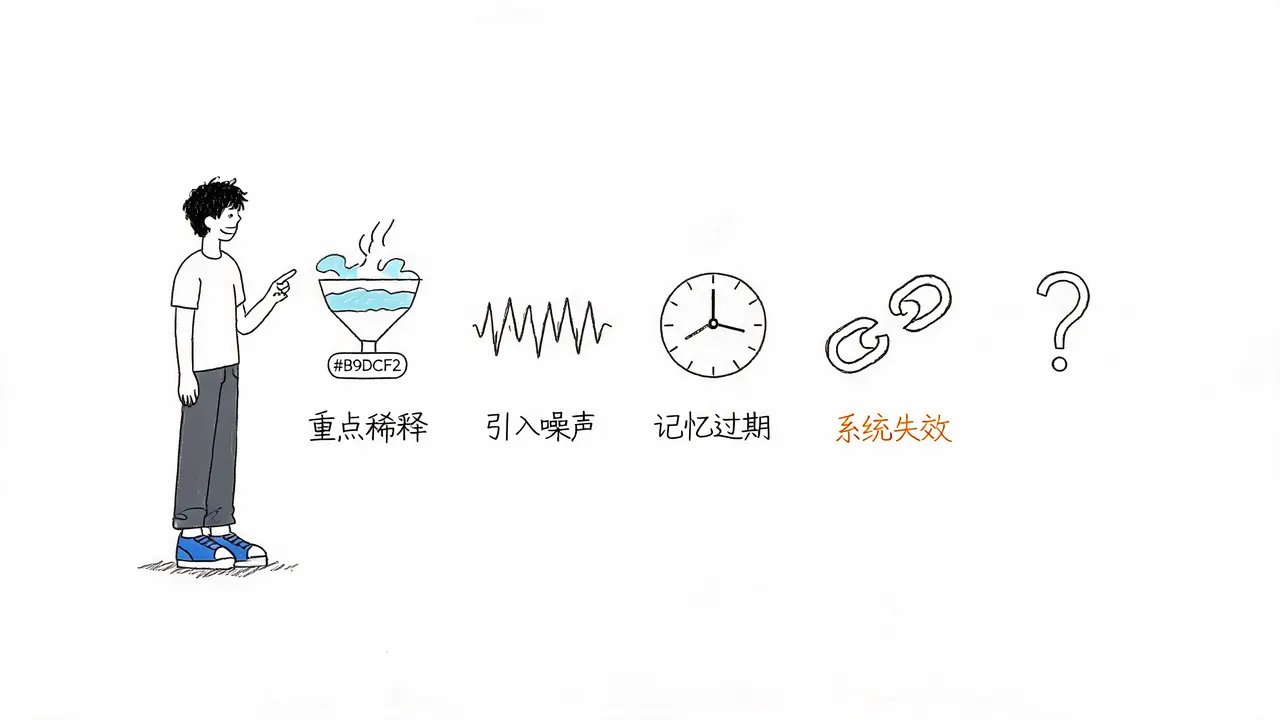
尽管上下文工程至关重要,但它并非万能药。在实际项目中,以下五个问题(“红灯”)经常导致系统失效:
- 上下文过长导致重点稀释:即使模型支持长上下文,过长的输入不仅增加成本和延迟,更会稀释关键信息,导致模型“迷失”在海量文本中。
- 检索引入噪声:RAG 检索到的内容看似相关,实则无用甚至误导,导致模型回答跑偏。
- 记忆过期:用户过去的偏好或状态可能已不再适用于当前任务。旧记忆有时比没有记忆更危险。
- 工具结果失败或混淆:接口超时、数据不全或连接断开时,模型若无法区分“工具真实返回”与“自身推测”,极易产生幻觉。
- 模型误读信息:即使信息放置正确,模型仍可能因理解能力限制而误读。因此,端到端评测(任务成功率、事实正确率、引用质量、格式稳定性、延迟与成本)才是最终的压舱石,而非仅看提示词写得是否漂亮。
两者的关系与面试应对
包含关系
最稳妥的说法是:提示词工程是上下文工程的一部分,但上下文工程远不止提示词。
- 上下文工程是一个大框,包含了 RAG 资料、历史记忆、工具结果、状态管理和评测反馈。
- 提示词工程只是其中的一个模块,负责指令的表达。
- 两者共同构建在大模型应用系统的底座之上。
三组核心对照
在面试或技术讨论中,可以通过以下三组对照清晰界定两者:
| 维度 | 提示词工程 | 上下文工程 |
|---|---|---|
| 关注范围 | 单次调用 | 多轮系统 |
| 核心问题 | 关心这一次怎么问 | 关心整个多轮系统里状态怎么流转 |
| 本质动作 | 指令表达(怎么说) | 信息编排(给什么) |
| 工作性质 | 写作 | 管理 |
总结
提示词工程依然是基本功,不应被贬低;但也不应将上下文工程吹捧为玄学新词。
- 提示词工程教模型听懂任务。
- 上下文工程决定模型能看见什么。
将信息供给当成正经工程来做,通过系统化的筛选、排序、压缩和更新,才能在有限资源下获得最稳定的 LLM 应用效果。